[논문리뷰] RISE: Recursive Improvement via Self-Extrapolating Policy Distillation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yang Li, Semih Yavuz, Shafiq Joty
1. Key Terms & Definitions (핵심 용어 및 정의)
- RLVR (Reinforcement Learning with Verifiable Rewards): 모델이 생성한 응답에 대해 객관적으로 검증 가능한 보상을 사용하여 정책을 학습하는 기법으로, 주로 sequence-level의 보상을 사용합니다.
- OPD (On-policy Distillation): teacher 모델이 제시하는 token-level 확률 분포를 student 모델이 추종하도록 유도하여 dense한 감독 신호를 제공하는 기법입니다.
- Self-Extrapolation: 모델의 학습 궤적(trajectory) 상에서 이전 체크포인트와 현재 체크포인트 간의 변위(displacement)를 외삽(extrapolate)하여 더 나은 성능을 낼 것으로 기대되는 미래의 teacher 모델을 합성하는 기법입니다.
- Task Arithmetic: 모델의 파라미터 공간에서 작업별 벡터를 연산(덧셈, 뺄셈 등)하여 모델의 성능을 조정하거나 조합하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 RLVR 및 OPD 방식이 겪는 근본적인 한계를 해결하고자 합니다. RLVR은 outcome reward만을 제공하여 token-level의 정교한 학습 신호가 부족하며, OPD는 적절한 teacher 모델의 부재로 인해 distribution mismatch 문제를 겪습니다 [Figure 1]. 외부 teacher 모델은 분포 불일치로 신뢰성이 떨어지며, 기존의 self-distillation 방식은 privileged conditioning의 한계로 인해 충분한 학습 이득을 얻지 못합니다. 저자들은 이러한 문제를 해결하기 위해, 모델 스스로가 학습 궤적을 통해 자신의 미래를 예측하고 이를 다시 학습에 활용하는 RISE 프레임워크를 제안합니다.
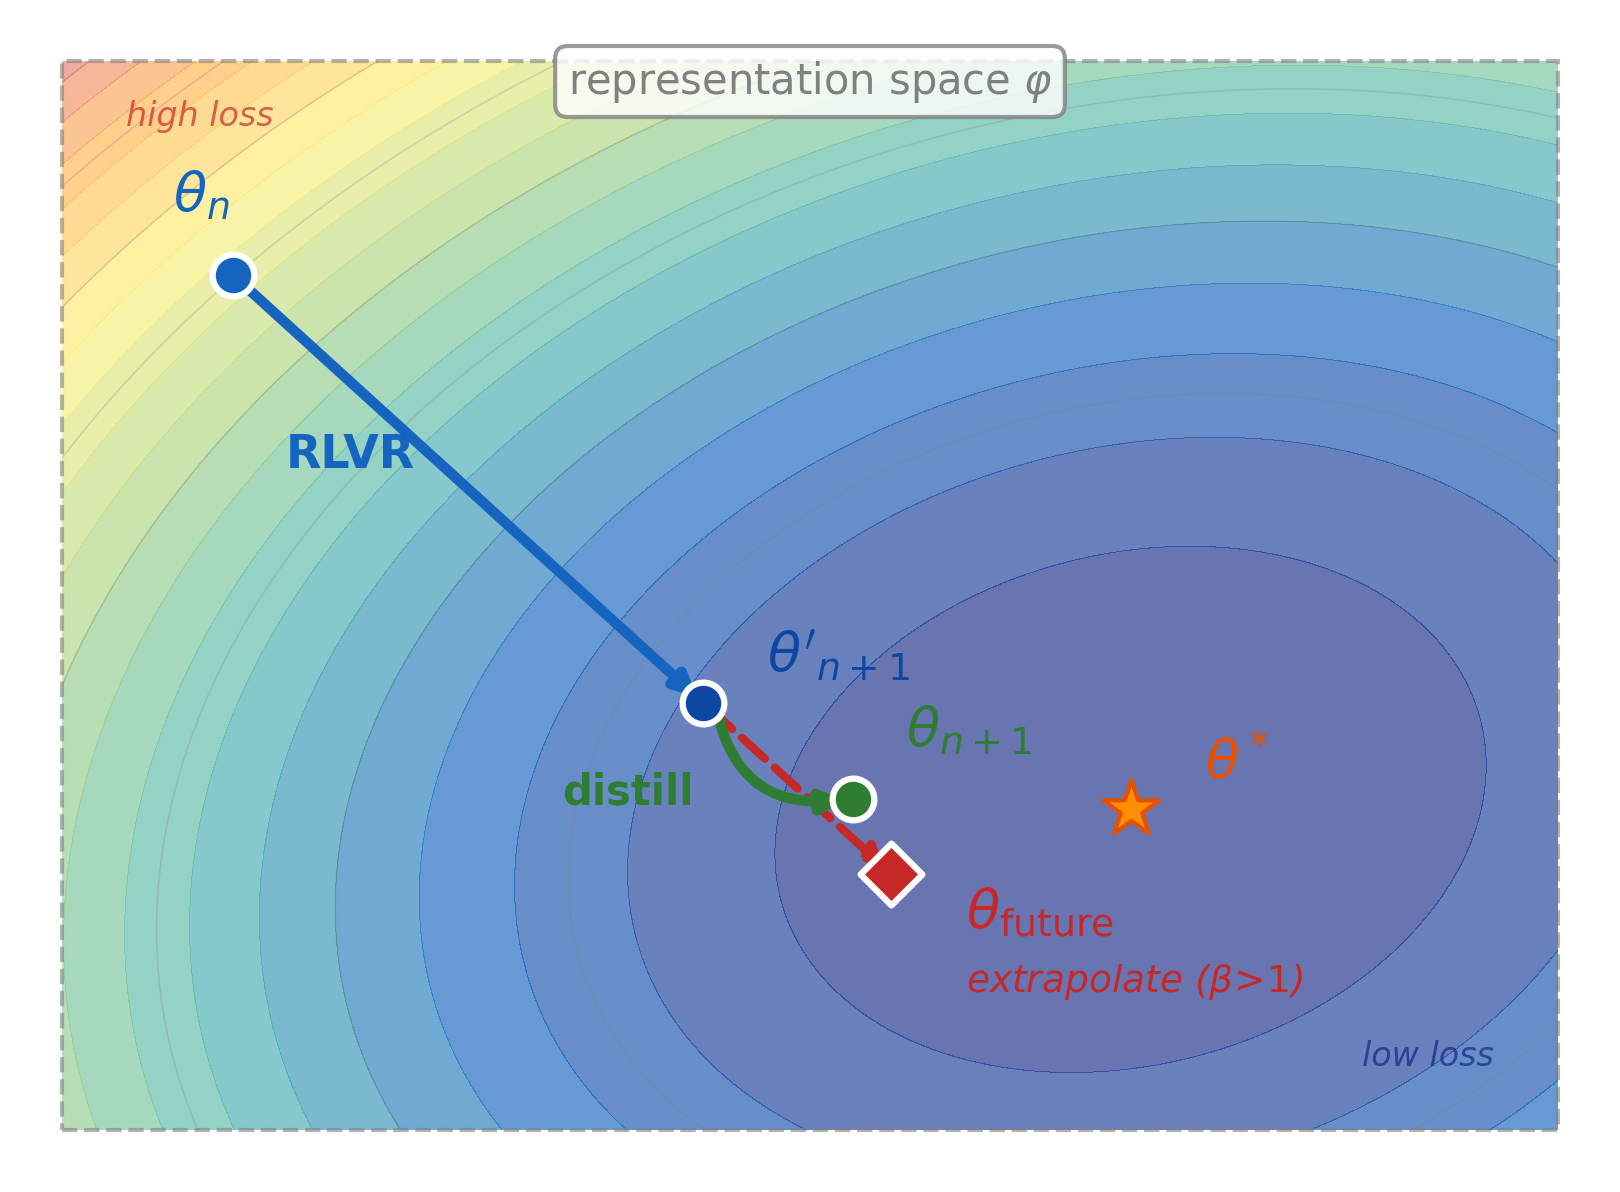
Figure 1 — 외삽 기하학 및 RISE 훈련 루프
3. Method & Key Results (제안 방법론 및 핵심 결과)
RISE는 RLVR로 얻은 파라미터 업데이트를 외삽하여 합성된 teacher를 생성하고, 이를 통해 student 모델을 OPD로 재학습하는 재귀적 개선 루프를 구현합니다 [Figure 1]. 저자들은 representation map $\varphi$를 정의하여 파라미터 공간(Weight-space)과 출력 로그 확률 공간(Logit-space) 양쪽에서 외삽을 수행하는 방식을 제안합니다. RLVR이 학습 방향의 정당성을 보장하면, OPD가 외삽된 teacher를 통해 token-level의 세밀한 교정을 수행하는 상호 보완적 구조를 가집니다. 실험 결과, RISE는 수학적 추론, STEM, 코드 생성 등 다양한 도메인에서 GRPO와 같은 기존 RLVR 베이스라인 및 기존의 self-distillation 기법들을 일관되게 능가하는 성능을 보였습니다. 특히 추가적인 샘플링 비용 없이도 성능 향상을 달성하며, 오직 1.3~1.6배 수준의 연산 오버헤드만으로 효율적인 학습이 가능함을 입증하였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 언어 모델이 외부의 도움 없이 자신의 학습 경로를 재귀적으로 외삽하여 스스로 성능을 개선할 수 있음을 입증했습니다. RISE는 teacher의 품질을 외적인 요소에 의존하지 않고 모델 내부의 학습 역학(learning dynamics)으로 해결함으로써, LLM self-improvement 분야의 중요한 돌파구를 제시합니다. 이 방식은 고비용의 인간 피드백 의존도를 낮추고 데이터 효율성을 극대화할 수 있어, 향후 자율적인 지능형 에이전트 학습 및 고성능 모델의 지속적 학습(Continual Learning) 프레임워크에 큰 시사점을 줄 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Trajectory-Refined Distillation
- [논문리뷰] CARDEA: Auditable Reasoning Grounded in Spatial Evidence for End-to-End Coronary Angiography Interpretation
- [논문리뷰] D^3-MOPD: Adaptive Dynamic Domain ScheDuling for Efficient Multi-Teacher Distillation
- [논문리뷰] On-policy Distillation with Verifiable Reward
- [논문리뷰] SkillGate: Training In-Policy Skill Selection in Long-Horizon Agents
Review 의 다른글
- 이전글 [논문리뷰] One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing
- 현재글 : [논문리뷰] RISE: Recursive Improvement via Self-Extrapolating Policy Distillation
- 다음글 [논문리뷰] Refuse without Refusal: A Structural Analysis of Safety-Tuning Responses for Reducing False Refusals in Language Models
댓글