[논문리뷰] Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal
링크: 논문 PDF로 바로 열기
메타데이터
저자: Alejo López-Ávila, Iker García-Ferrero, Jezabel Garcia, Antonio Tiene, Román Orús
1. Key Terms & Definitions (핵심 용어 및 정의)
- Narrow-boundary safety: 특정 주제 전체를 거부하는 대신, 배포 정책에 따라 유해한 하위 집합(Subset)만을 선별적으로 거부하고 유익한 나머지 질문은 답변하도록 하는 안전 정렬 개념입니다.
- Coverage Gap: 자기 생성(Self-generated) 데이터 생성 과정에서 유해 질문에 대한 거부 트레이스(Refusal trace)가 성공적으로 생성되지 않아 학습 데이터에서 탈락하는 현상을 의미합니다.
- Over-refusal: 모델이 안전을 위해 유해하지 않은 질문(Benign prompt)까지 과도하게 거부하여 유용성을 저해하는 현상입니다.
- Boundary-Aware Data: 유해한 질문(Harmful)과 그에 대응하는 유익한 질문(Benign)의 쌍으로 구성된 데이터로, 모델이 거부 경계(Refusal boundary)를 정밀하게 학습하도록 돕습니다 [Figure 1].
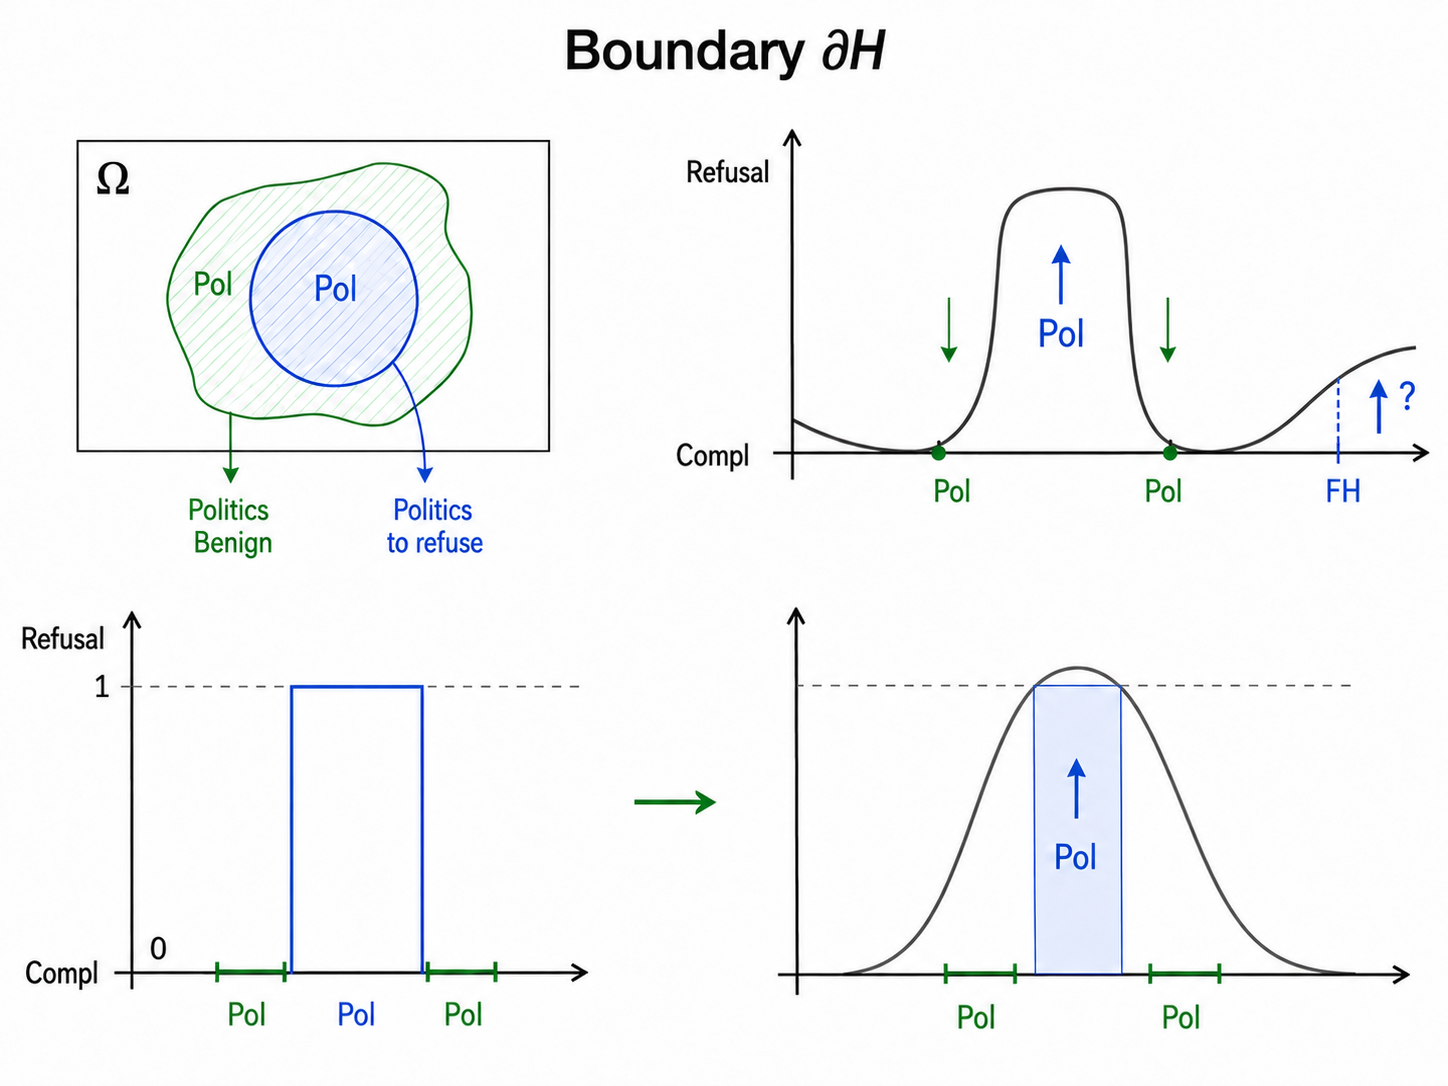
Figure 1 — 거부 경계 개념도
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존의 LLM 안전 정렬 방식이 주제 전체를 포괄적으로 거부하는 '블런트(Blunt)한 방식'으로 작동하여, 실제 배포 환경에서 필요한 세밀한 안전 정책을 반영하지 못하는 문제를 해결합니다. 많은 연구가 일반적인 유해성 분류(Taxonomy)에 의존하지만, 교육용이나 공공 서비스 등 특정 도메인에서는 정치적 정보와 같은 주제 내에서도 유해한 조작과 유익한 사실 관계를 구분해야 합니다 [Figure 1]. 저자들은 기존의 자기 생성 안전 정렬 기법이 데이터 생성 과정에서 19.88%에 달하는 커버리지 격차를 발생시키며, 이를 단순 삭제할 경우 학습 데이터의 품질이 저하되는 한계를 지적합니다 [Figure 2]. 또한, 단순한 유해성 완화가 모델을 과도한 거부 머신으로 만들어 유용성을 훼손하는 문제를 심각하게 다룹니다.
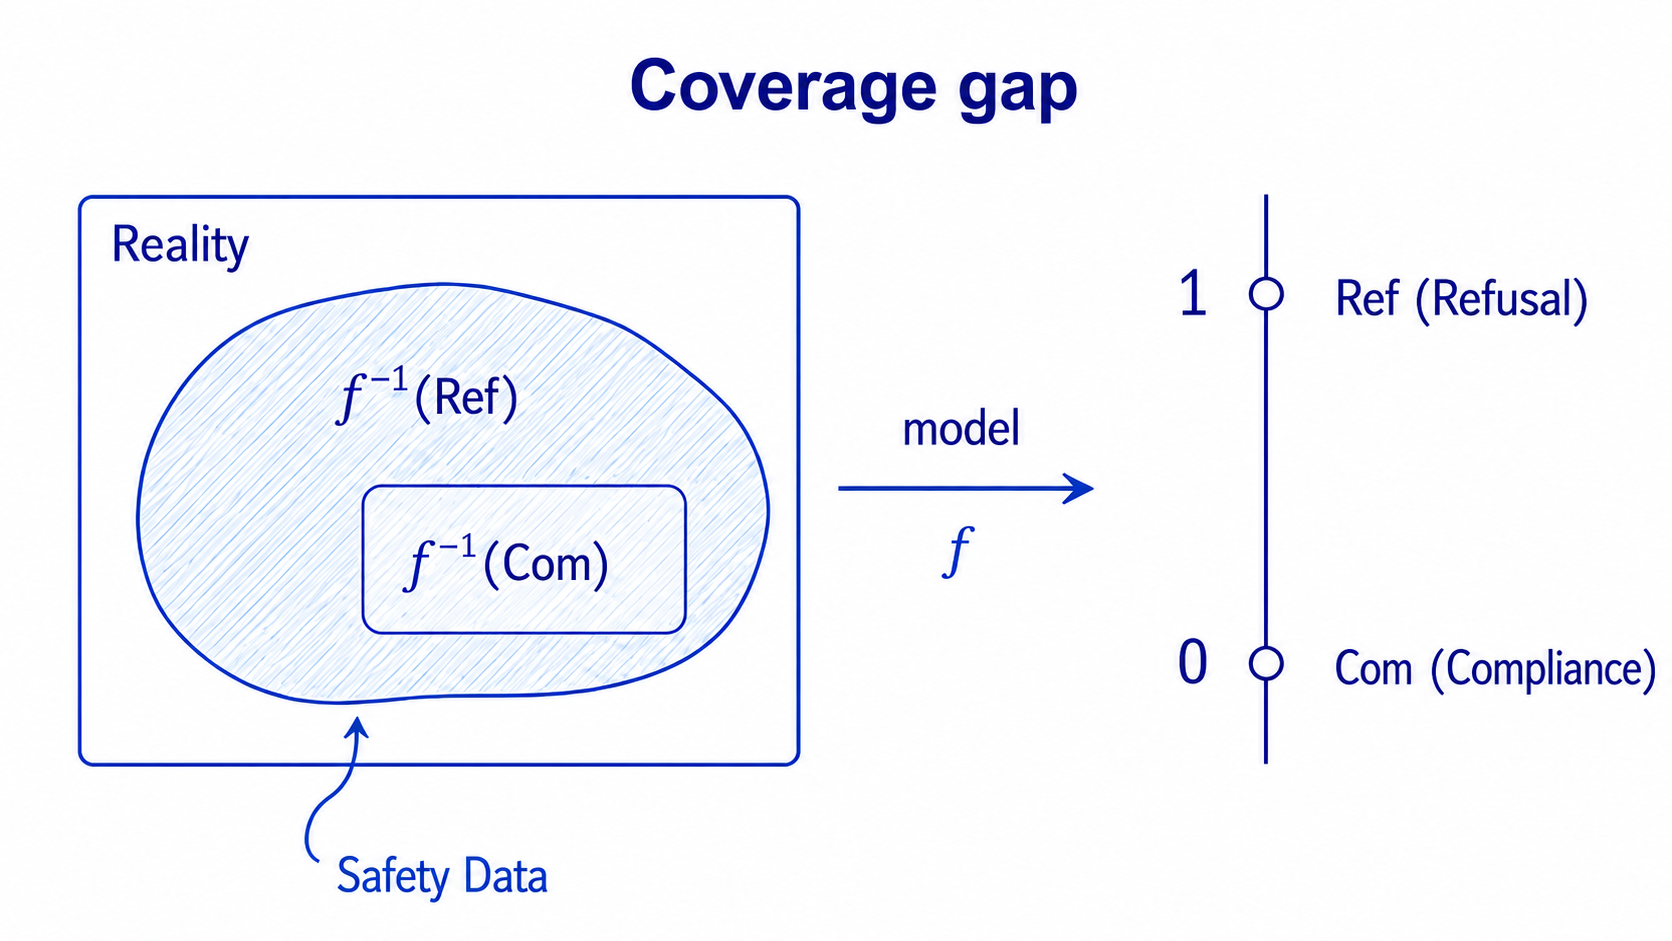
Figure 2 — 자기 생성 데이터의 커버리지 격차
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Hierarchical Generation을 통해 데이터의 페르소나, 길이, 스타일을 제어하고, 거부 트레이스 생성 실패를 방지하는 Coverage-oriented 데이터 파이프라인을 제안합니다. 특히, Escalate 기법을 통해 실패한 프롬프트를 재시도하여 커버리지 격차를 기존 19.88%에서 0.20%까지 줄였습니다. Boundary-aware 학습을 위해 유해-유익(Harmful-benign) 쌍을 생성하여 모델이 경계 영역을 정밀하게 학습하도록 설계했습니다 [Figure 1]. 주요 결과로, 정치 도메인에서 Qwen3-8B 모델을 학습시킨 결과, 목표 도메인 거부율은 9.47%에서 84.75%로 대폭 향상되었으며, 전체 유해 응답률은 26.26%에서 0.14%로 감소했습니다. 또한, 외부 응답 대신 검증된 모델 자체 응답을 사용하여 XSTest 기준 과잉 거부율을 15.20%에서 5.20%로 낮추는 성과를 거두었습니다 [Figure 4]. Boundary 데이터는 거부 경계에서의 정밀도를 높여, 유익한 질문에 대한 과잉 거부율을 32.94%에서 4.16%까지 성공적으로 감소시켰습니다 [Figure 6].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 LLM의 안전 정렬이 단순한 주제 단위의 거부가 아닌, 도메인 특화 경계를 고려한 정밀한 제어 방향으로 나아가야 함을 제시합니다. 연구 결과는 안전성(Safety)과 유용성(Utility) 사이의 트레이드오프를 데이터 구성을 통해 효과적으로 조절할 수 있음을 입증하며, 안전 정렬의 평가 지표가 과잉 거부 현상까지 종합적으로 고려해야 함을 시사합니다. 제안된 프레임워크는 실제 산업 현장에서 모델의 유연한 안전 정책 구현에 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Refuse without Refusal: A Structural Analysis of Safety-Tuning Responses for Reducing False Refusals in Language Models
- [논문리뷰] PaperGym: Rubric-Centered Evolution for Research-Plan Generation
- [논문리뷰] DART-SD: Diamond-topology Aware Retrieval and Tuning for Self-Distillation of Multi-Turn Tool-Calling Agents
- [논문리뷰] iFAN: Inference-Aware Learning for Plain Mask Transformers
- [논문리뷰] When Privileged Guidance Misaligns: State-Matched Routing and Contextualized Self-Distillation for Multi-Turn Agents
Review 의 다른글
- 이전글 [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- 현재글 : [논문리뷰] Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal
- 다음글 [논문리뷰] Unifying Conformal Language Tasks with In-Context Ensembles
댓글