[논문리뷰] FreeFlow: A Bias-free Hierarchical Transformer for Optical Flow Estimation
링크: 논문 PDF로 바로 열기
저자: Vladislav Bargatin, Alexander Yakovenko, Khaled Abud, Dmitriy Vatolin
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 기술적 개념은 다음과 같습니다.
- Optical Flow: 연속적인 이미지 시퀀스 내에서 각 픽셀의 움직임을 나타내는 조밀한 픽셀 단위 모션 벡터입니다.
- Inductive Biases: 특정 태스크(예: Optical Flow)의 특성을 모델에 반영하기 위해 설계된 아키텍처적 선험 지식 또는 가정으로, Correlation Volume, Feature Warping, Iterative Refinement 등이 대표적입니다.
- Hierarchical Transformer: 다양한 공간 스케일에서 정보를 처리하기 위해 Window Attention, Shifted-Window Attention, Global Attention과 같은 여러 Attention 메커니즘을 계층적으로 결합한 Transformer 아키텍처입니다.
- Endpoint Error (EPE): 예측된 Optical Flow 벡터와 Ground-Truth Flow 벡터 간의 평균 Euclidean Distance를 측정하는 지표로, 수치가 낮을수록 성능이 우수합니다.
- 1-pixel outlier rate (1px): 예측된 Flow 벡터와 Ground-Truth Flow 벡터 간의 Euclidean Distance가 1픽셀을 초과하는 픽셀의 비율을 나타내는 지표로, 수치가 낮을수록 성능이 우수합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Optical Flow 추정 방법들은 Correlation Volume, Feature Warping, Iterative Refinement와 같은 태스크 고유의 Inductive Biases에 크게 의존해왔습니다. 이러한 Biases는 높은 정확도를 달성하는 데 효과적이지만, 모델의 표현력을 제한하고 파이프라인을 복잡하게 만들며 추가적인 계산 비용을 발생시키는 한계점을 가집니다. 일반적인 컴퓨터 비전 분야에서는 Vision Transformers가 Detection, Segmentation, Depth Prediction 등에서 특화된 파이프라인을 대체하며 데이터 기반의 범용 Feed-Forward 모델이 확장성과 Supervision을 통해 필요한 구조를 학습할 수 있음을 입증했습니다. 그러나 Optical Flow 분야의 기존 Transformer 기반 접근 방식들은 여전히 Warping 기반 업데이트나 Inference-Time Tiling 등 일부 Flow-Specific 구조를 유지하거나, 고해상도 처리에서 정확도를 저해하는 실용적 제약을 가집니다. 저자들은 고해상도에서 정확한 Flow 추정을 위해 미세한 구조와 모션 경계를 보존하는 강력한 Local Reasoning과 큰 변위를 해결하는 효과적인 Long-Range Information Flow를 동시에 요구하는 문제에 직면했습니다. 이 연구는 이러한 한계점을 극복하고, Flow-Specific Biases 없이도 고성능 Optical Flow 추정이 가능한 범용 아키텍처의 필요성에서 출발합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 기존의 Flow-Specific Inductive Biases 없이 Optical Flow를 추정하는 Bias-free Hierarchical Transformer인 FreeFlow를 제안합니다. FreeFlow는 단일 Feed-Forward Encoder-Decoder 아키텍처를 사용하여 End-to-End 방식으로 학습되며, Optical Flow 추정을 위한 특화된 모듈(예: Correlation Volume, Warping 기반 업데이트 파이프라인, 특수 Upsampling)을 사용하지 않습니다. 입력 이미지 쌍 (I1, I2)는 각각 8x8 Patch 토큰으로 Embedding되고, Siamese Transformer Encoder를 통해 Feature Representation F1과 F2를 추출합니다. 이후 Transformer Decoder는 Self-Attention과 Cross-Attention을 결합하여 Flow 토큰 Z를 생성하고, 이를 경량 Flow Head를 통해 밀집된 Optical Flow Field로 매핑합니다.
FreeFlow는 고해상도 처리를 위해 세 가지 Attention Variant를 활용하는 계층적 Attention 디자인을 채택합니다.
- Window (Win) Attention Block: 4x4 파티션 내에서 독립적으로 Attention을 계산하여 Local Detail을 처리합니다.
- Shifted-Window (Swin) Attention Block: Half-Window Offset을 적용하여 Window 경계를 넘어 Cross-Window Information Exchange를 가능하게 합니다.
- Global Attention Block: 2x2로 Downsampling된 해상도에서 Full Attention을 적용한 후 Upsampling하여 Global Context를 효율적으로 통합합니다. 각 Encoder/Decoder 레이어는 Win, Swin, Global Attention 블록을 고정된 순서로 적용하며, Attention Cost를 균형 있게 유지하여 고해상도에서도 효율적인 처리가 가능합니다. 모델은 Cross-View Completion 태스크로 Pre-Train된 후, Optical Flow Fine-Tuning 단계에서 Mixture-of-Laplace Loss를 사용하여 학습됩니다.
실험 결과, FreeFlow는 주요 Optical Flow 벤치마크에서 State-of-the-Art 성능을 달성했습니다.
- Spring 벤치마크: FreeFlow-L 모델은 EPE에서 0.278, Fl에서 1.048을 기록하여 모든 비교 방법 중 가장 우수한 성능을 보였고, 1px에서는 3.192, WAUC에서는 95.235로 강력한 Baseline들과 동등하거나 그 이상의 성능을 나타냈습니다. 특히 WAFT-DAv2-a2 대비 EPE를 9% 개선하고 Fl을 14% 감소시켰습니다. 또한, FreeFlow는 1080p Inference 시 낮은 메모리 사용량(2.58 GB for FreeFlow-L)을 유지하면서도 뛰어난 정확도를 제공합니다. 이러한 성능은 정확도-메모리 Scatter Plot 및 정성적 비교에서 확인됩니다 [Figure 1].
- Sintel 벤치마크: FreeFlow-L은 Clean Split에서 0.68 EPE, Final Split에서 1.48 EPE를 달성하며 1위를 차지했습니다. GeoViT 대비 Clean EPE를 14% (0.79 → 0.68) 개선했으며, VideoFlow-MOF 대비 Final EPE를 10% (1.65 → 1.48) 개선했습니다.
- KITTI-2015 벤치마크: FreeFlow-L은 3.23 Fl-all을 기록하여 Non-Stereo 및 Non-Multiframe 방법 중 최고 성능을 달성했습니다. 정성적 비교에서도 FreeFlow는 복잡한 모션 패턴을 효과적으로 포착하며 높은 디테일과 Global Motion Consistency를 보여줍니다 [Figure 5, 6].
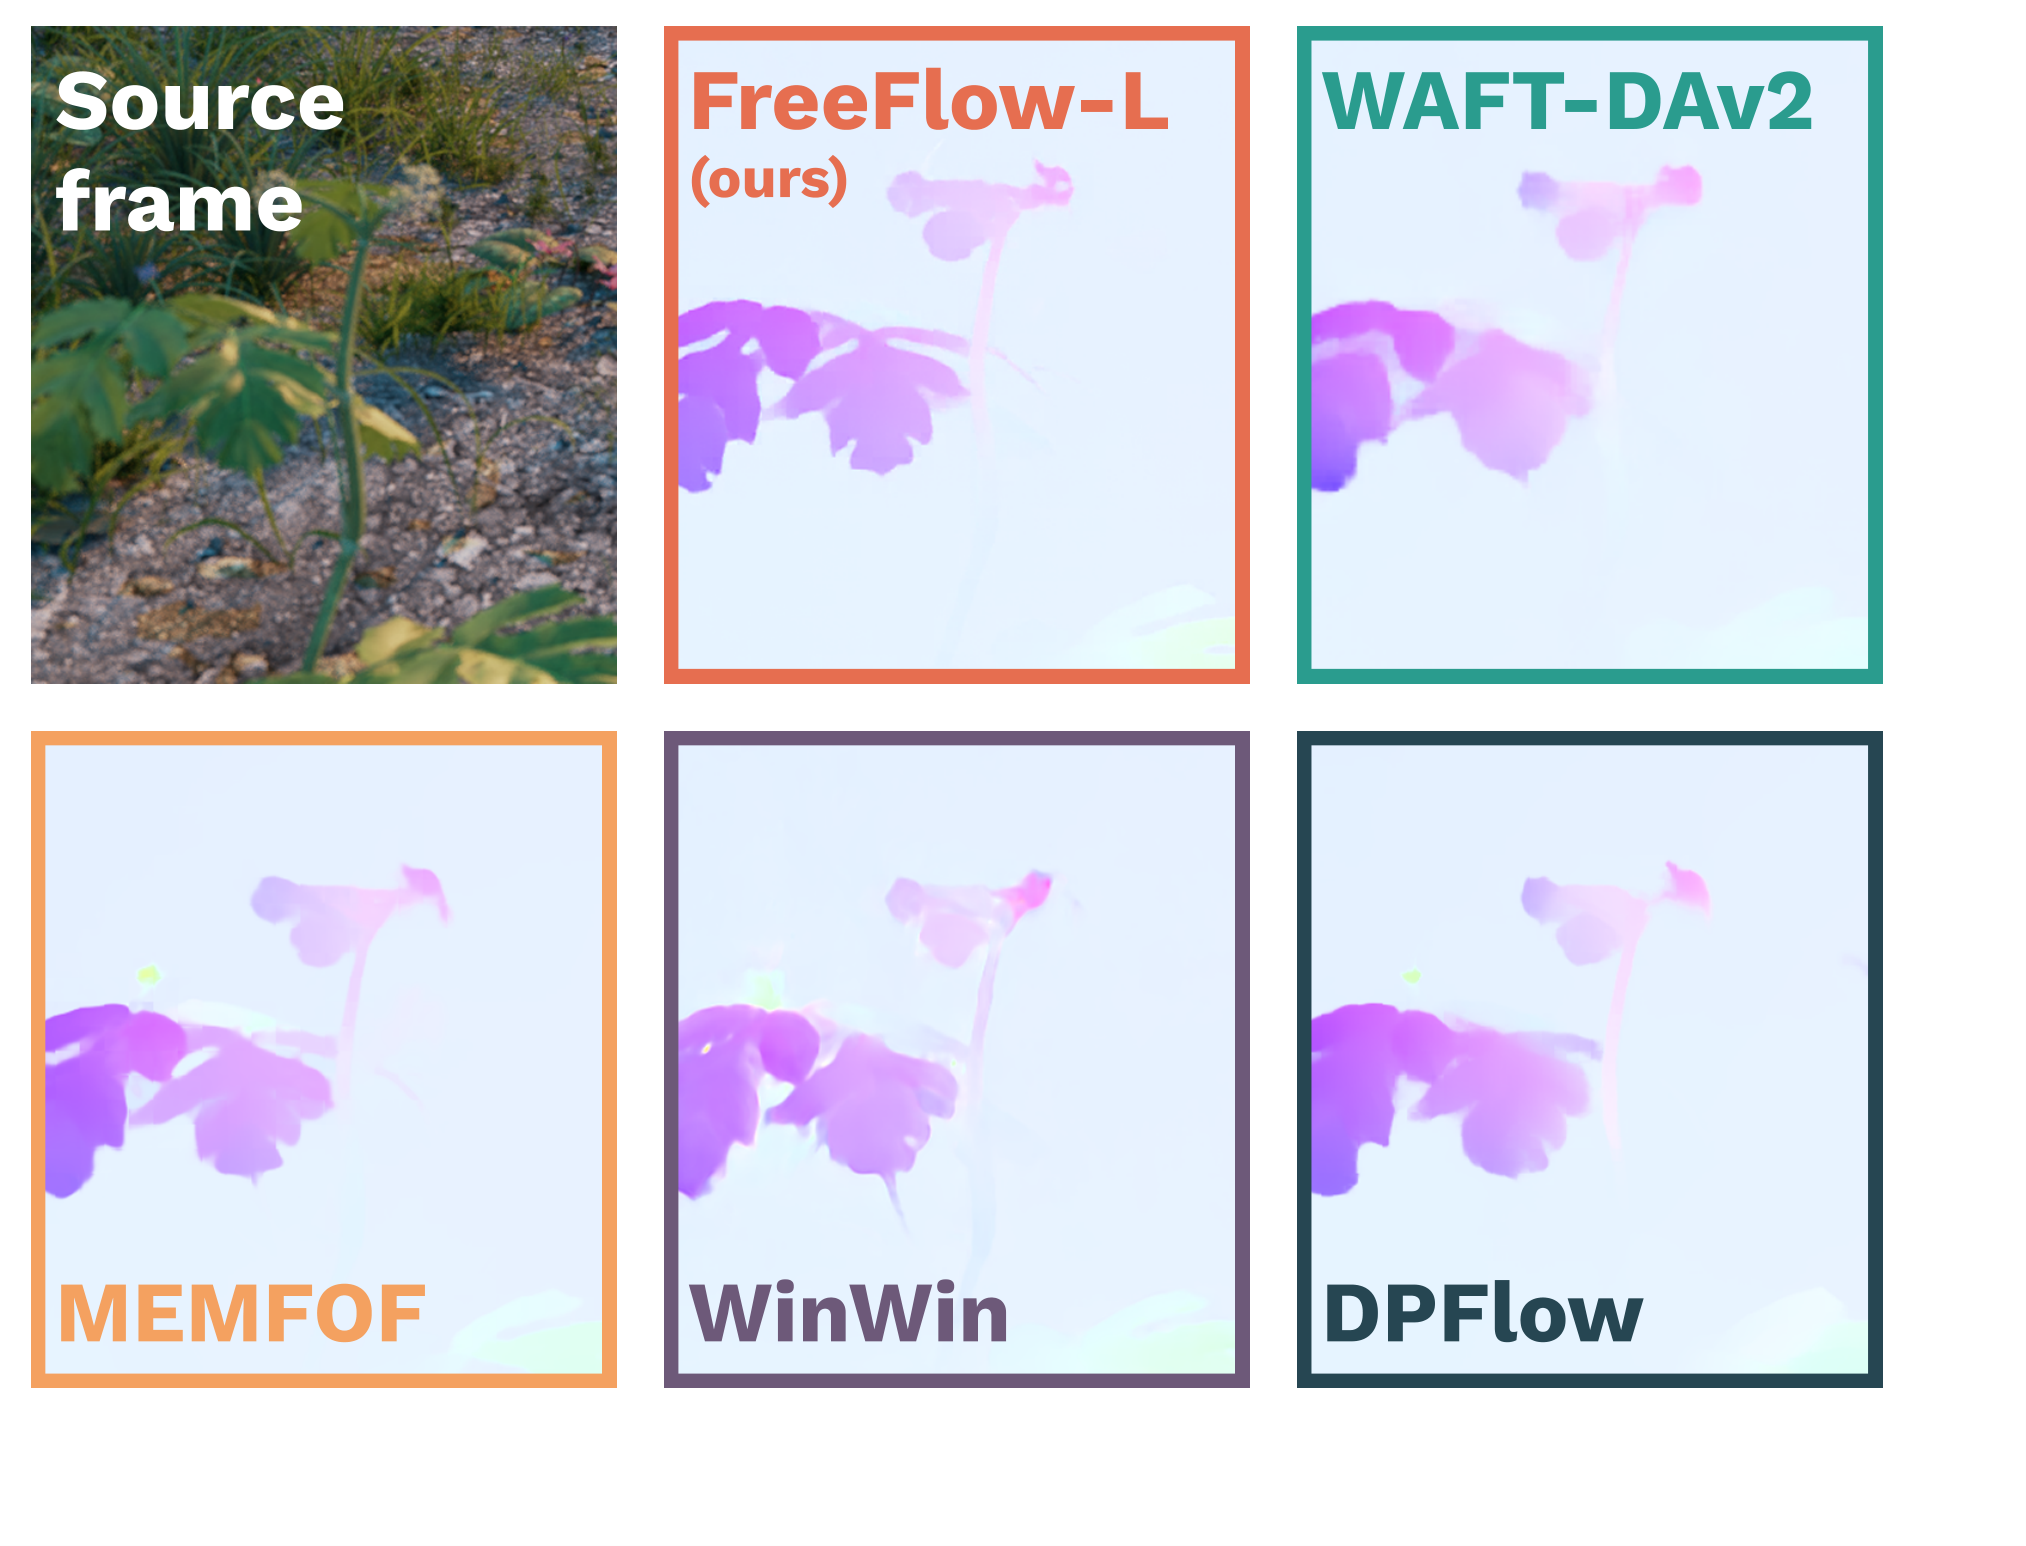
Figure 1 — FreeFlow 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Correlation Volume, Feature Warping, Iterative Refinement와 같은 전통적인 Optical Flow-Specific 디자인 요소를 제거한 Bias-free Hierarchical Transformer인 FreeFlow를 성공적으로 제안했습니다. FreeFlow는 Window Attention, Shifted-Window Attention, 그리고 Reduced-Resolution Global Attention을 결합한 단순한 Feed-Forward Encoder-Decoder 아키텍처를 통해 다양한 공간 스케일의 모션을 효과적으로 포착합니다. 이러한 디자인은 모델 용량에 따라 꾸준히 성능이 향상되는 유연하고 확장 가능한 프레임워크를 제공하며, 고해상도 Inference에서도 효율성을 유지합니다. FreeFlow의 State-of-the-Art 성능은 Sintel, KITTI-2015, Spring 등 모든 주요 벤치마크에서 입증되었으며, 이는 특화된 Flow 모듈 없이도 범용 Transformer 아키텍처가 강력한 모션 추정 능력을 가질 수 있음을 시사합니다. 이 연구는 Optical Flow 분야에서 오랫동안 의존해온 도메인 특화 Inductive Biases에 대한 근본적인 질문을 던지며, 모션 추정 및 관련 Dense Correspondence 태스크를 위한 더 간단하고 범용적인 아키텍처 탐구를 장려할 것으로 기대됩니다.
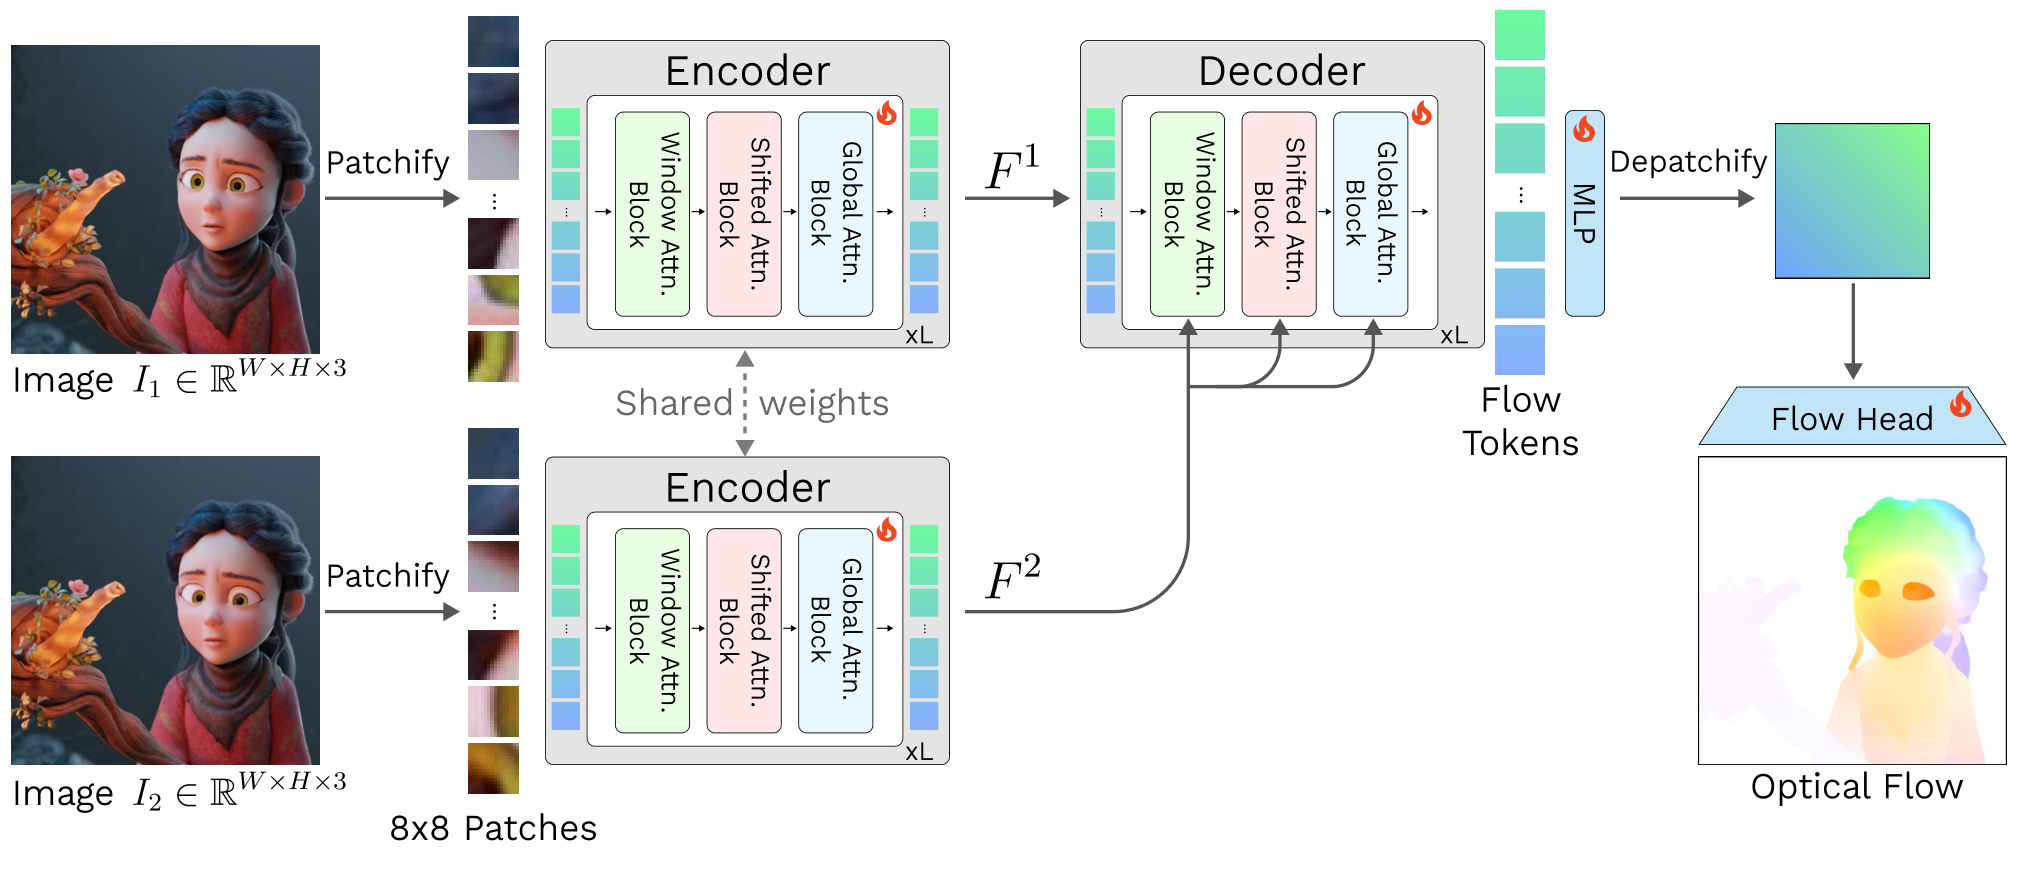
Figure 3 — 제안 방법론 개요
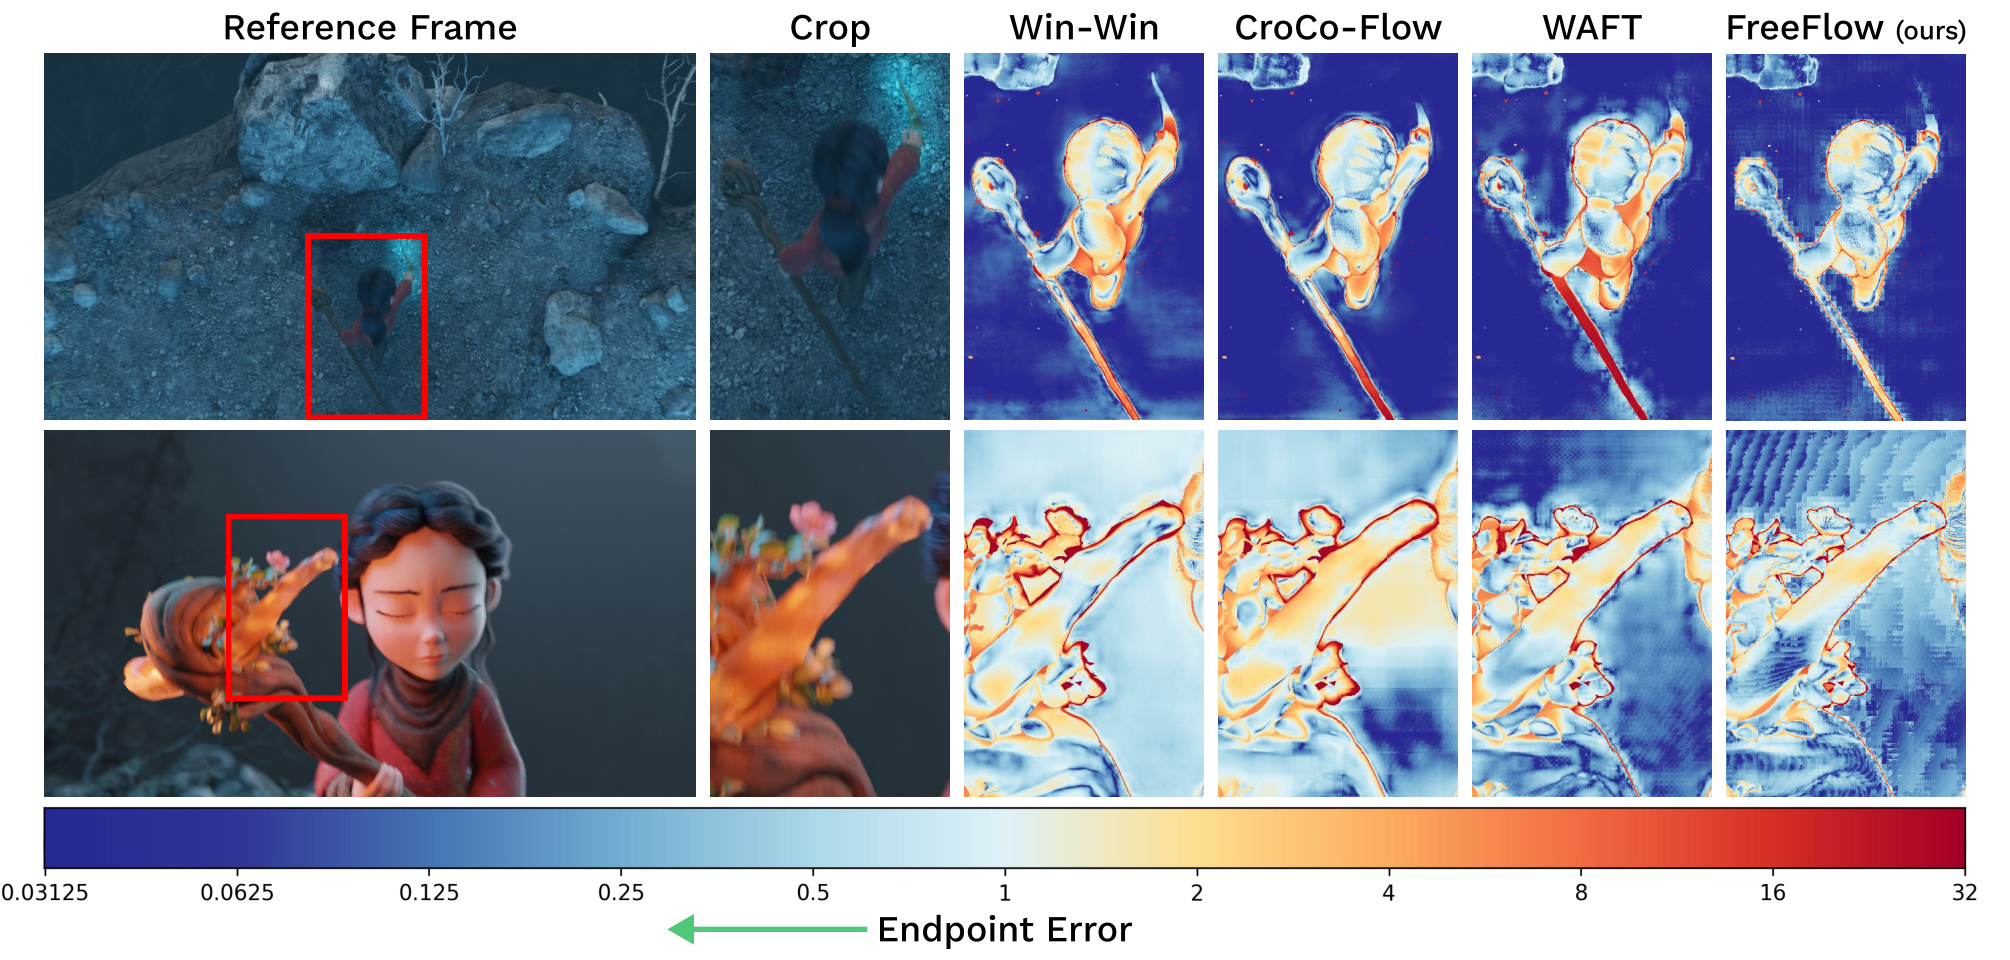
Figure 5 — Spring 벤치마크 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] From RGB Generation to Dense Field Readout: Pixel-Space Dense Prediction with Text-to-Image Models
- [논문리뷰] Phase Marginalization for Patch-Grid Instability in Vision Transformers
- [논문리뷰] Pushing the Limits of High-Resolution Weather Forecasting through Data Scaling
- [논문리뷰] Hand Visibility Detector: Per-Keypoint Visibility Estimation for Hands
- [논문리뷰] Vision as Unified Multimodal Generation
Review 의 다른글
- 이전글 [논문리뷰] EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents
- 현재글 : [논문리뷰] FreeFlow: A Bias-free Hierarchical Transformer for Optical Flow Estimation
- 다음글 [논문리뷰] Generative Late-Interaction Embeddings For Visual Document Retrieval
댓글