[논문리뷰] StepAudio 3 Music Technical Report
링크: 논문 PDF로 바로 열기
저자: Chengli Feng, Zhiyue Wu, Jiahao Song, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- StepAudio Music Tokenizer: 오디오를 50-Hz 스트림의 65536-entry 단일 codebook 토큰으로 변환하는 구성 요소로, semantically informed self-supervised 및 multi-task training을 통해 음악 구조와 재구성 관련 정보를 보존한다.
- Flow-Matching Diffusion Transformer (DiT): StepAudio VAE latents를 예측하고 이를 48-kHz 오디오로 디코딩하여 고품질 음향 렌더링을 담당하는 diffusion Transformer 모델이다.
- ABC Notation (ABC-CoT): 음악의 하모니, 리듬, 멜로디 구조를 표현하는 중간 어레인지먼트 플랜으로, Large Language Model (LLM)이 음악 토큰 생성 전에 이 플랜을 활용하여 명시적인 음악 계획을 가능하게 한다.
- Single-Codebook Vector Quantization (VQ): 음악 토크나이저의 discrete bottleneck 디자인 중 하나로, 하나의 토큰 스트림만을 예측하여 autoregressive 모델의 안정적인 음악 개발에 유리하다.
- Direct Preference Optimization (DPO): 전문가의 청취 선호도에 모델의 출력을 정렬시키기 위해 사용되는 강화 학습 기법으로, Supervised Fine-Tuning (SFT) 이후 적용되어 최종 모델의 품질을 향상시킨다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 대규모, 장시간 음악 생성 모델의 발전을 목표로 한다. 기존 음악 생성 모델들은 음향 품질과 길이 면에서 상당한 발전을 이루었지만, 멜로디 전개, 섹션 전환, 가사와 음악 간의 관계 등 장기적인 음악 구조를 조율하는 데 한계가 있었다. 특히, 기존 방식은 전체 오디오 생성 과정에서 명시적인 음악적 계획(explicit musical planning)을 통합하는 데 어려움을 겪었으며, 이는 사용자가 창의적인 결정을 검토하고 수정하기 어렵게 만들었다. 저자들은 음악 생성의 제어 가능성(controllability)과 해석 가능성(interpretability)을 향상시키기 위해, 모델의 중간 계획이 명확한 음악적 의미론과 시간적 구조를 노출하여 창작자가 오디오 생성 전에 어레인지먼트 결정을 검사하고 수정할 수 있도록 해야 할 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 StepAudio 3 Music이라는 대규모, 장시간 음악 생성 모델을 제안하며, 이는 명시적인 음악 계획과 개방형 텍스트 제어 생성을 지원한다 [Figure 2]. 이 시스템은 generation-oriented music tokenizer, Mixture-of-Experts (MoE) autoregressive model, 그리고 flow-matching DiT renderer를 결합한다. StepAudio Music Tokenizer는 오디오를 50-Hz 스트림의 65536-entry 단일 codebook으로 표현하며, semantically informed self-supervised 및 multi-task training을 통해 음악 구조와 재구성 관련 정보를 보존한다. Flow-matching DiT는 continuous StepAudio VAE latents를 예측하고, VAE decoder는 이를 48-kHz waveform audio로 변환한다. Discrete bottleneck 디자인 연구에서는 Single-codebook VQ가 Semantic RVQ나 Acoustic RVQ보다 autoregressive 모델의 안정적인 음악 개발에 더 적합함을 발견했다 [Figure 3, cite: 1].
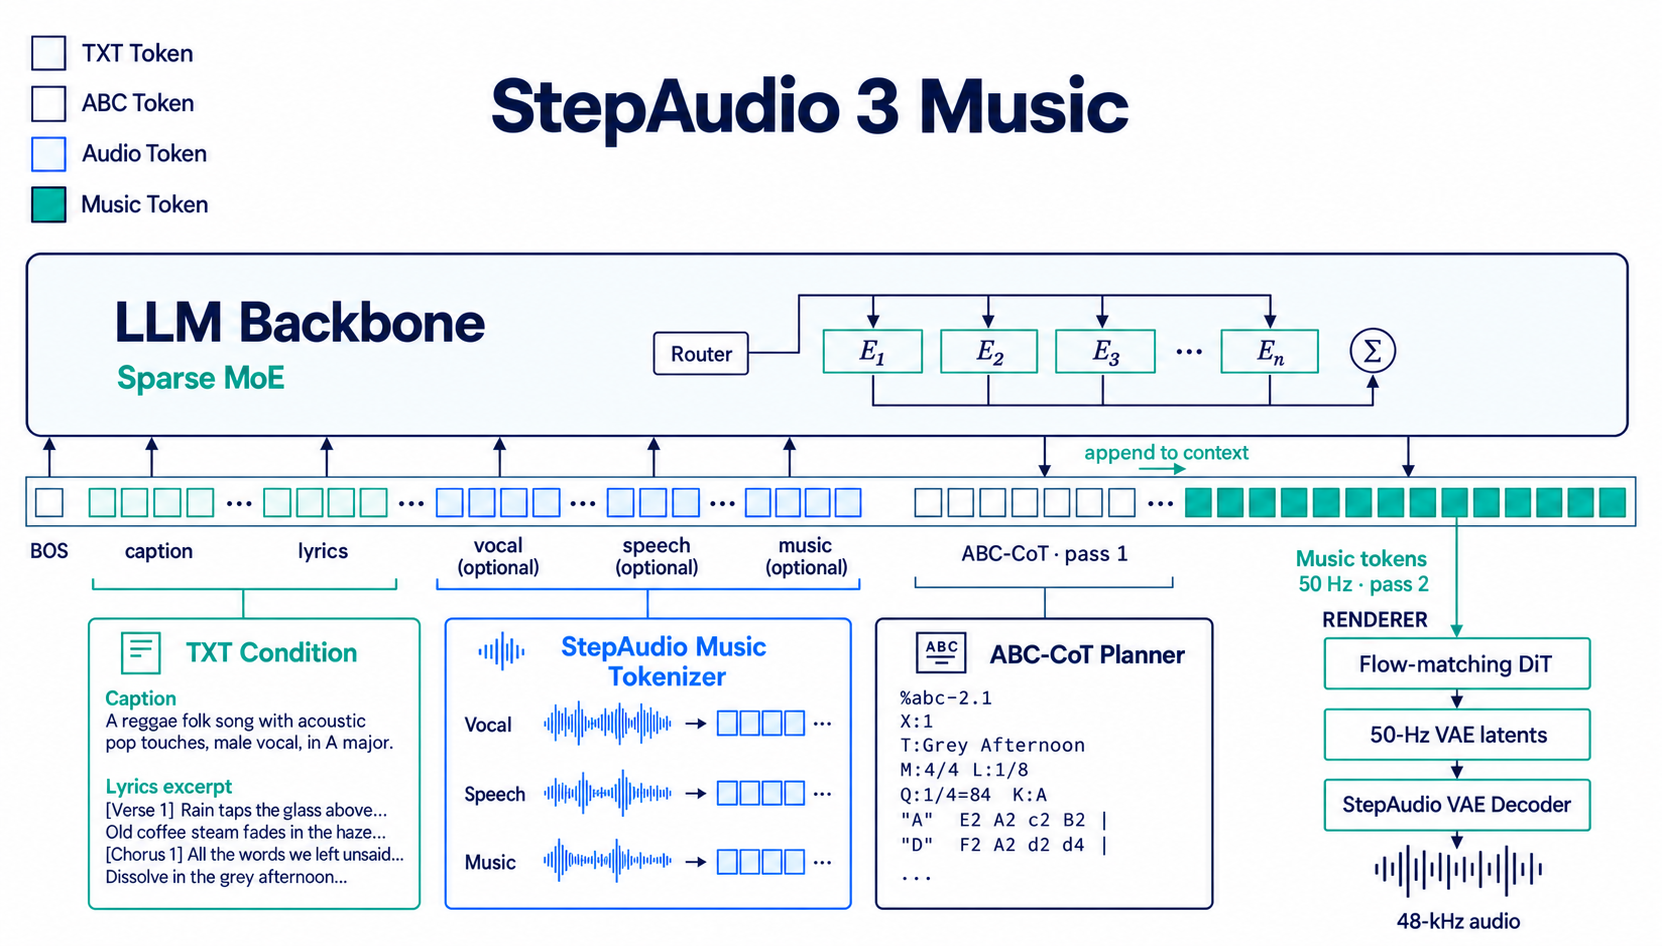
Figure 2 — 모델 전체 아키텍처
명시적인 음악 계획을 위해, MoE 모델은 ABC notation을 사용하여 ABC-CoT (arrangement plan)를 먼저 생성한 후, 이를 조건으로 음악 토큰을 예측한다. 이 접근 방식은 하모니, 리듬, 멜로디, 형식에 대한 시간적으로 구조화된 컨텍스트를 제공하여 창작자가 오디오 합성 전에 어레인지먼트 결정을 검사하고 수정할 수 있도록 한다. 모델은 lyrics-to-music generation, cover-song generation, vocal-to-mix generation을 포함하는 progressive, multi-task training curriculum을 따른다. Supervised Fine-Tuning (SFT) 및 Direct Preference Optimization (DPO)을 통해 모델은 전문가의 청취 선호도에 맞춰 정렬된다.
평가 결과, StepAudio 3 Music은 AudioBox-Aesthetics의 Content Enjoyment (7.7086), Content Usefulness (8.0052), Production Quality (8.3868) 점수에서 가장 높은 성능을 달성했다. 또한, MuQ-MuLan similarity도 0.4465로 가장 높았으며, SongBench 결과에서도 경쟁력을 보였다 [Figure 1, cite: 1]. Ablation study에서는 DPO가 SongBench Musicality (5.7465로 상승), AudioBox Content Enjoyment (7.7086로 상승), Production Quality (8.3868로 상승), MuQ-MuLan similarity (0.4465로 상승) 등 모든 지표에서 SFT 모델 대비 성능 향상을 이끌어냈다. ABC-CoT는 모든 SongBench 차원 점수를 향상시켰으며, 특히 LLM-based plan editing을 적용했을 때 평균 점수가 0.0781 더 상승하여 Mixing (+0.1199), Arrangement (+0.1089), Melody (+0.1060) 등에서 가장 큰 개선을 보였다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 명시적인 음악 계획과 개방형 텍스트 제어 생성을 지원하는 대규모, 장시간 음악 생성 모델인 StepAudio 3 Music을 성공적으로 제안하였다. 이 시스템은 predictable한 음악 토큰 표현, MoE autoregressive 모델, 그리고 continuous acoustic renderer를 결합하여 텍스트, ABC notation, 그리고 task-specific references를 통한 보완적인 형태의 제어 기능을 제공한다. ABC-CoT를 통한 중간 어레인지먼트 계획은 음악 구조 제어의 새로운 패러다임을 제시하며, DPO를 통한 전문가 선호도 정렬은 생성 음악의 품질을 크게 향상시켰다. 이 연구는 음악 생성 분야에서 제어 가능성, 해석 가능성, 그리고 고품질 오디오 합성의 가능성을 확장하여, 창작자들이 보다 정교하게 음악을 제작할 수 있는 도구를 제공한다. 향후 연구는 복잡한 어레인지먼트, 장기적인 temporal dependencies, 보컬 자연스러움, 그리고 고주파 재구성 개선에 초점을 맞출 것이다.
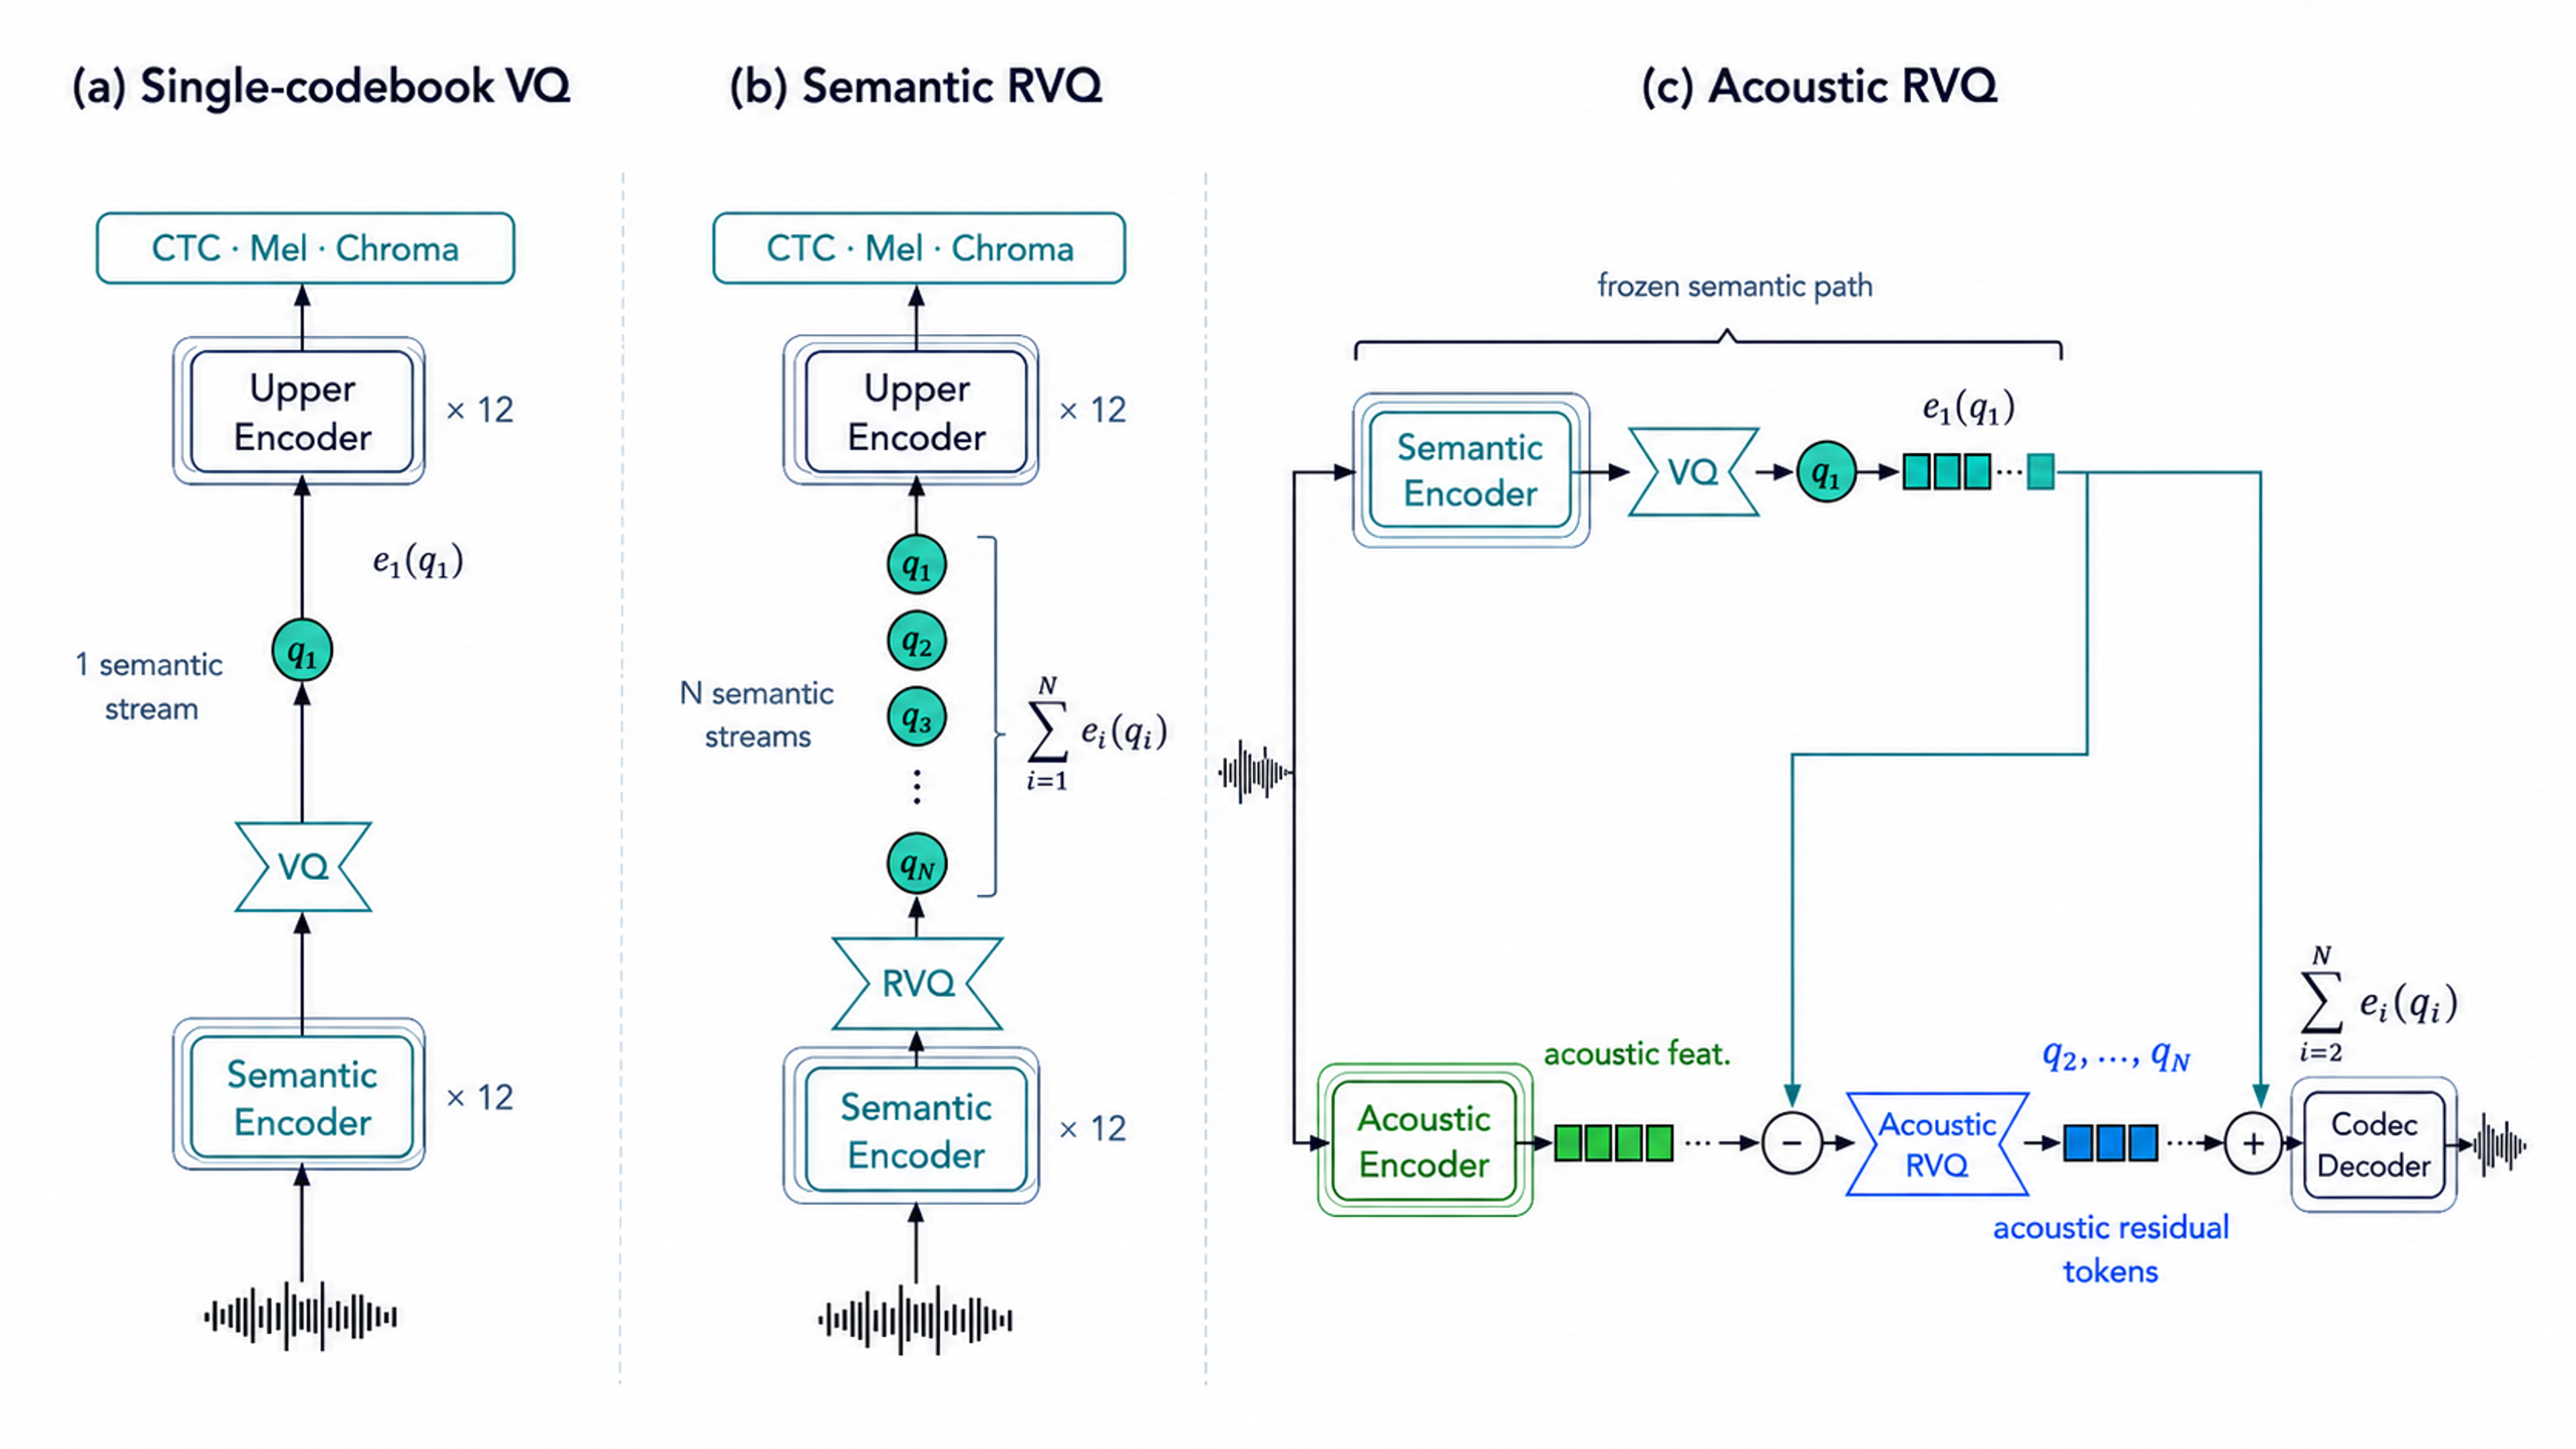
Figure 3 — 토크나이저 병목 설계 비교
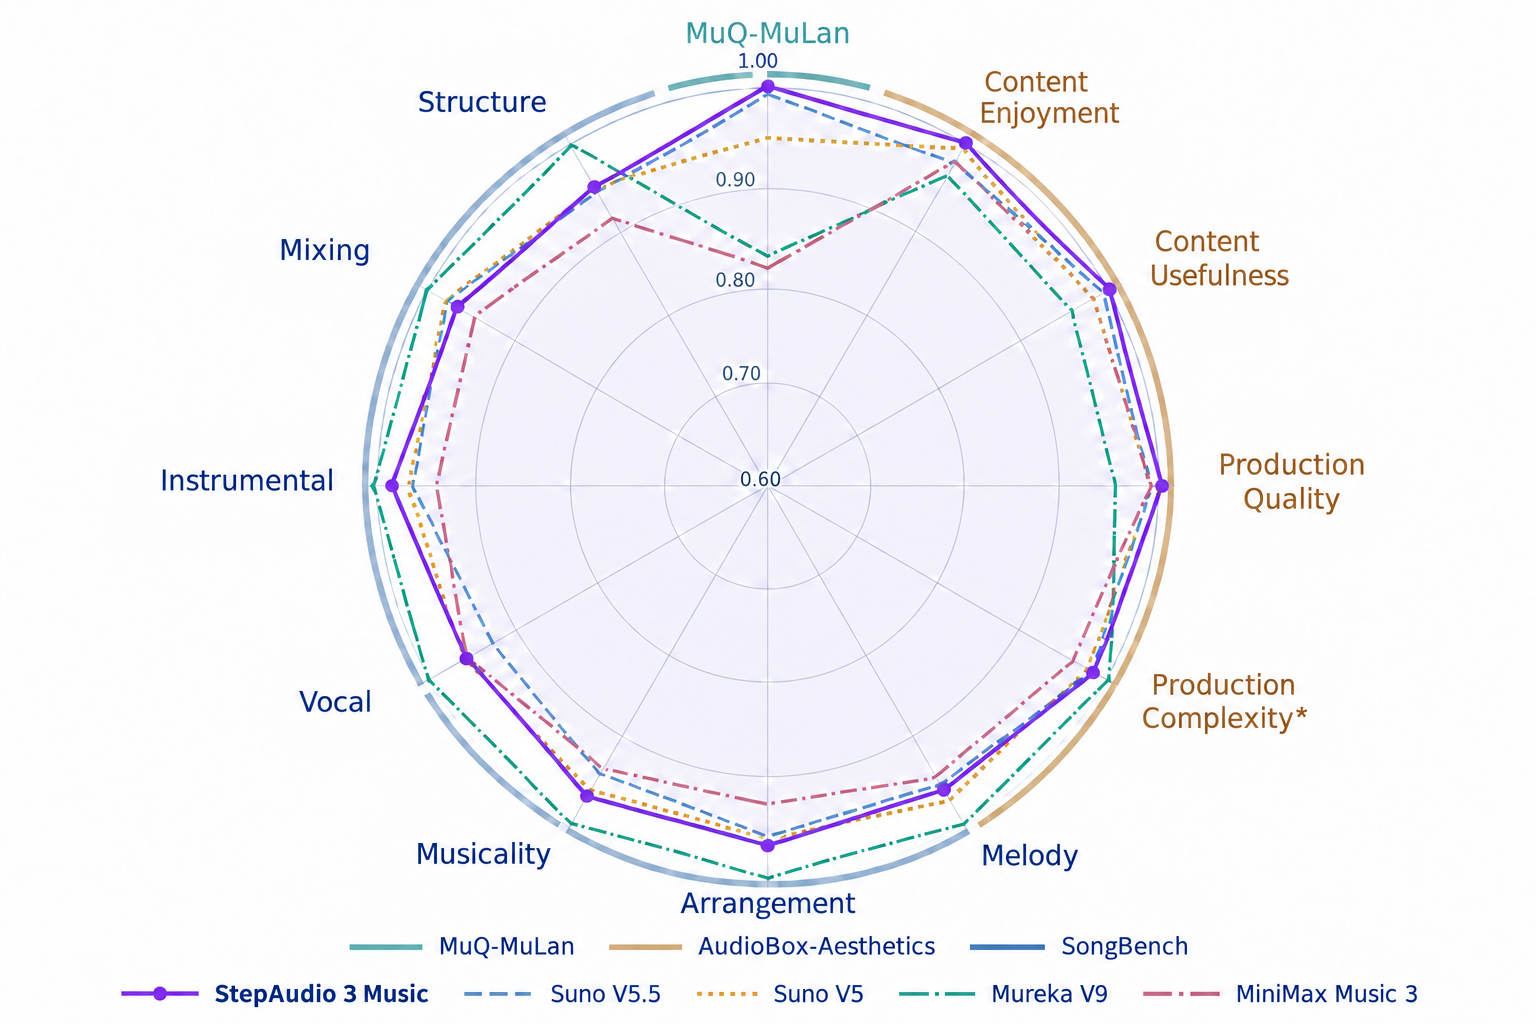
Figure 1 — 객관적 평가 레이더 차트
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Aligning Generative Music AI with Human Preferences: Methods and Challenges
- [논문리뷰] Thinking in a Low-Resource Language: What SFT Builds, What RL Fixes, What Accuracy Cannot See
- [논문리뷰] DyPES-VLA: Learning Shared Dynamics Priors and Embodiment-Specific Control for Cross-Embodiment Manipulation
- [논문리뷰] Where Should Optimizer State Live? Tiered State Allocation for Memory-Efficient Mixture-of-Experts Training
- [논문리뷰] Qwen-Music Technical Report
Review 의 다른글
- 이전글 [논문리뷰] ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents
- 현재글 : [논문리뷰] StepAudio 3 Music Technical Report
- 다음글 [논문리뷰] StepAudio 3 Realtime Technical Report
댓글