[논문리뷰] LimiX-2: A Contextual Mechanism Network Towards General Structured-Data Intelligence
링크: 논문 PDF로 바로 열기
메타데이터
저자: LimiX Team (Xingxuan Zhang, Gang Ren, Hao Yuan, et al.)
1. Key Terms & Definitions (핵심 용어 및 정의)
- CMN (Contextual Mechanism Networks): 특정 타겟 예측에 집중하는 기존 모델과 달리, 변수 간의 예측 의존성 시스템을 학습하여 데이터 생성의 공동 구조를 파악하는 새로운 모델링 패러다임입니다.
- CCMM (Context-Conditional Masked Modeling): 타겟 예측과 특징 재구성(feature reconstruction)을 결합하여, 다양한 관측 패턴 하에서 변수 간의 관계를 명시적으로 학습하는 사전학습 목표입니다.
- SCM (Structural Causal Models): 변수 간의 인과 관계와 함수적 기제를 체계적으로 정의하여, 사전학습을 위한 다양하고 복잡한 구조의 합성 데이터를 생성하는 프레임워크입니다.
- DFE (Discriminative Feature Encoding): 저차원 코드와 변환 행렬을 사용하여 컬럼의 고유 식별 정보를 학습함으로써, 모델이 위치 정보가 아닌 컬럼 자체의 의미를 구분하게 만드는 기술입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 구조화된 데이터(Structured Data)를 범용적으로 학습하고 추론하는 인공지능 모델의 개발을 목표로 합니다. 기존 연구(PFN 등)는 데이터셋 내 특정 타겟 컬럼을 예측하는 p(y|x, D_context) 최적화에 국한되어 있어, 변수 간의 복잡한 공동 분포를 포착하는 데 한계가 있습니다. 이러한 방식은 새로운 태스크나 결측치 처리 등 보다 넓은 조건부 추론 작업으로 확장하기 어렵습니다. 따라서 저자들은 데이터의 내재적 생성 메커니즘을 학습하고, 다양한 태스크를 단일 모델로 수행할 수 있는 범용적인 LimiX-2 모델을 제안합니다. [Figure 1]
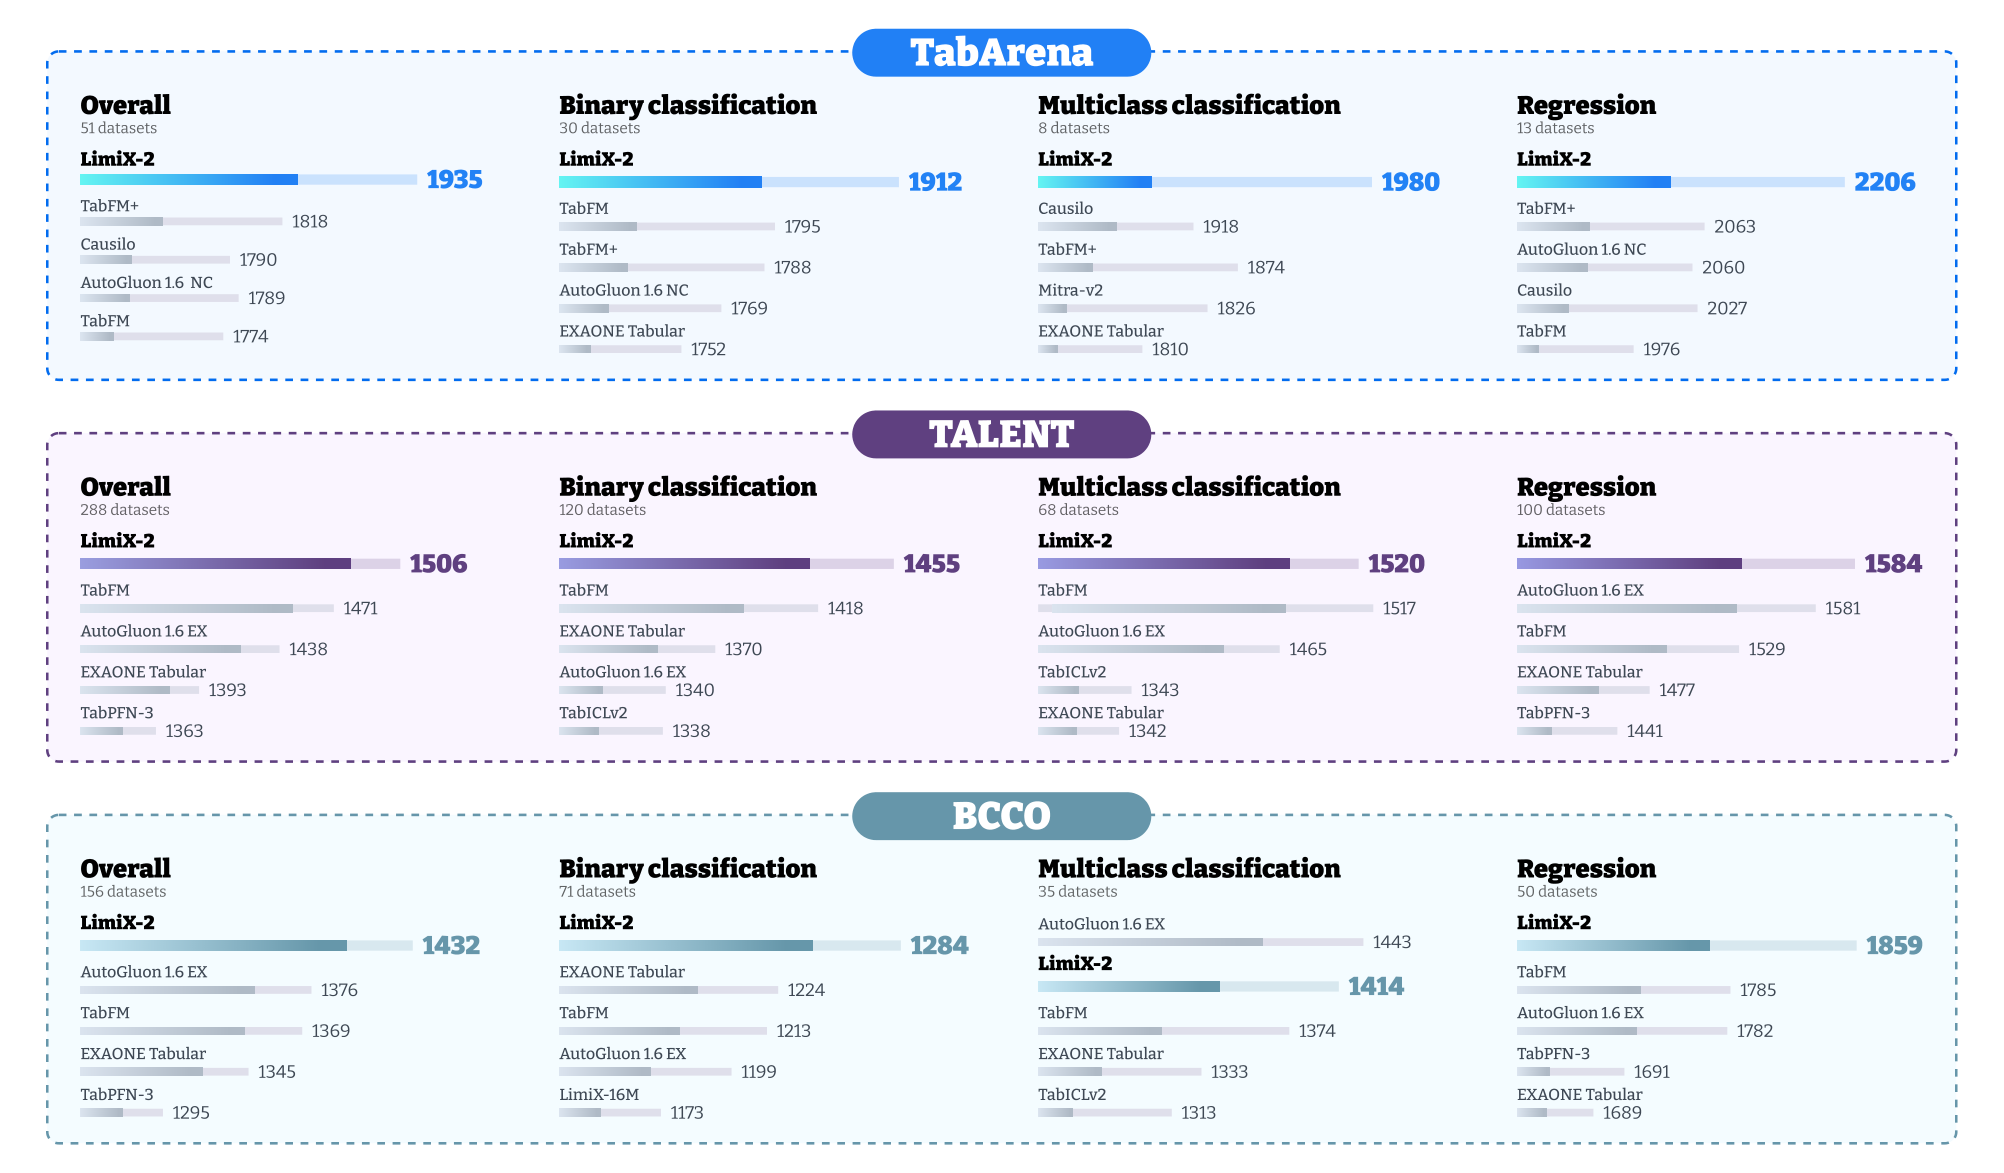
Figure 1 — 주요 벤치마크 Elo 점수 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 CMN 패러다임을 도입하여 모델의 초점을 개별 타겟 예측에서 시스템 전반의 의존성 학습으로 전환합니다. LimiX-2는 Transformer 기반의 이중 축(dual-axis) 구조를 채택하여, 셀 단위(cell-level) 표현을 통해 데이터의 세밀한 구조를 보존하고, CCMM을 통해 지도 학습과 비지도 학습을 통합 수행합니다. [Figure 2] 또한, 인과 관계를 반영하는 SCM 프레임워크를 확장하여 생성된 대규모 합성 데이터를 통해 사전학습을 진행함으로써 모델의 범용성을 확보했습니다. [Figure 3] 실험 결과, LimiX-2는 TabArena, TALENT, BCCO 벤치마크에서 기존의 데이터셋별 특화 모델 및 최신 tabular foundation model을 능가하는 성능을 보였습니다. 특히, TabArena에서 1935, TALENT에서 1506, BCCO에서 1432의 높은 Elo score를 기록하며 모든 벤치마크에서 압도적인 우위를 점했습니다.
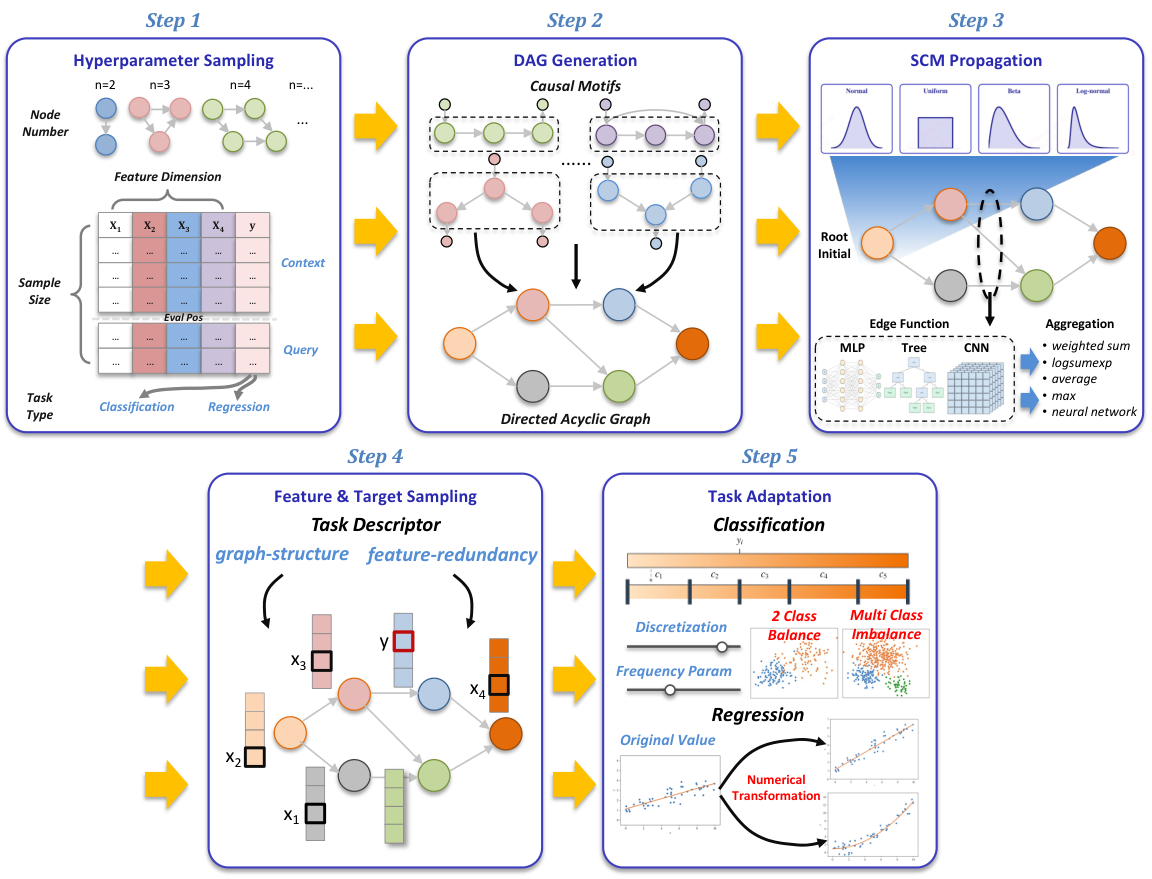
Figure 3 — 합성 데이터 생성 과정
4. Conclusion & Impact (결론 및 시사점)
LimiX-2는 CMN 패러다임과 CCMM을 통해 구조화된 데이터 추론의 새로운 표준을 제시합니다. 본 연구는 단일 모델로 분류, 회귀, 결측치 보간, 나아가 인과 구조 발견까지 수행할 수 있음을 입증하여 범용 구조화 데이터 지능(General Structured-Data Intelligence)의 가능성을 확장했습니다. 이는 학계에는 인과 기반의 데이터 모델링이라는 새로운 방향성을, 산업계에는 별도의 모델 튜닝 없이 다양한 태스크에 즉각 대응 가능한 고성능 모델의 청사진을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Causal Foundation Models
- [논문리뷰] Sample-Efficient Learning from Agent Experience
- [논문리뷰] Partition, Prompt, Aggregate: Statistical Self-Consistency in Language Models
- [논문리뷰] Enhancing In-context Panoramic Generation via Geometric-aware Pretraining
- [논문리뷰] CausalDS: Benchmarking Causal Reasoning in Data-Science Agents
Review 의 다른글
- 이전글 [논문리뷰] In-Context Robot Learning with VLM Agents
- 현재글 : [논문리뷰] LimiX-2: A Contextual Mechanism Network Towards General Structured-Data Intelligence
- 다음글 [논문리뷰] PANORAMA: Panoptic Grounded Captioning via Mask Proposal Selection
댓글