[논문리뷰] GraphSkillEvo: Evolutionary Optimization of Graph-Structured Agent Skills
링크: 논문 PDF로 바로 열기
메타데이터
저자: Rui Sun, Zhi Zheng, Zhenkun Wang, Zhichao Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Graph-Structured Skills: 각 노드가 특정 실행 단계(Execution step)를 나타내고, 유향 간선(Directed edges)이 단계 간의 문맥적 전환을 인코딩하는 구조화된 형태의 스킬입니다.
- GraphSkillEvo: 구조화된 스킬 공간을 탐색하기 위해 Mutation 및 Crossover 연산자를 사용하는 인구 기반(Population-based) 진화적 최적화 프레임워크입니다.
- Evolutionary Operators: Global-guidance/Graph-structure Mutation과 Crossover를 통해 최적의 스킬 구성을 탐색하고 효율적인 구성 요소를 결합하는 기술적 기법입니다.
- Skill Optimization: LLM 기반 에이전트의 성능을 향상시키기 위해 태스크별 절차적 가이던스(Procedural guidance)를 반복적으로 개선하는 과정입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 비구조적(Unstructured) natural-language 스킬 최적화 방식이 가진 근본적인 한계를 해결하고자 합니다. 기존 방식은 스킬을 단순 텍스트 지시사항으로 표현하여 명시적인 워크플로우 가이드가 부족하고, 결과적으로 에이전트가 상황에 맞는 적절한 단계를 식별하기 어렵게 만듭니다 [Figure 1]. 또한, 제약 없는 자연어 스킬 공간은 탐색 범위가 지나치게 넓어 효율적인 최적화가 어렵다는 문제가 있습니다. 이를 극복하기 위해 본 연구는 스킬을 그래프 구조로 변환하여 실행 단계의 명확성을 높이고 최적화 탐색 공간을 구조화할 필요성을 제시합니다.
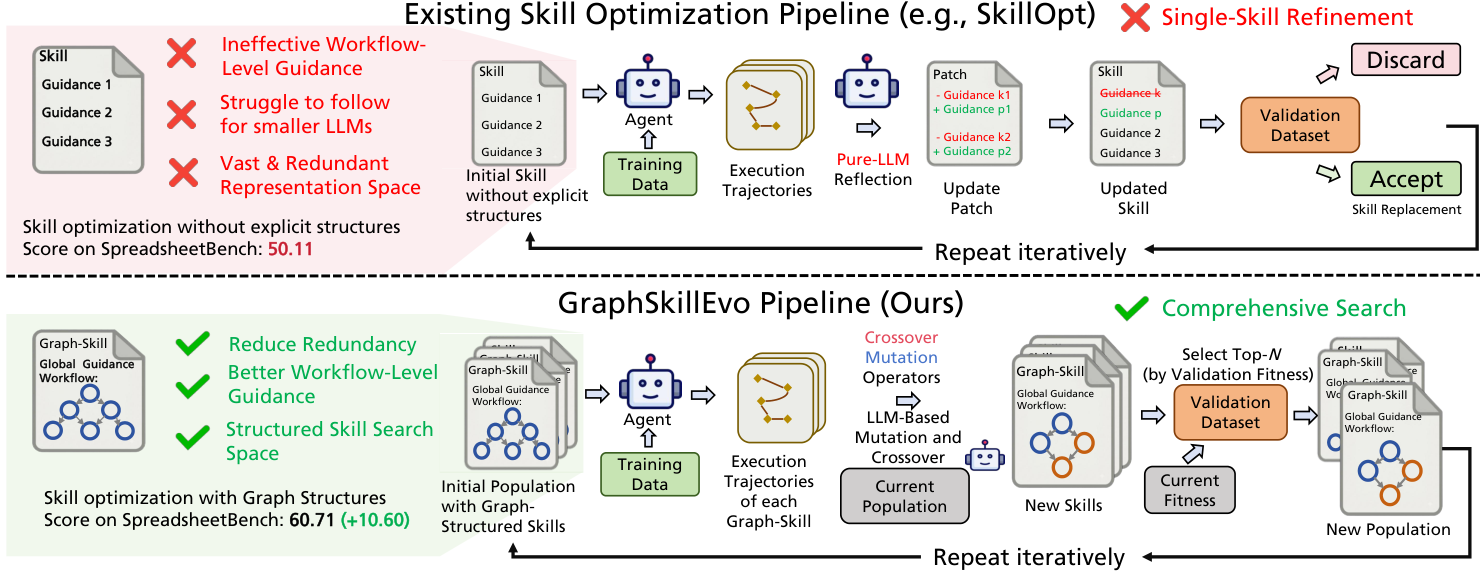
Figure 1 — 기존 방식과 제안 모델 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 스킬을 Global guidance와 Directed graph($V_s, E_s$)로 구성하여 에이전트에게 명확한 워크플로우를 제공하는 GraphSkillEvo 프레임워크를 제안합니다 [Figure 2]. 이 방법론은 인구 기반 진화 알고리즘을 사용하여, Mutation을 통해 실행 궤적(Execution trajectories) 기반의 로컬 개선을 수행하고, Crossover를 통해 서로 다른 스킬 후보 간의 유용한 구성 요소를 재결합합니다. 실험 결과, GraphSkillEvo는 5개 벤치마크에서 기존의 SkillOpt 대비 뛰어난 성능을 입증했습니다. 특히, GPT-5.4-nano 모델에서 SkillOpt 대비 평균 정확도가 4.01% 개선되었으며, 모델의 규모가 작을수록 구조화된 스킬의 효과가 더욱 두드러졌습니다 [Table 1]. 또한, 기존 방식 대비 최적화 과정에서 소비되는 토큰(Token consumption) 양을 유의미하게 절감하면서도 성능 우위를 유지하는 결과를 보였습니다 [Table 2].
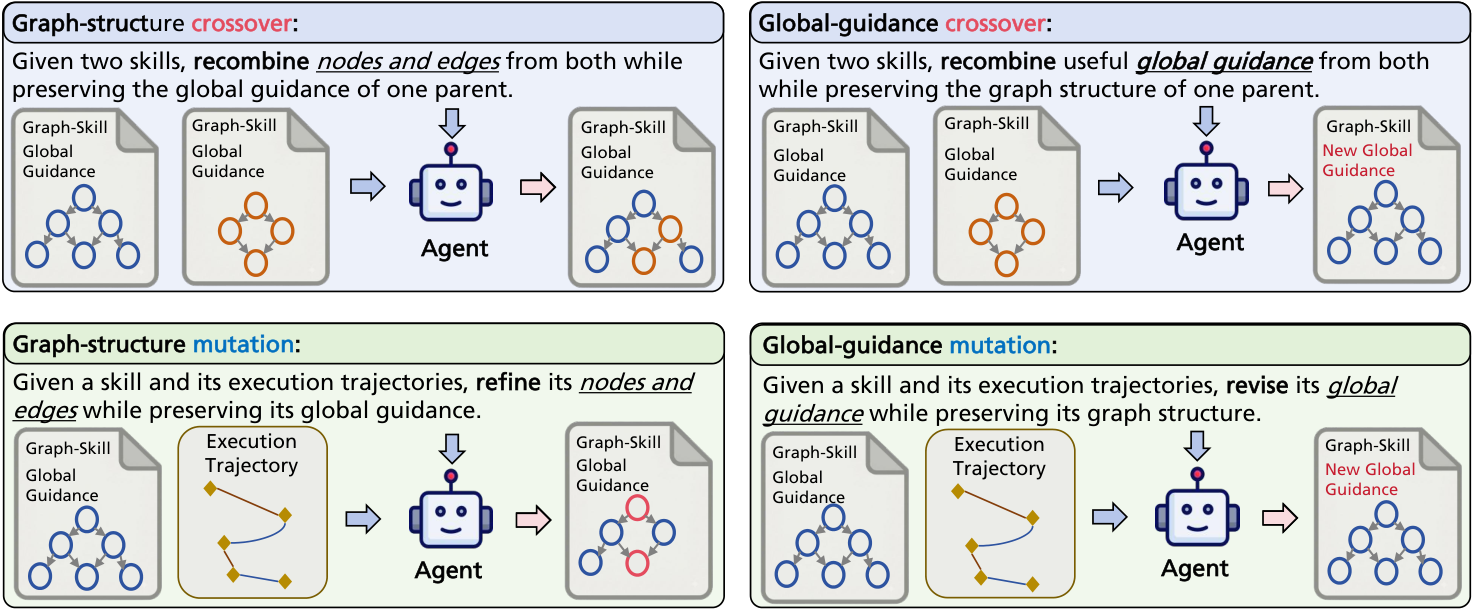
Figure 2 — 4가지 진화 연산자 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 에이전트 스킬을 그래프 구조로 공식화하고 이를 진화적으로 최적화하는 새로운 패러다임을 제시함으로써, LLM 에이전트의 절차적 실행 능력을 한 단계 높였습니다. 이 연구는 비구조적 텍스트 기반의 스킬 최적화 방식에서 벗어나, 명시적인 구조를 도입함으로써 복잡한 태스크 수행 효율을 극대화할 수 있음을 입증했습니다. 연구 결과는 학계의 에이전트 스킬 최적화 연구뿐만 아니라, 산업계의 복잡한 워크플로우 자동화 도구 개발에도 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MOCHA: Multi-Objective Chebyshev Annealing for Agent Skill Optimization
- [논문리뷰] COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization
- [논문리뷰] Learning to Learn-at-Test-Time: Language Agents with Learnable Adaptation Policies
- [논문리뷰] Agent-Editing World Model: Rethinking World Modeling for LLM Agents
- [논문리뷰] The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks
Review 의 다른글
- 이전글 [논문리뷰] Geometry of Values: Task Vector Composition for Ethical Preference Alignment in Language Models
- 현재글 : [논문리뷰] GraphSkillEvo: Evolutionary Optimization of Graph-Structured Agent Skills
- 다음글 [논문리뷰] Gricea: An Open Science Platform for Conversational AI Research
댓글