[논문리뷰] MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
링크: 논문 PDF로 바로 열기
저자: Muchen Li, Leonid Sigal, Renjie Liao
1. Key Terms & Definitions (핵심 용어 및 정의)
- MoME (Mixture of Memory Embeddings): 토큰마다 하나의 고정된 메모리 행을 할당하는 대신, 여러 개의 메모리 슬롯(slot)과 문맥에 따른 게이팅(gating) 메커니즘을 도입하여 상황별로 적절한 메모리를 조회하는 기법입니다.
- Context-Aware Routing: 모델의 hidden state를 기반으로 현재 위치에서 어떤 메모리 슬롯을 읽을지 동적으로 결정하는 모듈로, 단어의 중의적 의미를 처리하는 핵심적인 역할을 합니다.
- Token-Indexed Memory: 입력 토큰이나 n-gram 정보를 사용하여 메모리 테이블의 특정 행을 직접 조회하는 방식입니다. 기존 방식은 이 과정이 결정론적(deterministic)이었으나, MoME는 여기에 문맥적 선택을 추가했습니다.
- Gated Injection: 조회된 메모리 벡터를 모델의 attention value stream에 합칠 때, 게이트 메커니즘을 통해 그 영향력을 동적으로 조절하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 메모리 확장 방식이 갖는 문맥 무지성(context-blind) 문제와 용량 할당의 비효율성을 해결하기 위해 제안되었습니다. 기존 연구들(Value Embedding, STEM 등)은 토큰 ID나 n-gram에 기반한 결정론적 조회 방식을 사용하여, 동일한 단어라도 문맥에 따라 다른 의미를 가질 수 있는 polysemy 상황을 단일 벡터로밖에 표현하지 못하는 한계가 있습니다 [Figure 1]. 또한, 모든 토큰을 동일하게 취급하여 중요도에 따른 용량 배분이 이루어지지 않는다는 문제점이 있습니다. 이에 저자들은 효율적인 sparse lookup 구조를 유지하면서도 문맥에 따라 적절한 메모리 슬롯을 동적으로 선택할 수 있는 구조가 필요하다고 판단했습니다.
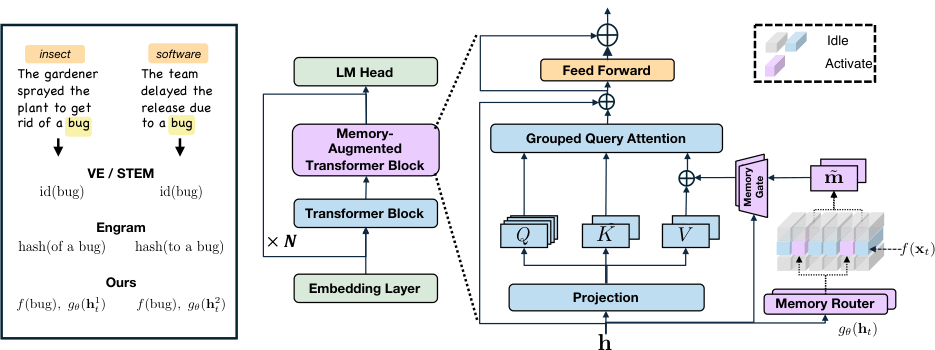
Figure 1 — MoME의 전체 아키텍처 및 라우팅
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 MoME를 통해 각 토큰의 메모리 행을 M개의 슬롯으로 구성하고, 입력 hidden state에 기반한 Context-Aware Router를 통해 특정 시점에 필요한 슬롯만을 선택 및 가중치 합산하여 활용하는 방법론을 제안합니다 [Figure 1]. 학습 효율성을 높이기 위해 유사한 의미를 가진 토큰들을 하나의 행으로 묶는 Token-Index Grouping 기법을 적용하였으며, 이는 메모리 용량 최적화에 기여합니다.
성능 평가 결과, MoME는 nanochat, Llama-3/MobileLLM, Qwen3 등 다양한 backbone에서 기존 Value Embedding, Bigram, STEM 베이스라인 대비 우수한 성능을 보였습니다 [Table 2], [Table 3]. 구체적으로 iso-parameter 및 iso-training-FLOP 환경에서 validation bpb와 CORE 지표 모두에서 비교 우위를 점하였습니다. 특히 polysemous 토큰(예: 'bank', 'python')에 대한 라우팅 분석 결과, 동일한 표면 형태의 토큰이라도 문맥에 따라 다른 메모리 슬롯으로 라우팅되는 것을 확인하여 문맥 적응성(contextual adaptivity)을 입증했습니다 [Figure 1]. 추론 속도 면에서도 MoME는 기존 고비용 연산 대비 negligible한 수준의 latency 오버헤드만을 추가하여 효율성을 유지했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 문맥 인지형 메모리 조회가 가능한 MoME 프레임워크를 통해 sparse 모델링의 새로운 가능성을 제시했습니다. 이 연구는 모델의 파라미터 수를 대폭 늘리지 않고도 메모리 효율성과 문맥 이해 능력을 동시에 향상할 수 있음을 입증했습니다. 학계 및 산업계에서 제안된 routing 및 gating 기법은 향후 대규모 언어 모델의 지식 저장 및 검색 효율성을 극대화하는 표준적인 memory augmentation 기술로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] MintAct: A Unified Visual Agent for Digital Environments
- 현재글 : [논문리뷰] MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
- 다음글 [논문리뷰] OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
댓글