[논문리뷰] Paint-Anything: Unified Any-Color Control for Image Generation and Editing
링크: 논문 PDF로 바로 열기
저자: Ji Xie, Dewei Zhou, Xinyu Huang, Zhennan Chen, Xun Wang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Any-Color Control: 24-bit RGB hex 값을 사용하여 사용자가 직접 객체의 색상을 지정하고 제어할 수 있는 이미지 생성 및 편집 기능입니다.
- Paint-500K: 본 연구에서 구축한 대규모 데이터셋으로, VLM grounding과 CIELAB 기반의 색상 추출 파이프라인을 통해 정제된 객체-색상 쌍을 포함합니다.
- Pure-Color Anchor: 실제 이미지의 조명 변화에 따른 색상 불확실성을 극복하기 위해 도입된 기법으로, 고정된 hex 값과 솔리드 색상 이미지를 매칭하여 모델이 색상 정보를 정교하게 학습하도록 돕는 보조 데이터입니다.
- ACBench: 이미지 생성(T2I) 및 편집 시 객체 수준의 hex 색상 충실도(fidelity)를 측정하기 위해 제안된 벤치마크입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
- Paint-Anything은 전문적인 디자인 요구사항을 충족하기 위해 객체 색상을 24-bit hex 값으로 정밀하게 제어하려는 목적으로 설계되었습니다.
- 기존 연구들은 특정 색상 모듈이나 학습 기반 토큰에 의존하거나, 복잡한 inference 단계의 guidance를 필요로 하여 확장성과 효율성 면에서 한계를 보였습니다.
- 특히 자연스러운 이미지 데이터는 그림자나 조명으로 인해 색상 정보가 노이즈를 포함하고 있어, 명확한 수치 기반의 색상 대응을 학습하기 어렵다는 문제가 있습니다.
- 본 연구는 텍스트 프롬프트 내에
<color>#HEX</color>태그를 사용하는 통합 인터페이스를 통해 별도의 제어기 없이도 생성과 편집을 동시에 수행하는 네이티브한 제어 능력을 구현하고자 합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
- Paint-Anything은 FLUX.2-4B 베이스 모델에 기반하여, 텍스트 프롬프트 내 explicit color tagging을 통해 학습된 공유 인터페이스를 활용합니다.
- 저자들은 고해상도 생성 모델을 미세 조정하기 위해 real-image 데이터셋에 고주파 노이즈 단계에서만 활성화되는 Pure-Color Anchor를 결합한 고효율 학습 파이프라인을 제안하였습니다.
- 학습 과정에서는 CIELAB 공간에서의 MeanShift 클러스터링을 도입하여 객체의 색상 노이즈를 효과적으로 분리하고 정교한 지도 학습을 가능하게 했습니다.
- 실험 결과, ACBench-T2I 점수에서 기존 모델 대비 85.3%, ACBench-Edit에서 28.3%의 성능 향상을 기록하며 압도적인 색상 충실도를 증명하였습니다.
- [Table 1]에서 볼 수 있듯이, 본 모델은 8B 파라미터 규모임에도 불구하고 56B 규모의 모델을 능가하는 수치를 기록하였으며, CompColor 및 기타 독립적인 벤치마크에서도 최고 수준의 성능을 달성하였습니다.
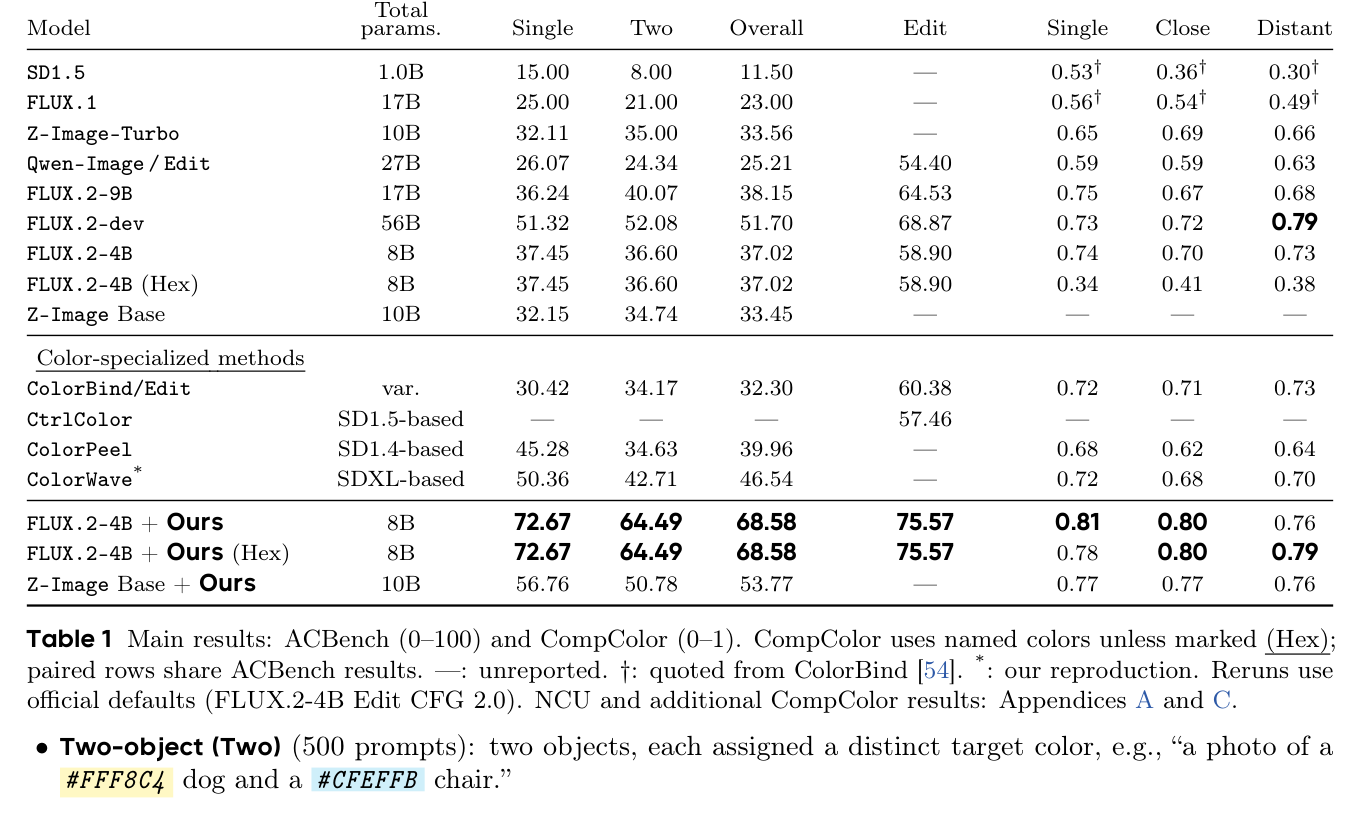
Table 1 — 기존 방법론들과의 정량적 성능 비교 및 본 연구의 우월성 증명
## 4. Conclusion & Impact (결론 및 시사점)
- 본 논문은 pretrained 모델이 프롬프트 내 hex 코드만으로도 정밀한 객체 수준의 색상 제어를 학습할 수 있음을 입증하며, 생성과 편집을 단일 프레임워크로 통합하는 성과를 거두었습니다.
- 제안된 Paint-500K 데이터셋과 ACBench는 향후 색상 제어 연구의 표준 벤치마크로서 기여할 것으로 기대됩니다.
- 본 연구는 복잡한 하드웨어 가속이나 추가적인 학습 없이도 기존 생성 모델의 기능을 확장할 수 있는 실용적인 방법론을 제시함으로써, AI 기반 디자인 도구의 현실적인 활용 가능성을 크게 높였습니다.
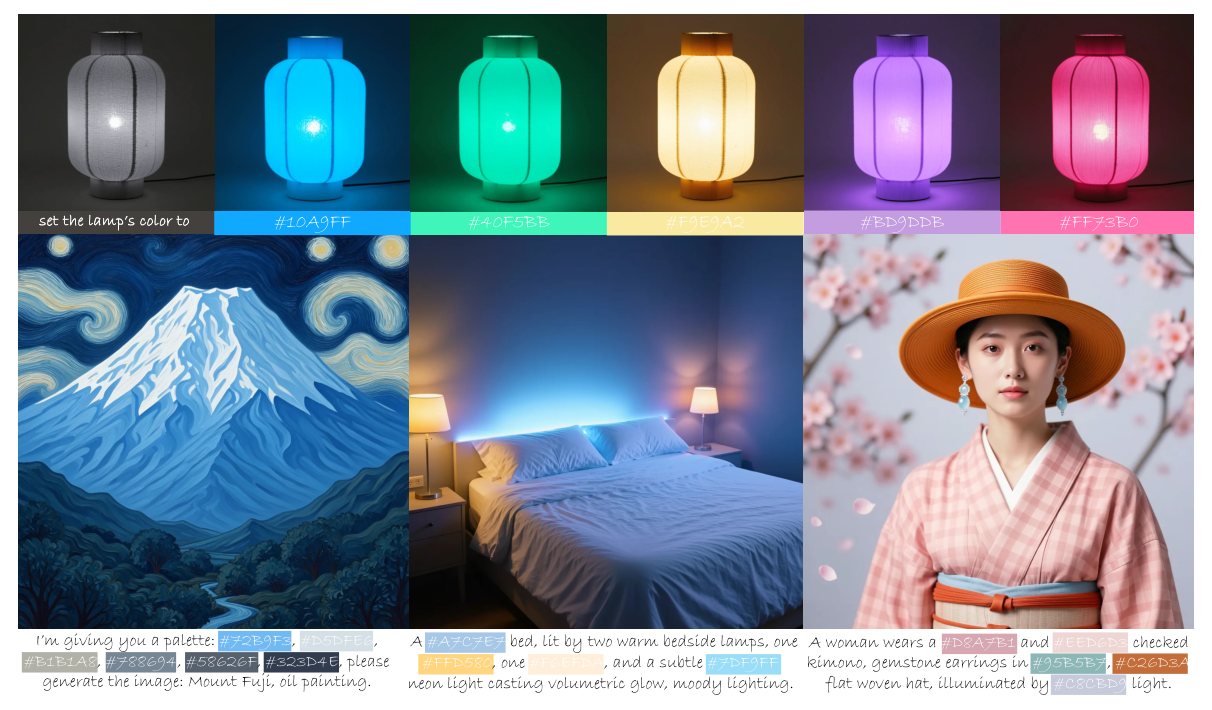
Figure 1 — 본 연구가 제안하는 hex-prompt 인터페이스의 개념을 보여주는 그림
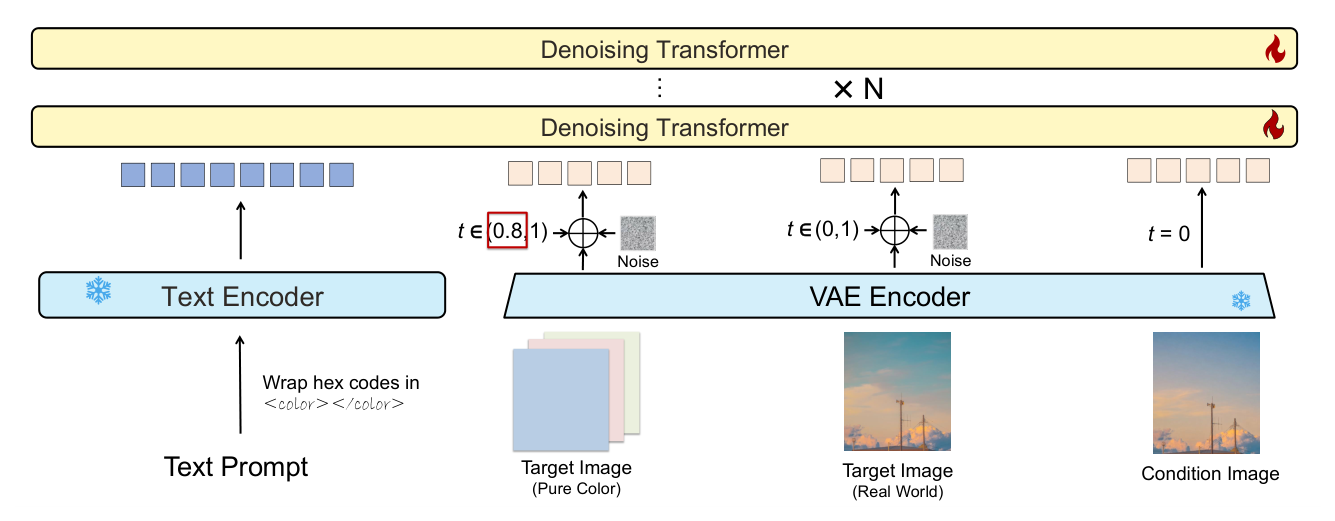
Figure 3 — 본 연구의 핵심 학습 아키텍처 및 flow-matching Objective
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Understanding vs. Generation: Navigating Optimization Dilemma in Multimodal Models
- [논문리뷰] Rethinking Global Text Conditioning in Diffusion Transformers
- [논문리뷰] Both Semantics and Reconstruction Matter: Making Representation Encoders Ready for Text-to-Image Generation and Editing
- [논문리뷰] Multimodal RewardBench 2: Evaluating Omni Reward Models for Interleaved Text and Image
- [논문리뷰] Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer
Review 의 다른글
- 이전글 [논문리뷰] OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
- 현재글 : [논문리뷰] Paint-Anything: Unified Any-Color Control for Image Generation and Editing
- 다음글 [논문리뷰] RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents
댓글