[논문리뷰] One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents
링크: 논문 PDF로 바로 열기
저자: Jie Zhao, Ziyu Jiang, Suhang Zheng, Minghui Shan, Xiaoxiao Xu, Lin Qu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Category See-Saw:
Pooled agentic Reinforcement Learning (RL)과정에서 일부Software Engineering (SWE)task category의 성능 향상이 다른 category의 퇴보와 동시에 발생하며, 전체(aggregate) 성공률로는 이러한 내부 변화가 드러나지 않는 현상을 지칭합니다. - SWE Labeler:
SWE task를 sematiccategory로 분류하기 위해 고안된evidence-grounded hierarchical multi-axis labeling system으로,training pool구성 및 분석에 활용됩니다. - Refresh–Repair–Expand (RRE):
Category-specific expert를 개발하기 위한iterative training loop입니다. 이 과정은policy개발을data selection과 연동하여instance mastery를refresh하고, 스스로 생성하여 검증된successful trajectory를Repair SFT에 재사용하며, 다음RL단계를 위해task를 재선정합니다. - Agentic-miniRL:
long-horizon multi-turn SWE trajectory에 특화된MiniRL의policy-gradient variant입니다.RLOO reward centering,K1 regularization,behavior correction등의 최적화 기법을 통합하여Agentic SWE환경에서의RL안정성을 높입니다. - Multi-Teacher On-Policy Distillation (MOPD): 여러
category expert policy의 역량을 하나의deployable student policy로 통합하는 방법론입니다.label-routed teacher signal과ReLU-gated reward extrapolation을 사용하여 각teacher의improving direction을student에게 전달합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 repository-level Software Engineering (SWE) task의 heterogeneous한 특성으로 인해 발생하는 category see-saw 문제를 해결하고자 합니다 [Figure 2]. 기존 pooled agentic Reinforcement Learning (RL) 방식은 전체적인 resolution 개선에도 불구하고, 일부 task category에서 gain이 발생하는 동시에 다른 category에서는 regression이 나타나는 현상을 보였습니다. 이는 단일 aggregate metric으로는 SWE agent의 내부적인 역량 재분배를 파악하기 어렵게 만들며, multi-domain LLM fine-tuning 및 multi-domain RL 연구에서도 유사한 trade-off가 관찰되었습니다.
기존 연구들은 pooled mixture에 대한 joint training, pipeline decomposition을 통한 subtask 분해, 또는 cross-domain expert를 splitting하고 fusion하는 방식에 집중했습니다. 그러나 이러한 접근 방식들은 repository-level SWE 내부의 heterogeneity를 효과적으로 다루지 못하며, category see-saw 현상을 발생시키는 근본적인 optimization conflict를 해결하지 못했습니다. 따라서 저자들은 category-aware specialization 및 integration을 통해 shared policy 내에서 coordinated learning을 개선하고, category-specific training을 통해 더 강력한 specialist를 개발하여 이들의 gain을 단일 model로 통합하는 새로운 접근 방식이 필요함을 강조합니다. 특히, 초기 category-specific RL만으로는 average training success가 향상되더라도 instance-level progress가 불균일하게 나타나는 한계를 보였으며, 이는 성공적인 behavior의 명시적인 consolidation과 policy-adaptive task selection의 필요성을 뒷받침합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 category-aware agentic RL framework를 제안하며, 이는 category-specific expert training과 policy integration을 핵심으로 합니다 [Figure 1]. 첫째, SWE Labeler를 통해 SWE task를 evidence-grounded hierarchical labeling system 기반의 sematic category로 분류합니다. 이는 maintenance intent, software ecosystem, modification scope 등의 observable instance property를 활용하며, Taxonomy grounding과 label contract를 통해 interpretable하고 auditable한 label space를 구축합니다. 실험에서는 Repository Domain L1을 기준으로 Pro-A (service/data/security), Pro-B (user-facing applications), Pro-C (systems/tooling/runtimes) 세 가지 category로 task를 routing합니다.
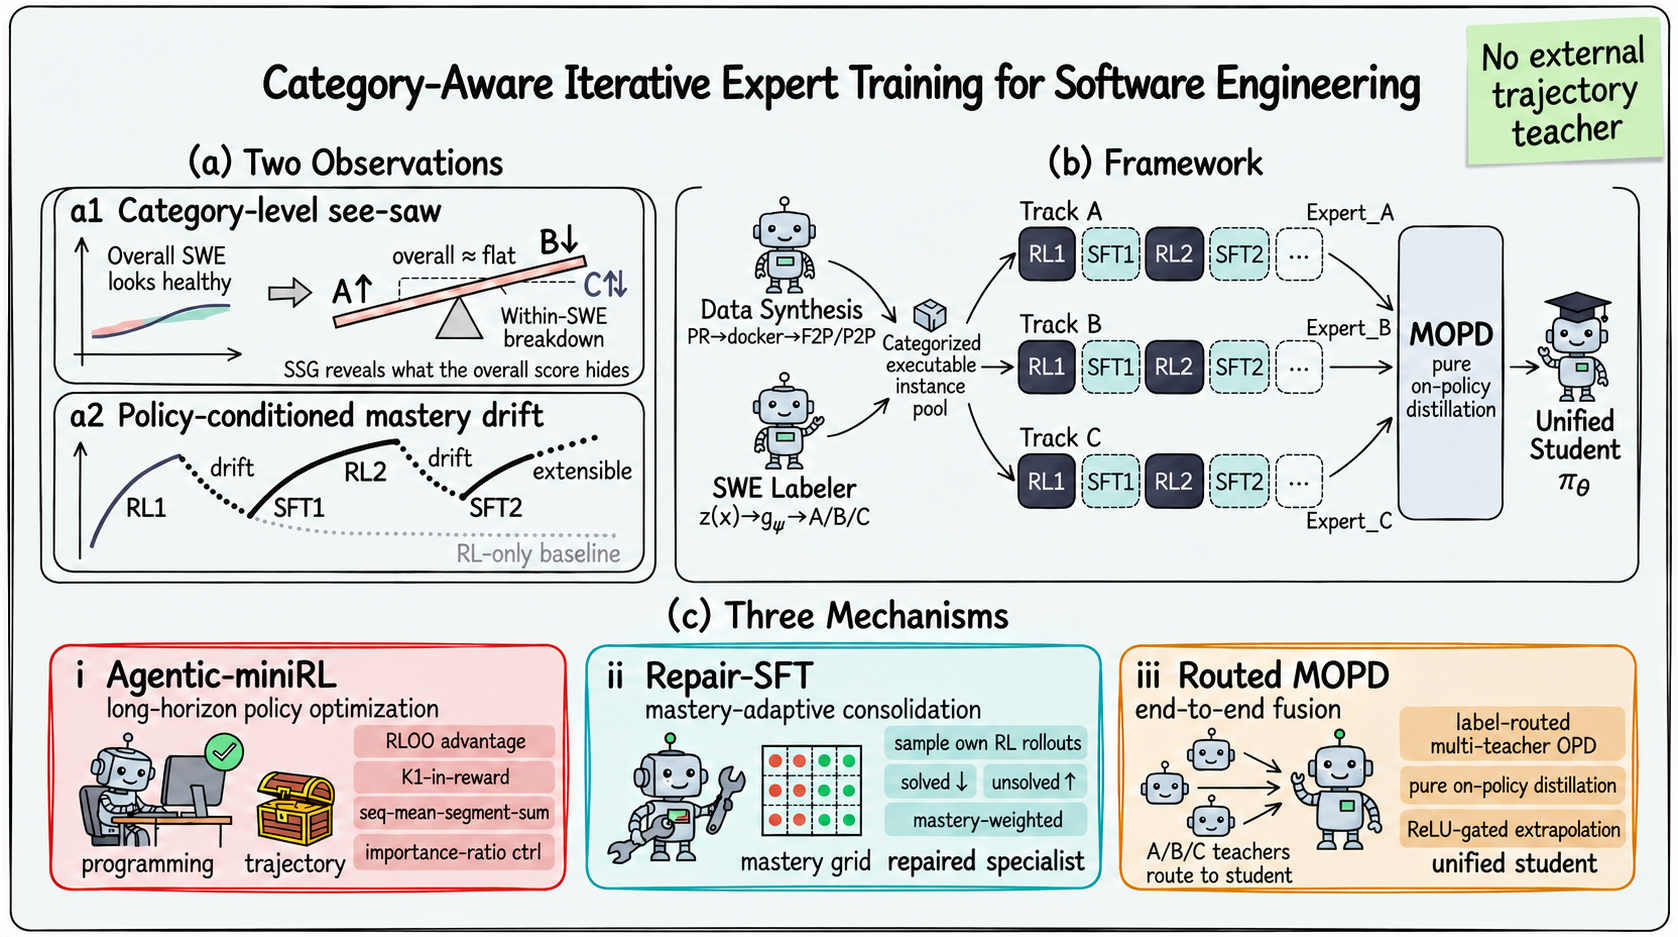
Figure 1 — 제안 프레임워크 개요
둘째, 각 category의 expert는 Refresh–Repair–Expand (RRE) iterative training loop를 통해 개발됩니다 [Figure 4]. 이 loop는 long-horizon Agentic-miniRL과 Repair SFT를 번갈아 수행하며 expert의 policy와 training frontier를 co-evolve 시킵니다. Agentic-miniRL은 RLOO reward centering, K1 regularization, MiniRL token update 등의 최적화 기법을 통해 long-horizon multi-turn SWE trajectory에서 안정적인 policy improvement를 달성합니다. Repair SFT는 expert 스스로 생성한 verifier-approved successful trajectory를 재사용하여 low-mastery instance에 대한 consolidation을 수행함으로써 instance-level regression을 회복하고 target-category resolution을 향상시킵니다. Expanded RL 단계 이후, 모든 expert의 target-category mean은 Pooled RL baseline을 초과하는 성능을 보였습니다.
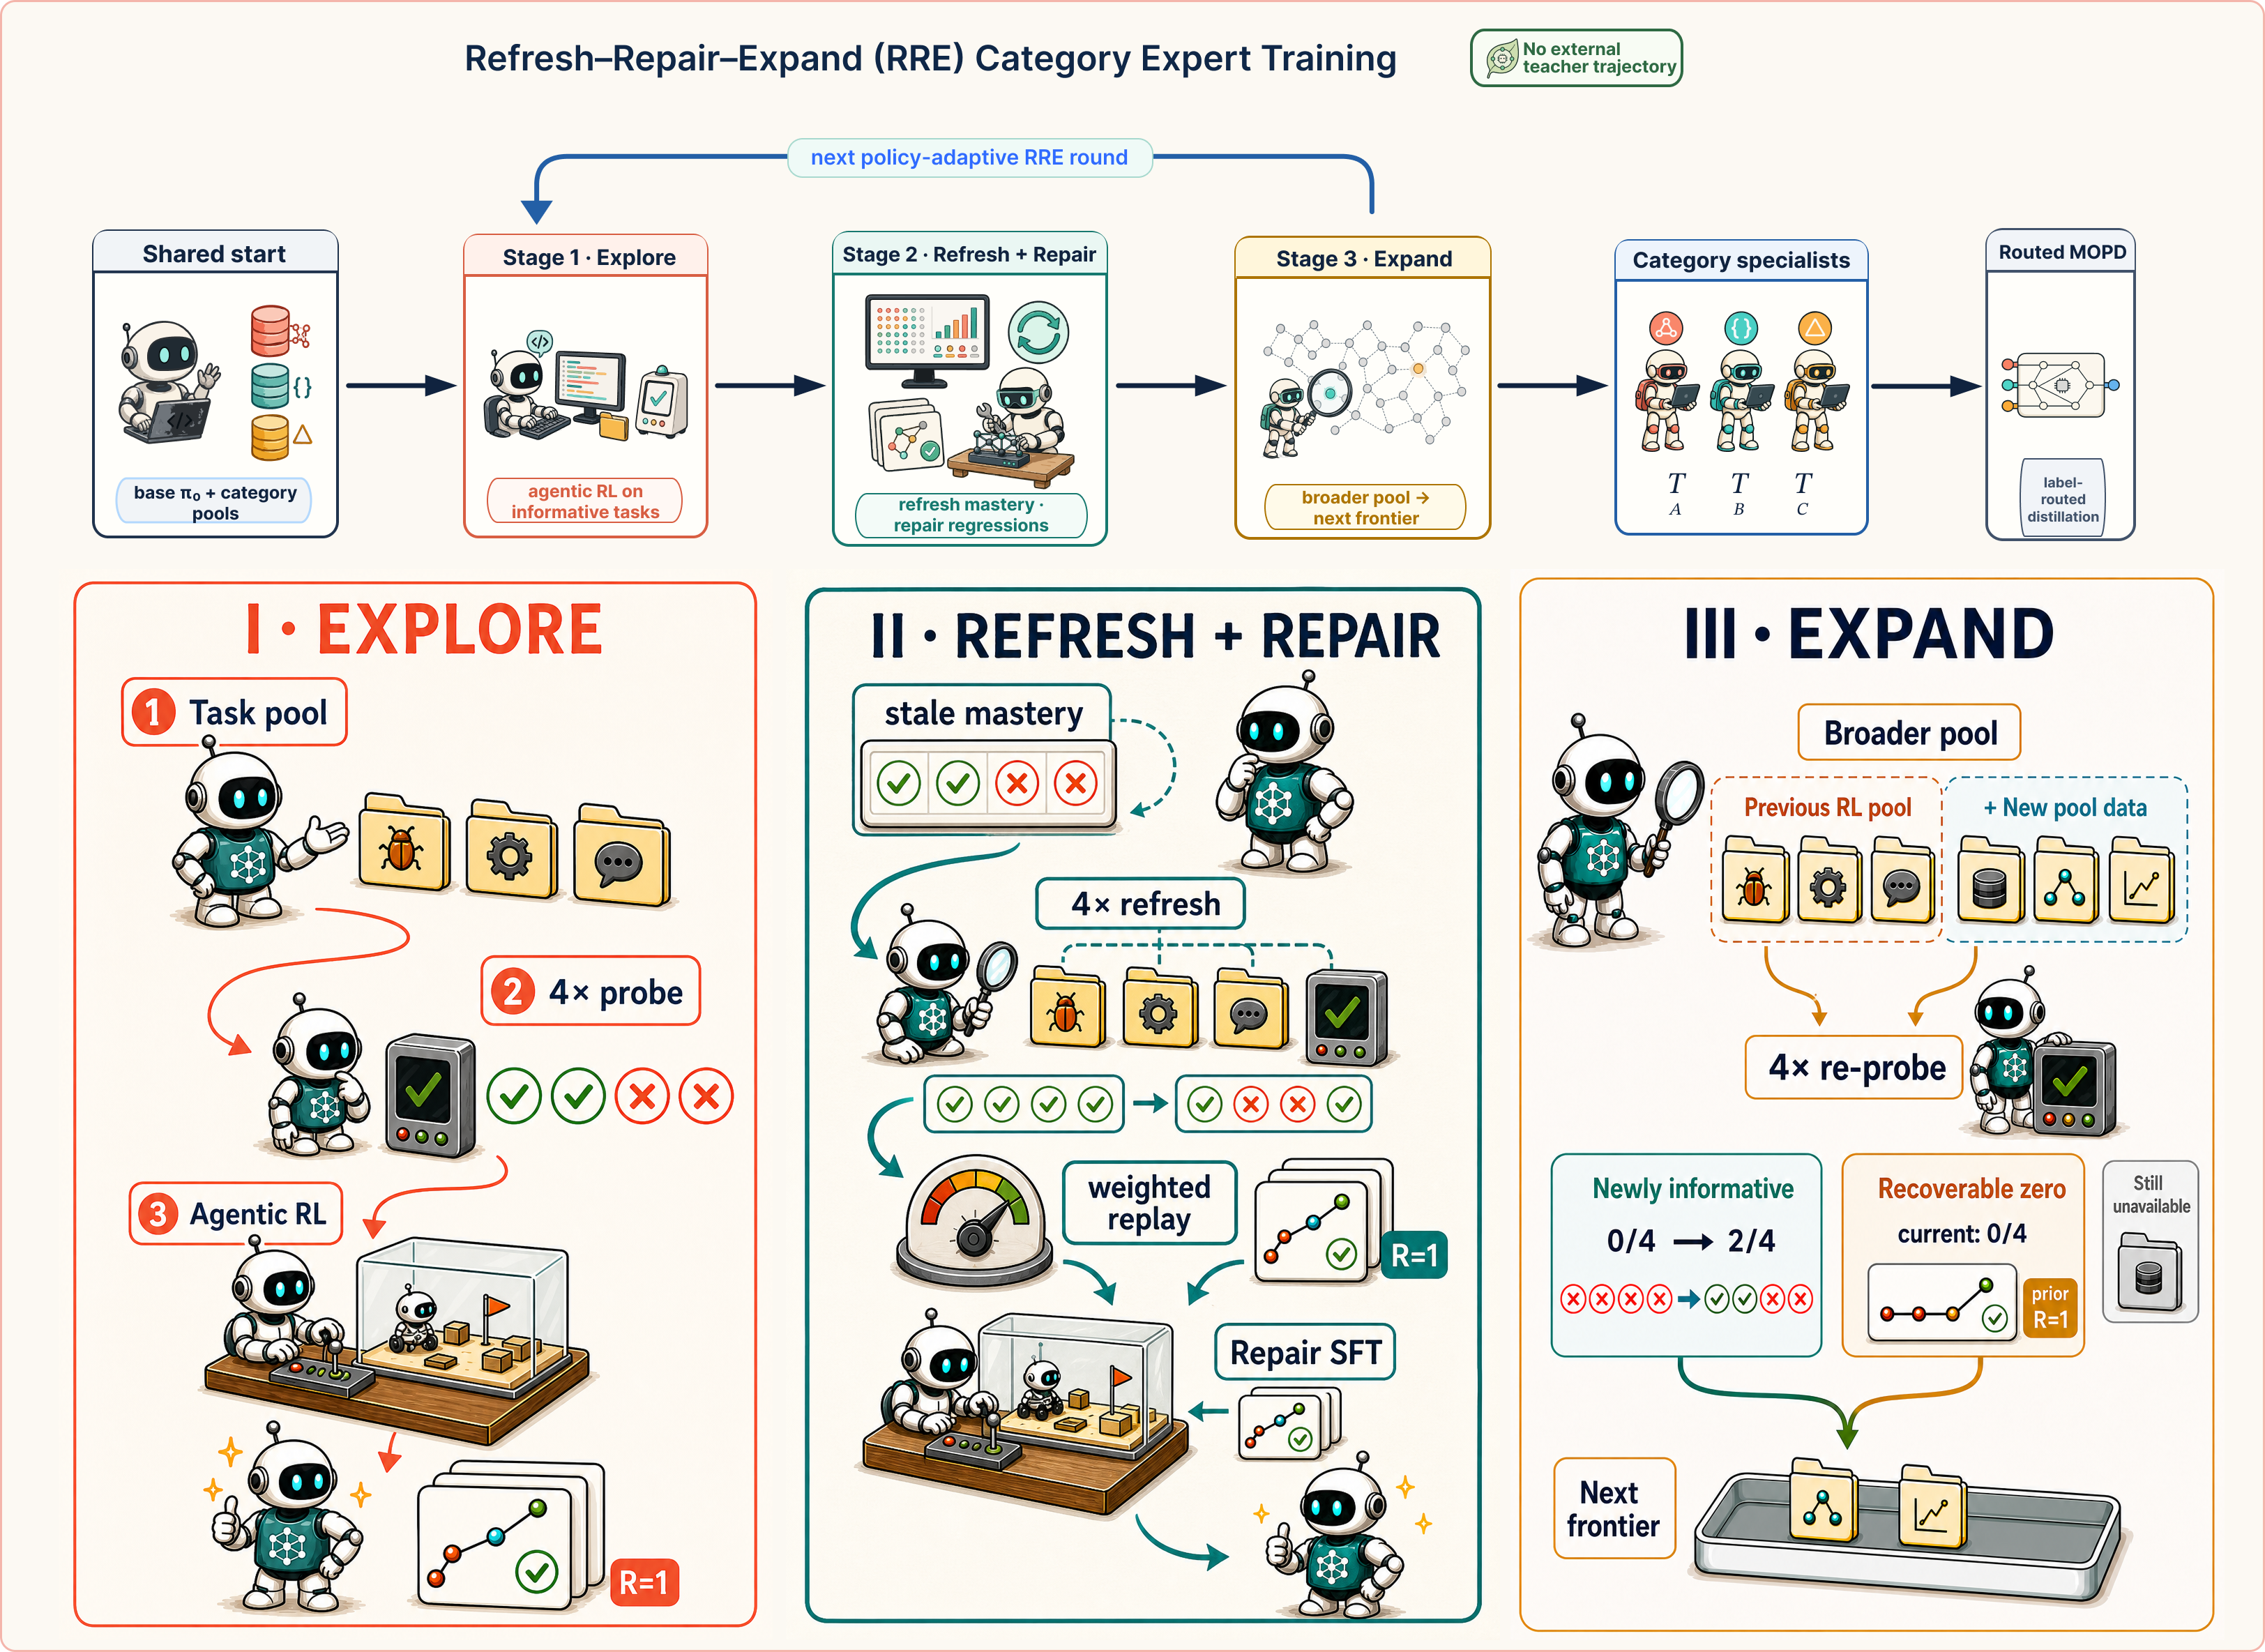
Figure 4 — RRE 전문가 훈련 과정
셋째, category expert들은 label-routed Multi-Teacher On-Policy Distillation (MOPD)을 통해 단일 deployable student policy로 통합됩니다 [Figure 1]. MOPD loss는 ReLU-gated reward extrapolation term을 포함하여 student가 teacher의 improving direction을 모방할 뿐만 아니라 reference policy 대비 teacher가 더 높은 probability를 할당하는 token에 대해 imitation을 넘어 extrapolation할 수 있도록 합니다. 이 framework는 external model 없이 solution trajectory나 action target을 제공합니다.
Pro-618 벤치마크에서 최종 MOPD policy는 58.04%의 mean resolution을 달성하여 base model 대비 5.39 percentage points 향상되었습니다. 특히 Pro-A, Pro-B, Pro-C category에서 각각 6.33, 4.98, 4.76 percentage points의 gain을 보여 aggregate improvement가 모든 category에 걸쳐 나타났습니다 [Table 12]. SWE-bench Multilingual에서도 MOPD policy는 59.00%의 mean resolution을 달성, base model 대비 2.78 percentage points 향상되었습니다 [Table 14]. MOPD는 Pooled RL 대비 Pro-618에서 Full resolution을 2.54 percentage points(58.04% vs 55.50%) 개선했으며, SWE-bench Multilingual에서는 3.44 percentage points(59.00% vs 55.56%) 향상시켰습니다 [Table 12, Table 14]. Minimum category lift(dmin)는 Pooled RL 대비 1.53 percentage points, Balanced RL 대비 2.04 percentage points를 기록하여, 모든 category에서 Pareto improvement를 달성했습니다 [Table 13]. Expert-gain recovery는 Pro-A에서 80.8%, Pro-B에서 111.1%, Pro-C에서 84.8%를 기록하며, category expert의 gain이 integrated policy에 성공적으로 반영되었음을 보여줍니다 [Figure 8].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 heterogeneous repository-level SWE tasks를 위한 category-aware expert-training and policy-integration framework를 성공적으로 개발했습니다. SWE Labeler는 evidence-grounded task category를 제공하고, Agentic-miniRL과 RRE(Refresh-Repair-Expand)는 executable-reward learning과 mastery refresh, 그리고 자체 생성 successful trajectory의 replay를 통해 same-origin expert를 개발합니다. 최종적으로 label-routed MOPD는 이러한 expert들을 하나의 deployable policy로 통합합니다.
이 연구는 Pooled RL 및 Balanced RL과 같은 기존 방식 대비 aggregate resolution 및 per-category resolution 측면에서 모두 우수한 성능을 달성했음을 입증합니다. 특히, Pro-618에서 58.04%, SWE-bench Multilingual에서 59.00%의 mean resolution을 기록하며, 모든 세 가지 task category에서 baseline보다 높은 mean resolution을 보였습니다. 이는 category-aware 접근 방식이 SWE agent의 post-training 효율성과 성능을 크게 향상시킬 수 있음을 시사합니다. 다만, Pro-618에서 expert-gain recovery가 category별로 불균일하게 나타난 점은 single-model integration을 더욱 개선할 수 있는 여지를 남깁니다. 이러한 framework는 task category를 post-training을 조직하는 단위로 활용하여, expert gain을 단일 SWE agent에 효과적으로 통합하는 실용적인 목표를 달성하는 데 중요한 기여를 합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWE-World: Building Software Engineering Agents in Docker-Free Environments
- [논문리뷰] SWE-Master: Unleashing the Potential of Software Engineering Agents via Post-Training
- [논문리뷰] MegaFlow: Large-Scale Distributed Orchestration System for the Agentic Era
- [논문리뷰] SWE-RM: Execution-free Feedback For Software Engineering Agents
- [논문리뷰] From Code Foundation Models to Agents and Applications: A Practical Guide to Code Intelligence
Review 의 다른글
- 이전글 [논문리뷰] OmniEdu: Open Foundation Models for Learning and Teaching
- 현재글 : [논문리뷰] One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents
- 다음글 [논문리뷰] Prediction-Powered Smoothing and Validation for Disaggregated AI Evaluation
댓글