[논문리뷰] SciGen-Verifier: A Multimodal Reasoner for Explainable Verification in Scientific Image Generation
링크: 논문 PDF로 바로 열기
저자: Jiali Chen, Zhengteng Lin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 개념은 다음과 같습니다:
- SciGen-Verify: 과학 이미지 생성의 Explainable Verification을 위한 벤치마크로, instruction following, multidisciplinary reasoning, world knowledge 세 가지 영역을 포괄합니다. 이 벤치마크는 binary judgement, explanation, corrective editing instruction으로 구성된 3단계 계층적 프로토콜을 사용합니다.
- SciGen-Verifier: Cold-start Supervised Fine-Tuning (SFT)과 curriculum-based 2단계 Reinforcement Learning (RL) pipeline을 통해 훈련된 8B Multimodal Large Language Model (MLLM) 기반의 추론 중심 검증 모델입니다.
- Explainable Scientific Image Verification: 과학적 이미지 오류를 수정하기 위해 이진 판정(binary judgement), 상세한 설명(explanation), 그리고 실행 가능한 편집 지침(actionable editing instruction)의 세 가지 요소를 포함하는 검증 방식입니다.
- Rubric-guided Reward: RL 훈련의 첫 번째 단계에서 사용되는 process-level reward로, instance-specific scientific rubric에 정의된 체크포인트가 모델의 추론 과정에 명시적으로 언급되었는지 평가하여 포괄적인 추론 탐색을 강화합니다.
- Chain-of-Thought (CoT): 모델이 생성하는 중간 추론 과정으로, 복잡한 과학적 검증 작업에서 논리적 근거를 제공하고 시각적 편집 및 교정을 가능하게 하는 데 필수적인 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 통합 Multimodal Models의 발전으로 과학적 이미지 생성이 가능해졌음에도 불구하고, 이러한 특화된 시각적 결과물의 정확성을 검증하는 데 있어 심각한 병목 현상이 존재한다는 문제에서 출발합니다. 과학 이미지의 오류는 표면적인 artifact보다는 복잡한 domain knowledge, structural reasoning, multi-step instruction에서 비롯되는 경우가 많습니다. 기존의 검증 모델들은 주로 자연 이미지를 대상으로 하며 판단을 scalar score로 압축하기 때문에, 과학적 내용에 대한 포괄적인 검증과 오류 수정을 위한 Explainable Feedback 제공이 미흡했습니다. 단순히 이진 판정(binary judgement)만으로는 과학 다이어그램을 효과적으로 수정하기 어렵습니다. 따라서 검증자는 이미지가 왜 잘못되었는지 명확히 설명하고, 이를 수정하기 위한 구체적인 편집 지침(editing instruction)을 제공해야 합니다. 기존의 Multimodal Verification 벤치마크 및 reward model은 자연 이미지를 위한 것이어서 과학적 구조의 충실도와 domain-specific reasoning을 간과하며, 현재의 과학 이미지 생성 벤치마크는 정적인 오프라인 테스트베드 역할만 할 뿐 Explainable하고 실시간 Feedback을 제공하는 전용 검증 도구가 부족합니다. 이러한 한계점들은 신뢰할 수 있는 과학적 이미지 생성 시스템 구축에 필수적인 반복적인 이미지 수정(iterative image rectification)을 어렵게 만듭니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Explainable Scientific Image Verification을 위해 SciGen-Verifier라는 Multimodal Reasoner를 제안하며, 이는 cold-start Supervised Fine-Tuning (SFT)과 curriculum-based two-stage Reinforcement Learning (RL) pipeline을 통해 훈련됩니다. SFT 단계에서는 SciGen-Verify의 upstream source에서 수집된 48,311개의 훈련 인스턴스를 사용하여 Qwen3-VL-8B-Instruct를 기반으로 모델에 structured reasoning output과 기본적인 verification 능력을 부여합니다. 이어서 RL 단계는 모델의 추론 깊이와 출력 신뢰성을 강화하기 위해 GRPO를 활용한 2단계 curriculum을 적용합니다. Stage 1 RL은 rubric-guided process reward를 사용하여 불완전한 evidence exploration 문제를 해결하고 포괄적인 과학적 추론 탐색을 장려하며, Stage 2 RL은 outcome reward를 통해 최종 judgement, explanation, editing instruction을 ground-truth annotation에 align시킵니다.
SciGen-Verifier는 SciGen-Verify 벤치마크에서 기존의 최첨단 MLLMs보다 우수한 성능을 보여주었습니다. SciGen-Verifier는 8B Backbone 기반임에도 불구하고 전체 Acc_a_에서 86.28%를 달성하며, Qwen3.8-Max (86.03%) 및 GPT-6-Astra (75.71%)와 같은 훨씬 큰 proprietary 모델들을 능가했습니다. 특히, World Knowledge verification 도메인에서는 Acc_a_ 94.21%, Acc_e_ 91.53%, Acc_i_ 65.48%를 기록하여 새로운 State-of-the-Art (SOTA) 성능을 수립했습니다. Chain-of-Thought (CoT) reasoning의 중요성도 확인되었는데, CoT를 통합한 SFT는 Acc_e_와 Acc_i_를 각각 75.3%와 46.7%로 향상시켰으며, CoT와 RL의 시너지는 전체 Acc_a_를 86.3% 및 Acc_i_를 57.4%로 끌어올렸습니다 [Figure 3, cite: 1]. 이는 CoT 단계가 과학적 검증에서 신뢰할 수 있는 수정을 합성하는 데 필수적인 구조적 전제 조건임을 강력히 시사합니다. 또한, 2단계 curriculum RL 훈련의 효과를 분석한 결과 (Table 2), SFT 단독은 Acc_a_ 80.09%, Acc_i_ 46.72%였으나, Stage 1 RL (rubric-guided reward)을 추가했을 때 Acc_a_는 83.62%, Acc_i_는 50.47%로 개선되었습니다. Stage 2 RL (outcome reward)까지 적용하자 최종 Acc_a_는 86.28%, Acc_i_는 57.42%로 더욱 향상되었습니다. 이는 초기 rubric-guided exploration이 과학적 이미지 verification의 잠재력을 극대화하는 데 필수적인 전제 조건임을 확인시켜 줍니다. 제안하는 SciGen-Verifier의 전체 훈련 파이프라인은 [Figure 5]에 자세히 설명되어 있습니다.
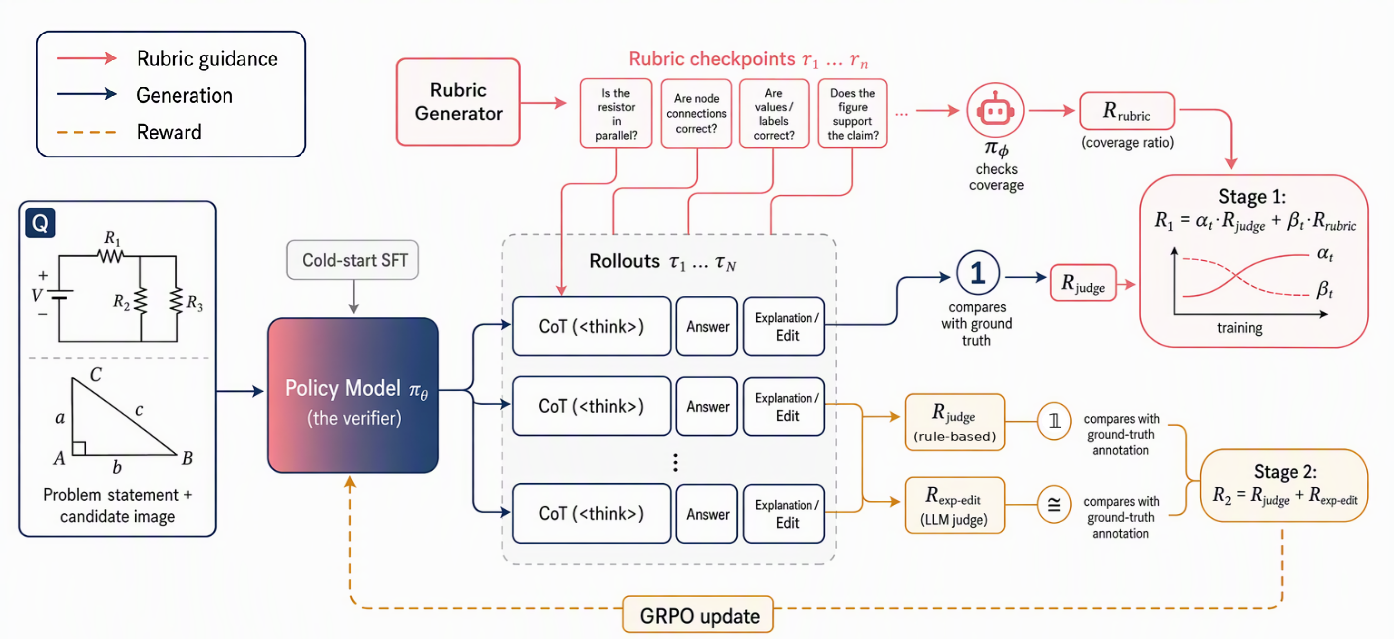
Figure 5 — SciGen-Verifier 훈련 파이프라인 개요
4. Conclusion & Impact (결론 및 시사점)
본 논문은 과학적 이미지 생성의 Explainable Verification이라는 중요한 연구 과제에 집중했습니다. 연구진은 이 검증 작업을 위한 최초의 벤치마크인 SciGen-Verify를 구축했으며, 이는 instruction following, multidisciplinary reasoning, world knowledge 세 가지 대표적인 도메인을 포괄합니다. 또한, rubric-guided process reward를 통해 추론 탐색을 강화하고 outcome reward를 통해 ground-truth에 align하는 curriculum-based two-stage Reinforcement Learning pipeline을 사용하여 SciGen-Verifier 모델을 개발했습니다. 광범위한 실험을 통해 명시적 추론(explicit reasoning)과 curriculum-based reinforcement learning이 필수불가결함을 확인했으며, SciGen-Verifier가 반복적인 이미지 수정(iterative image rectification) 과정에서 효과적인 online critic으로 기능할 수 있음을 입증했습니다 [Figure 4, cite: 1]. 이 연구는 8B 규모의 SciGen-Verifier가 훨씬 큰 proprietary 모델들과 대등하거나 더 뛰어난 성능을 보여주며, 학계 및 산업계에서 Large Multimodal Models (MLLMs)의 과학적 응용 분야 신뢰성을 크게 향상시킬 잠재력을 가집니다.
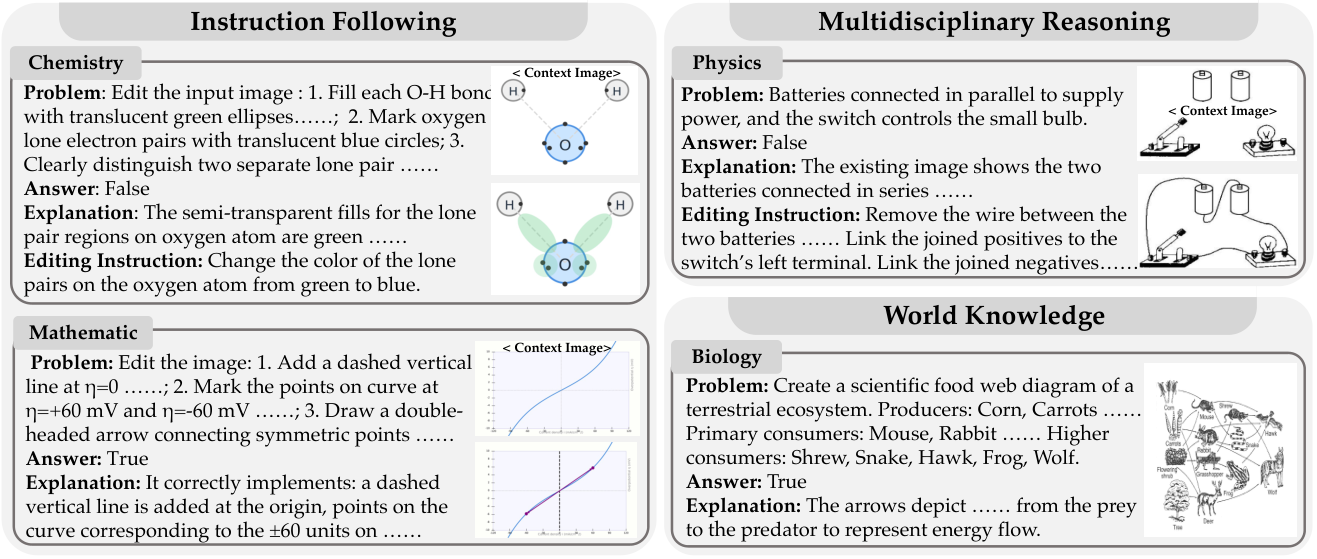
Figure 1 — SciGen-Verify 벤치마크 개요
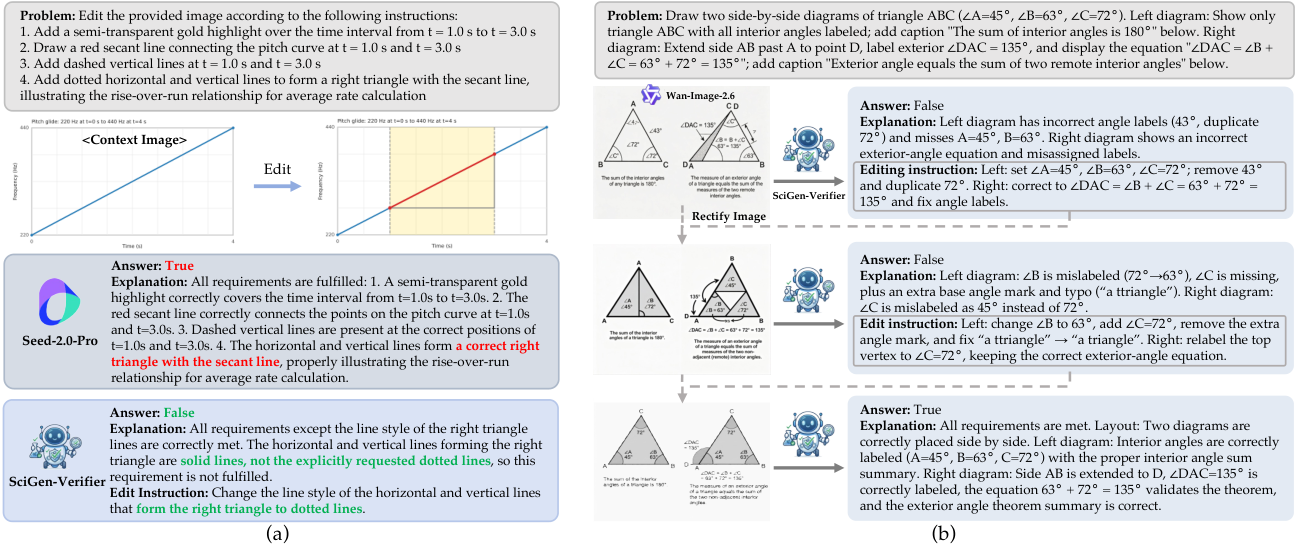
Figure 4 — SciGen-Verifier 사례 연구
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ProactiveBench: Benchmarking Proactiveness in Multimodal Large Language Models
- [논문리뷰] V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
- [논문리뷰] MBA: Multimodal Benchmark and Agents for Real-World Business Ideation
- [논문리뷰] WorldBench: A Challenging and Visually Diverse Multimodal Reasoning Benchmark
- [논문리뷰] VideoKR: Towards Knowledge- and Reasoning-Intensive Video Understanding
Review 의 다른글
- 이전글 [논문리뷰] RoboFoundry: System-as-Policy Evolution for Self-Learning Embodied Agents
- 현재글 : [논문리뷰] SciGen-Verifier: A Multimodal Reasoner for Explainable Verification in Scientific Image Generation
- 다음글 [논문리뷰] Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
댓글