[논문리뷰] HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
링크: 논문 PDF로 바로 열기
저자: Tongbo Chen, Junbo Niu, Zhengxi Lu, Niu Lian, Fei Tang, Yuchen Yan, Yike Hong, Yong Du, Yizhou Liu, Bofan Chen, Yongliang Shen
1. Key Terms & Definitions (핵심 용어 및 정의)
- CUA (Computer-Use Agent): 디지털 태스크를 수행하기 위해 컴퓨터와 상호작용하는 agent를 지칭합니다.
- GUI (Graphical User Interface): visual interaction을 통해 이루어지는 전통적인 사용자 인터페이스 상호작용 방식입니다.
- CLI (Command Line Interface): shell 명령어를 통해 programmatic operations을 수행하는 텍스트 기반 인터페이스입니다.
- SFT (Supervised Fine-Tuning): 구성된 trajectory 데이터셋을 활용하여 모델을 초기 학습시키는 단계입니다.
- RLVR (Reinforcement Learning with Verifiable Rewards): task completion과 CLI 사용 효율성에 대한 verifiable rewards를 통해 online interaction으로 모델을 최적화하는 Reinforcement Learning 프레임워크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Computer-Use Agents (CUAs)는 GUI 상호작용에만 의존하거나 application-specific API 또는 tool을 사용하여 task를 수행하지만, 이러한 방식은 비효율적이거나 확장성이 떨어진다는 핵심 문제에 직면해 있습니다. GUI-only interaction은 long action sequence에서 cascading errors가 발생하기 쉬워 느리고 오류가 잦으며, application-specific API나 tool은 상당한 engineering effort가 필요하고 다양한 application에 걸쳐 확장하기 어렵습니다. [Figure 2a]에서 나타나듯이, CLI interface가 노출되었을 때 기존 agent들의 OSWorld 정확도가 2.5%에서 11.5 percentage points까지 감소하는 것은 현재 모델들이 task 실행 중 언제, 그리고 어떻게 CLI를 효과적으로 사용해야 하는지 모른다는 한계점을 명확히 보여줍니다. 이는 CUA가 GUI의 generality와 CLI의 efficiency를 결합하는 hybrid interaction이 필요하지만, 현재 training data와 supervision은 이러한 hybrid behavior를 가르치지 못한다는 근본적인 training gap에서 비롯됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 GUI와 CLI를 orchestration하는 HybridCUA라는 unified data 및 training framework를 제안합니다. 제안하는 방법론은 GUI와 CLI 상호작용을 통합하는 bash action space를 사용하며, [Figure 3a]에 제시된 것처럼 세 가지 유형의 trajectory를 생성하는 scalable data construction pipeline을 통해 HybridCUA-8K 데이터셋을 구축합니다. 이 데이터셋은 5,000개의 hybrid trajectory와 3,000개의 verified RLVR task를 포함하며, CLI 사용이 명확한 실행 이점을 제공하는지 여부로 labeling됩니다. Training은 두 단계로 진행되는데, 첫 번째는 구축된 trajectory에 대한 SFT이며, 두 번째는 CLI-aware rewards를 사용하는 RLVR입니다. RCLI (task-level reward)는 CLI를 언제 호출해야 하는지 가르치고, Rexec (action-level reward)는 terminal feedback을 통해 명령어의 reliability를 향상시키는 방법을 가르칩니다.
실험 결과, HybridCUA-9B 모델은 OSWorld에서 53.6%의 accuracy를 달성하여 base model 대비 14.8 percentage points의 성능 향상을 보였습니다 [Table 1]. 또한, WindowsAgentArena에서 4.0 percentage points의 성능 향상을 이루어 cross-platform generalizability를 입증했습니다. HybridCUA-9B는 OSWorld task의 64.0%에서 CLI를 활용하며, [Figure 2b]에서 보이듯이 기존 agent들의 CLI step share가 크게 다른 반면 HybridCUA는 CLI를 선별적으로 사용하여 efficiency를 높입니다. RL 단계를 통해 accuracy는 46.0%에서 53.6%로 증가하고, 평균 step 수는 19.8에서 14.0으로 감소하며 29.3%의 trajectory 길이 단축 효과를 보였습니다. ablation study에서는 RCLI 제거 시 CLI 사용률이 64.0%에서 58.9%로 감소하여 CLI 선택 시점 학습의 중요성을 확인했으며, Rexec 제거 시 execution errors가 11.5%에서 16.5%로 증가하여 명령어 실행 reliability 학습의 중요성을 입증했습니다.
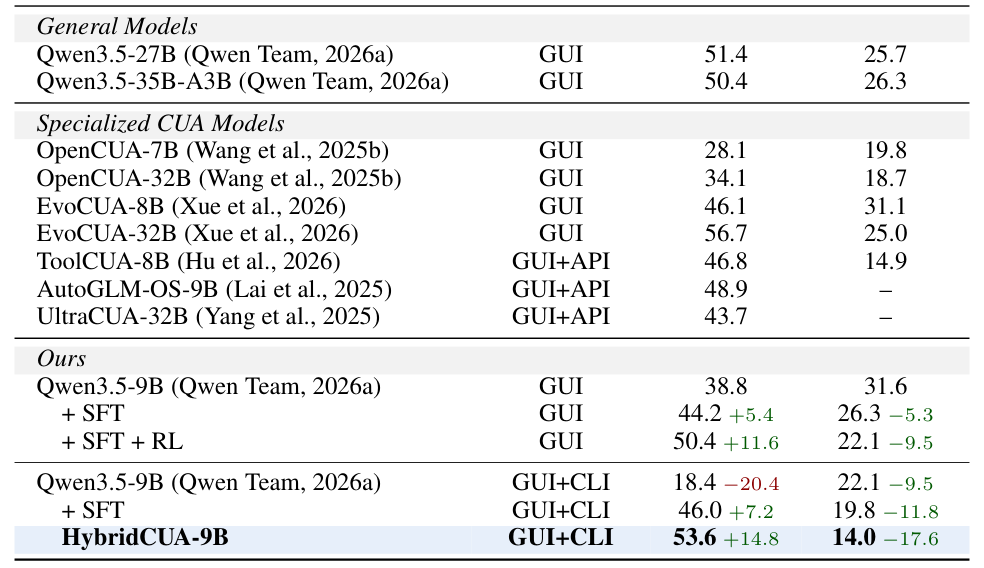
Table 1 — OSWorld 벤치마크에서 HybridCUA 모델과 다양한 Baseline 모델들의 주요 정량적 성능(Accuracy, Avg. Steps)을 비교하는 핵심 결과 Table.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 GUI와 CLI 상호작용을 효과적으로 통합하는 HybridCUA 프레임워크가 computer-use agents의 성능을 크게 향상시킬 수 있음을 보여줍니다. HybridCUA는 GUI의 generality와 CLI의 efficiency를 결합하여 task completion과 interaction efficiency를 모두 개선했습니다. 특히, CLI-aware rewards를 통한 online reinforcement learning은 agent가 CLI를 언제, 어떻게 사용해야 하는지에 대한 중요한 지식을 습득하도록 유도했습니다. 이러한 결과는 cross-platform generalizability를 포함하며, GUI와 CLI가 상호보완적인 기능을 제공하고 이를 효과적으로 orchestration하는 학습이 정확하고 효율적이며 일반화 가능한 computer-use agents를 위한 유망한 방향임을 시사합니다.
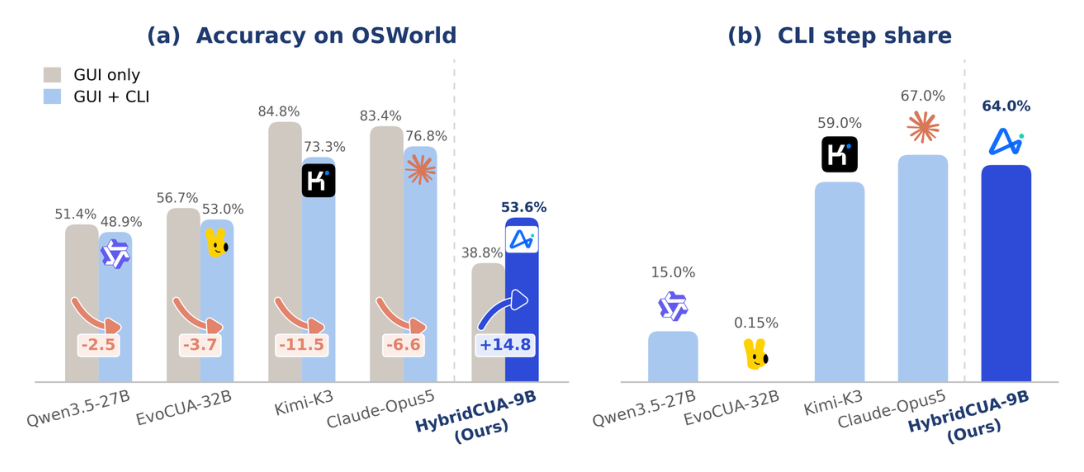
Figure 2 — GUI-CLI 오케스트레이션 문제를 정량적으로 제시하고, 기존 모델의 한계점 및 제안 모델의 우수성을 보여주는 핵심 Figure.
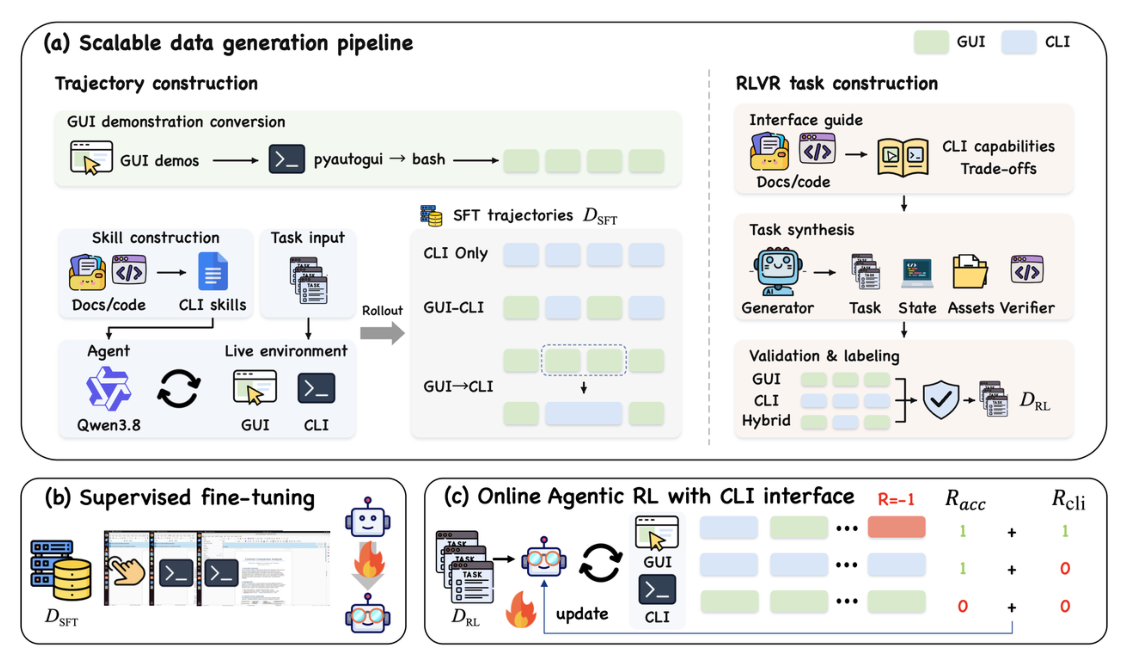
Figure 3 — HybridCUA의 데이터 생성 파이프라인과 트레이닝 프레임워크를 시각적으로 보여주는 핵심 다이어그램.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Echoverse: Deep, Evolving Environments for Training Computer-Use Agents at Scale
- [논문리뷰] Beyond SFT-to-RL: Pre-alignment via Black-Box On-Policy Distillation for Multimodal RL
- [논문리뷰] REDSearcher: A Scalable and Cost-Efficient Framework for Long-Horizon Search Agents
- [논문리뷰] MoRL: Reinforced Reasoning for Unified Motion Understanding and Generation
- [논문리뷰] Innovator-VL: A Multimodal Large Language Model for Scientific Discovery
Review 의 다른글
- 이전글 [논문리뷰] HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
- 현재글 : [논문리뷰] HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
- 다음글 [논문리뷰] In-Context Learning for Robots: Methods and Applications
댓글