[논문리뷰] TabFM: A Zero-Shot Foundation Model for Tabular Data
링크: 논문 PDF로 바로 열기
저자: Weihao Kong, Erez Louidor Ilan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문은 Tabular Data를 위한 Foundation Model인 TabFM과 그 확장 모델을 제안한다.
- Foundation Model (FM): 광범위한 데이터셋으로 미리 학습되어 다양한 다운스트림 태스크에 전이 학습될 수 있는 대규모 모델. Tabular Data 맥락에서는 데이터셋별 튜닝 없이 여러 테이블 데이터셋에 일반화될 수 있는 모델을 의미한다.
- Zero-Shot Prediction: 특정 태스크에 대한 추가적인 튜닝(fine-tuning) 없이 모델이 새로운 데이터셋에 대해 직접 예측을 수행하는 능력이다. TabFM은 단 한 번의 forward pass로 이를 달성한다.
- In-Context Learning (ICL): 모델이 명시적인 가중치 업데이트 없이 프롬프트에 포함된 예시로부터 태스크를 학습하는 방식이다. TabFM은 지도 학습 tabular prediction을 in-context learning으로 공식화한다.
- TabArena: 38개의 분류(classification) 및 13개의 회귀(regression) 데이터셋으로 구성된 51개 벤치마크 데이터셋을 포함하는 Tabular Machine Learning 평가 플랫폼이다. Bradley–Terry Elo Rating을 통해 모델 성능을 비교한다.
- Structural Causal Model (SCM): 데이터의 구조적 의존성을 모델링하여 synthetic table을 생성하는 데 사용되는 모델이다. TabFM은 SCM에서 생성된 synthetic data로만 pretraining되었다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Tabular Machine Learning은 데이터셋별 워크플로우에 크게 의존하여 새로운 태스크마다 custom preprocessing, hyperparameter search, 및 모델 튜닝을 처음부터 수행해야 하는 한계가 있었다. Tree Ensembles는 혼합된 컬럼 타입, 결측치, 불규칙한 feature scale에 효과적이지만, 이러한 'per-dataset optimization' 패러다임은 학습을 재현하고 확장하는 데 비효율적이다. Transformer 기반의 In-Context Learning (ICL) 접근 방식은 단일 forward pass로 학습을 상각(amortize)하여 이러한 비효율성을 해결할 수 있지만, tabular data의 고유한 구조적 제약(행의 교환성, 이질적인 컬럼 타입, Quadratic Attention Complexity)으로 인해 대규모 테이블에 적용하기 어려웠다. 특히, naive attention은 행과 컬럼 수에 대해 O(T^2 * H^2)의 복잡도를 가지므로, 기존 tabular transformer는 1,000개 미만의 행으로 제한되었다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
TabFM은 400M-parameter Transformer 모델로, in-context learning을 통해 지도 학습 tabular prediction을 수행한다 [Figure 2]. 이 모델은 spectral cell embedding, alternating column-wise 및 row-wise attention, CLS pooling, 그리고 deep in-context prediction의 네 가지 단계로 구성된다 [Table 1]. Feature Grouping과 Learned Fourier Frequencies를 활용한 Cell Embedder는 수치형 및 범주형 컬럼을 효과적으로 임베딩하며, dyadic offsets를 사용하여 지역적인 cross-feature interaction을 포착한다. Attention Foundations는 Induced Self-Attention Blocks (ISAB)를 통한 Column-wise Attention과 Rotary Position Embeddings (RoPE)를 활용한 Row-wise Self-Attention Blocks (SAB)를 교차로 사용하여 O(THmE) 및 O(TH^2E)의 선형에 가까운 복잡도로 각각 행 및 feature interaction을 처리한다. 24개 레이어로 구성된 In-Context Learning Predictor는 16,384개의 instance까지 context를 확장하여, 기존 모델 대비 한 자릿수 이상의 대규모 테이블 처리가 가능하다.
TabFM은 Structural Causal Models (SCMs)로부터 생성된 Synthetic Tables로만 pretraining되었으며, Curriculum Learning을 통해 context size를 2,048개에서 16,384개 instance로 점진적으로 확장하며 학습되었다 [Figure 3]. TabArena 벤치마크에서 51개 데이터셋(38개 분류, 13개 회귀)을 대상으로 Zero-Shot 성능을 평가한 결과, TabFM은 TabArena Elo Rating에서 default tabular foundation model 중 1위를 기록했다 [Table 2]. 특히, Zero-Shot TabFM은 분류 태스크에서 1768.6 Elo를 달성하며 EXAONE-Tabular (1768.0 Elo) 및 AutoGluon 1.5 extreme (1669.7 Elo)을 앞섰고, 회귀 태스크에서는 2055.2 Elo로 역시 EXAONE-Tabular (1973.1 Elo)보다 우수했다 [Figure 4]. TabFM은 분류 및 회귀 모두에서 가장 낮은 geometric-mean error (각각 0.0957, 16.40)와 가장 낮은 oracle improvability (각각 6.10%, 2.62%)를 보였다.
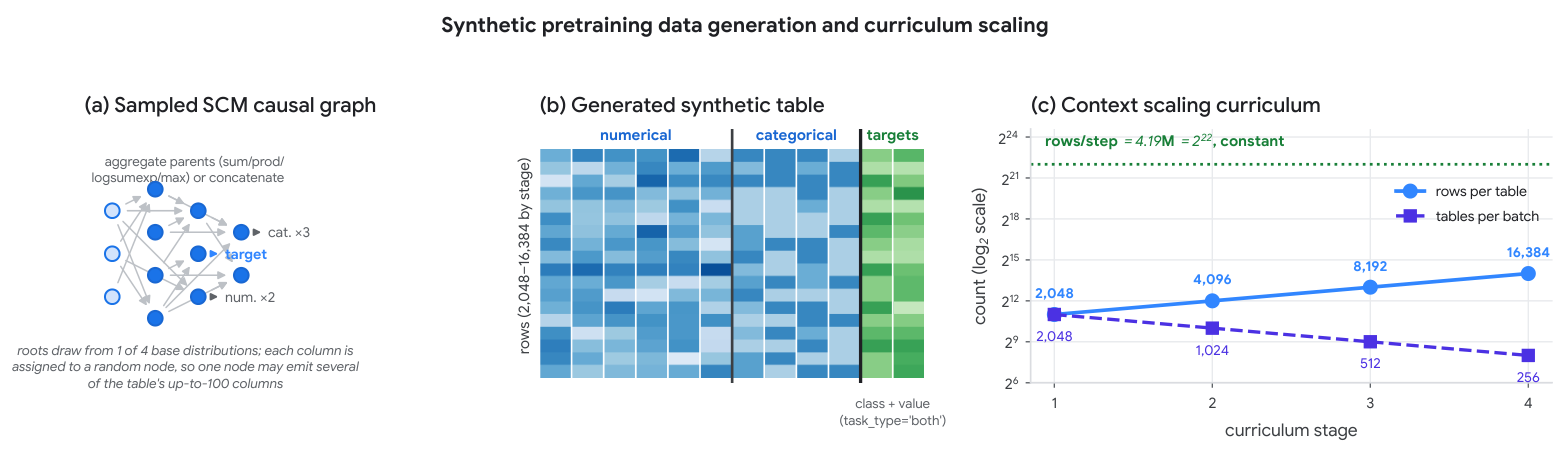
Figure 3 — Synthetic Pretraining 데이터 및 Curriculum
TabFM 위에 구축된 두 가지 확장 모델, TabFM+와 TabFM-Auto는 frozen weights를 유지하면서 추가적인 성능 향상을 달성했다. TabFM+는 multi-view feature expansion, ensembling, 및 post-hoc calibration을 통해 분류에서 1838.0 Elo, 회귀에서 2189.2 Elo를 기록하며 전체 2위를 차지했다. TabFM-Auto는 Gemini-3.8-Flash LLM을 활용한 dataset-specific feature engineering을 통해 분류에서 1940.7 Elo, 회귀에서 2392.4 Elo를 달성하며 TabArena 전체 1위를 차지했다 [Figure 1, Figure 6]. TabFM-Auto는 51개 데이터셋 중 41개에서 base TabFM 대비 성능을 향상시켰으며, 특히 회귀 태스크에서는 모든 13개 데이터셋에서 성능이 개선되었고, 0.00% oracle improvability를 달성했다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Structural Causal Models에서 생성된 synthetic tables만으로 pretraining된 400M-parameter Transformer인 TabFM을 통해 tabular data에 대한 in-context learning 기반 zero-shot prediction의 가능성을 제시한다. TabFM은 TabArena 벤치마크에서 default foundation model 중 가장 우수한 성능을 보여주며, 기존의 per-dataset optimization 패러다임의 한계를 극복하고 범용적인 tabular representation 학습의 새로운 방향을 제시한다. TabFM의 확장 모델인 TabFM+ (inference-time ensembling 및 feature expansion)와 TabFM-Auto (LLM-guided feature engineering)는 모델 가중치를 업데이트하지 않고도 추가적인 성능 향상을 가져와, zero-shot foundation model의 실용성과 잠재력을 입증했다. 이 연구는 tabular data 분야에서 대규모 pretraining 모델의 새로운 가능성을 열고, 데이터셋별 튜닝 없이도 높은 성능을 달성할 수 있음을 보여줌으로써, 학계와 산업계 모두에 significant impact를 미칠 것으로 기대된다. 향후 연구는 million-row 및 thousand-column 테이블로의 확장, multimodal data 통합, 그리고 feature discovery를 pretraining 프로세스에 직접 통합하는 방안을 포함할 수 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting
- [논문리뷰] Scaling Native Multimodal Pre-Training From Scratch
- [논문리뷰] Timer-S1: A Billion-Scale Time Series Foundation Model with Serial Scaling
- [논문리뷰] Large Multimodal Models as General In-Context Classifiers
- [논문리뷰] MuSc-V2: Zero-Shot Multimodal Industrial Anomaly Classification and Segmentation with Mutual Scoring of Unlabeled Samples
Review 의 다른글
- 이전글 [논문리뷰] TGRL: Temperature-Grouped Reinforcement Learning for Efficient Exploration in LLMs
- 현재글 : [논문리뷰] TabFM: A Zero-Shot Foundation Model for Tabular Data
- 다음글 [논문리뷰] Think Before You Score: Thinking Reward Model for Visual Generation
댓글