[논문리뷰] AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hongjin Qian, Chaofan Li, Kun Luo, Wenqing Wei, Jianlyu Chen, Shuqi Lu, Yuyang Hu, Hongwang Xiao, Hui Wang, Chaozhuo Li, Qiwei Ye, Zhicheng Dou, Defu Lian, Zheng Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Long-Horizon Reflection: 에이전트가 단일 작업 내에서 여러 차례의 시행착오와 피드백을 통해 솔루션을 반복적으로 개선하는 메타 기술(meta-skill).
- Test-Time Scaling: 모델이 추론 단계에서 더 많은 라운드(budget)를 사용할수록 성능이 향상되는 현상을 활용하여 문제 해결 능력을 스케일링하는 기법.
- Operational Knowledge: 에이전트가 환경(API, 라이브러리, 데이터 구조 등)을 이해하고 활용하기 위해 작업 과정에서 습득하는 실행 지식.
- MLE-bench Lite: 머신러닝 엔지니어링 워크플로우(데이터 분석, 실험, 모델 평가 등)의 복잡성을 측정하는 벤치마크.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 에이전트가 단일 작업 내에서 스스로 솔루션을 개선하는 Self-improvement 능력이 부족하다는 문제를 해결한다. 기존 모델들은 대부분 단일 시도로 작업을 완수하는 데 초점을 맞추고 있으며, 복잡한 문제 해결을 위한 필수 과정인 '측정-분석-수정'의 루프를 외부 스캐폴드(scaffold)에 의존하고 있다. 이러한 방식은 긴 호흡의 개선 과정을 반영하지 못하며, 성공한 결과물 위주의 학습 데이터는 에이전트가 실패 후 회복하거나 반복적으로 개선하는 능력을 저해한다. 따라서 본 연구는 이러한 루프를 모델 내부로 내재화하여, 더 많은 라운드를 거칠수록 성능이 향상되는 자가 개선 에이전트 AREX-2를 제안한다 [Figure 3].
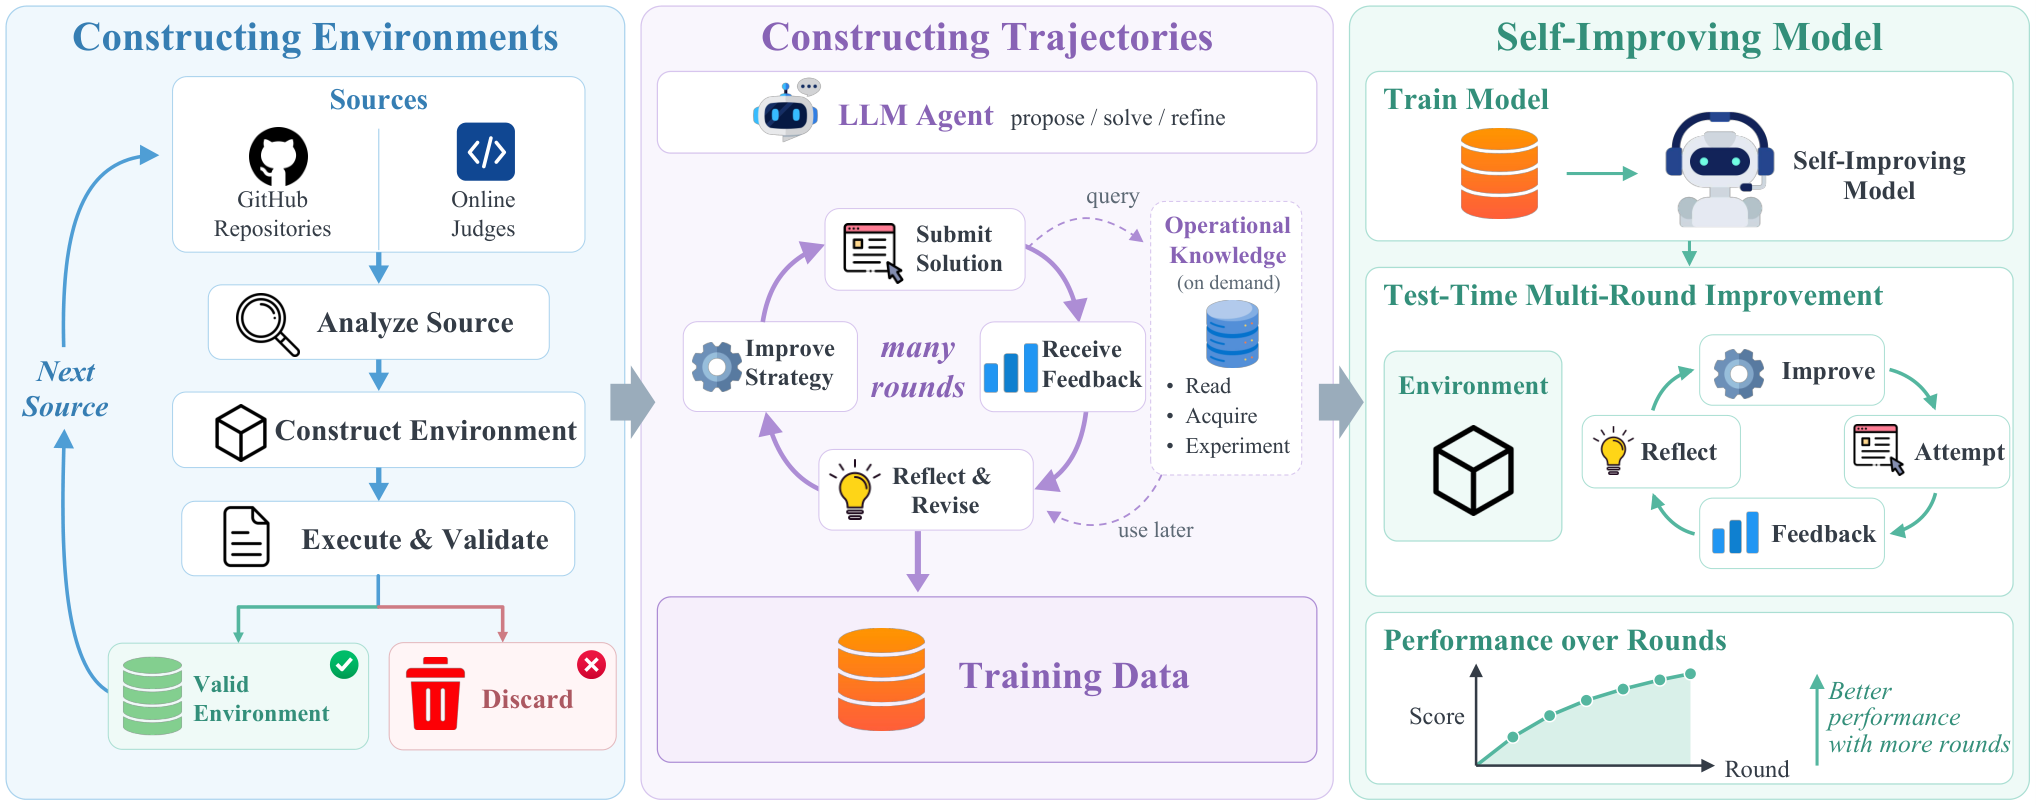
Figure 3 — AREX-2 아키텍처 및 개선 과정
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 머신러닝 엔지니어링과 알고리즘 프로그래밍 분야에서 검증 가능한 피드백 데이터를 활용하여 AREX-2를 학습시키는 방법론을 제안한다. 저자들은 환경을 구축하고, 에이전트가 작업 과정에서 습득하는 실패, 회복, 재실험 등의 모든 과정을 기록한 긴 호흡의 개선 궤적(long-horizon improvement trajectories)을 생성하였다. Qwen3.8-27B를 기반으로 학습된 AREX-2는 MLE-bench Lite에서 81.8점, Frontier-CS에서 70.7점을 기록하며 비교 대상 모델들 중 최상위 성능을 달성하였다 [Table 1]. 특히, 새로운 학습 데이터 추가 없이 수행된 BrowseComp 및 DeepSearchQA 등 딥 리서치 벤치마크에서도 각각 84.0점과 93.8점을 기록하며 기존 모델 대비 강력한 범용 성능을 입증하였다 [Table 2]. 정량적 지표 분석 결과, AREX-2는 예산(round budget)이 늘어남에 따라 꾸준히 성능이 향상되는 Test-time scaling 능력을 확실히 보여주었다 [Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 모델 내부로 개선 루프를 이식함으로써 에이전트의 Self-improvement 능력을 극대화할 수 있음을 입증하였다. 실험 결과, 27B 규모의 모델이 롱 호라이즌 환경에서 거대 모델들을 압도하거나 대등한 성능을 보인 것은 이 연구의 핵심적인 성과이다. 본 연구는 에이전트 분야에서 단순히 '정답을 맞히는' 능력을 넘어 '문제를 스스로 해결해 나가는' 과정 중심적 학습이 차세대 모델의 방향성임을 시사한다. 향후 연구에서는 더욱 다양한 도메인으로 학습 환경을 확장하고, 모델이 생성한 궤적을 다시 학습 데이터로 사용하는 순환적 개선이 주요 과제가 될 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Hybrid Reasoning Agents
- [논문리뷰] Inducing Process Supervision from Outcome-Only Reinforcement Learning
- [논문리뷰] Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals
- [논문리뷰] From Pareto to Preference: Personalized Test-Time Scaling via Amortized Agentic Policy Discovery
- [논문리뷰] DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
Review 의 다른글
- 이전글 [논문리뷰] AIM: Agentic Idea Management for Automated Research
- 현재글 : [논문리뷰] AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
- 다음글 [논문리뷰] AdviSD: Learning to Advise Frontier LLMs via Targeted Multi-Turn Self-Distillation
댓글