[논문리뷰] It's Not What the Image Shows: Irrelevant Context Destabilises VLM Judges Without Informing Them
링크: 논문 PDF로 바로 열기
메타데이터
저자: Nagham Omar, Mahmoud Jabarin, Kinan Ibraheem, Lotem Peled-Cohen
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- MIST (Misleading-Image Stress Test): 모델이 이미지를 무시하라는 지시를 받았을 때, 무관한 이미지가 모델의 판단에 미치는 영향을 측정하기 위해 설계된 200개의 영어 관용구 기반 평가 데이터셋입니다.
- VLM Judges: 인간 어노테이터를 대체하여 자연어 처리 태스크의 성능을 평가하는 Vision-Language Models입니다.
- Alt-test (Alternative annotator test): VLM Judge가 인간 패널과 통계적으로 유의미한 수준으로 일치하는지 평가하여 인간을 대체할 수 있는지 판단하는 테스트 프로토콜입니다.
- Substitutability: 인간 어노테이터의 판단을 모델로 대체했을 때, 해당 판단이 인간의 평가와 동등하게 신뢰할 수 있는지를 나타내는 지표입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
- 본 논문은 VLM이 인간 어노테이터를 대체하는 상황에서, 과업 수행과 무관한 배경 이미지(Irrelevant Context)가 모델의 판단 결과에 의도치 않은 영향을 미치는 문제를 해결하고자 합니다.
- 기존의 substitutability 평가 방법론은 단일 환경에서의 결과만을 측정하며, 문맥 변화에 대한 모델의 로버스트성을 제대로 검증하지 못한다는 한계가 있습니다.
- 특히 모델이 이미지를 무시하라는 명시적 지시에도 불구하고, 이미지의 존재 여부와 내용에 따라 판단이 흔들리는 것은 모델이 평가자로서 갖추어야 할 불변성(Invariance)을 훼손하는 심각한 위협입니다.
- 본 연구는 4가지 조건으로 구성된
[Figure 1]을 활용하여 이미지가 모델의 판단에 미치는 간섭 효과를 정밀하게 분석합니다.
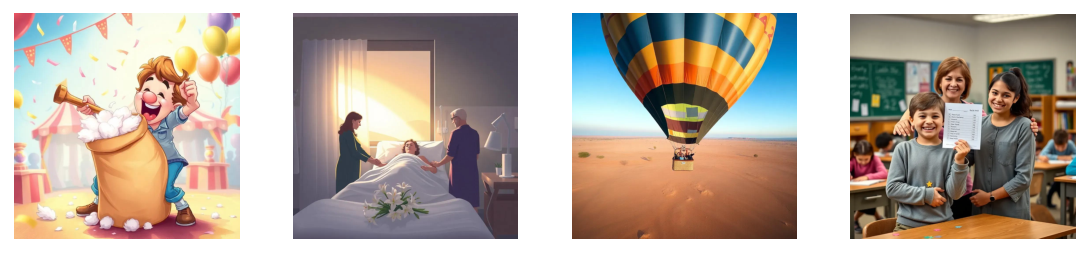
Figure 1 — 이미지 정렬 조건에 따른 4가지 실험 환경을 시각적으로 명확히 설명함
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
- 본 논문은 200개의 관용구 데이터를 사용하여 문장 의미와 일치하거나(Aligned), 반대되는(Misleading) 이미지를 제시하고, 모델이 이미지를 무시하라는 지시를 준수하는지 테스트하는 프레임워크를 제안합니다.
- 총 13개의 VLM을 zero-shot, few-shot, chain-of-thought (CoT) 등 다양한 프롬프트 기법과 결합하여 평가하였으며, 이미지를 무시하라는 explicit arm과 언급하지 않는 silent arm을 교차 검증하였습니다.
- 실험 결과, 모든 모델에서 이미지의 삽입은 15.9%(aligned) 또는 14.7%(misleading) 수준으로 레이블 변경을 야기하며, 이는 프롬프트 수정(prompt edit)에 따른 변동폭인 8.8%보다 훨씬 높은 수치로 나타났습니다
[Table 1]. - 또한, 이미지의 내용이 관용구의 의미를 반영하는지 여부와 상관없이 무작위적인 변경이 빈번하게 발생하며, 이러한 Instability는 테스트를 통과한 7개 모델을 포함한 모든 실험군에서 공통적으로 발견되었습니다.
- 이는 VLM Judge가 특정 상황에서만 Substitutability 테스트를 통과할 뿐, 실제 환경의 미세한 문맥적 변화에는 매우 취약함을 정량적으로 입증합니다.
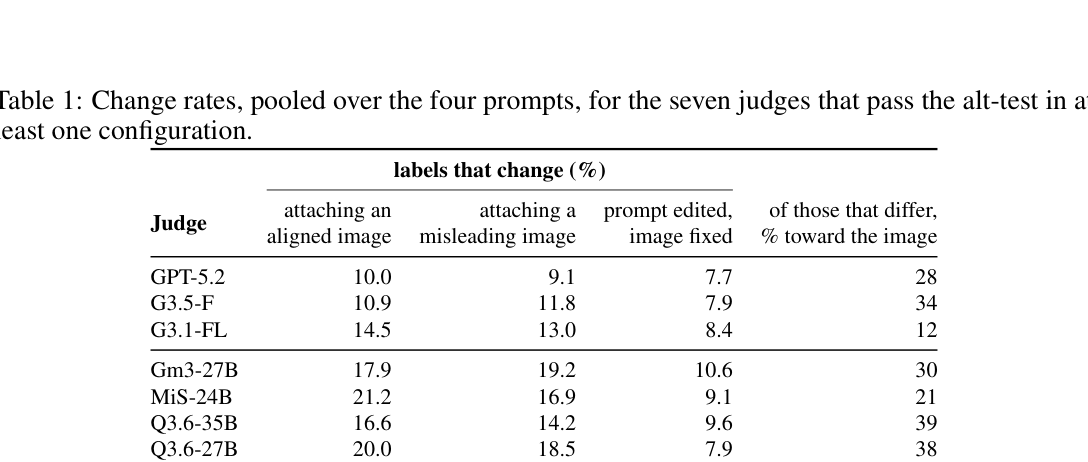
Table 1 — 다양한 모델별 이미지 삽입 시 레이블 변경률을 보여주는 핵심 실험 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점)
- 본 연구는 VLM Judge가 단순히 문맥을 처리하는 것을 넘어, 무관한 시각 정보에 의해 무의식적으로 판단이 왜곡되는 '불안정한 상태'에 놓여 있음을 밝혀냈습니다.
- 이러한 결과는 인간 평가자를 모델로 대체할 때, 단순히 단일 벤치마크 점수만으로 substitutability를 보장할 수 없으며, 다양한 컨텍스트 변화에 대한 로버스트성 평가가 필수적임을 시사합니다.
- 연구진은 MIST 데이터셋과 어노테이션 결과를 공개함으로써, 향후 모델의 판단 일관성을 개선하고 보다 신뢰할 수 있는 AI 평가 체계를 구축하는 데 중요한 토대를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
- [논문리뷰] Visual Grounding Safety in Vision-Language Models
- [논문리뷰] SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
- [논문리뷰] VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
- [논문리뷰] Improving Proactive AI Assistance with Hierarchical Procedural Understanding
Review 의 다른글
- 이전글 [논문리뷰] I Have a Stream: Making Self-Supervised Learning Work on Continuous Video
- 현재글 : [논문리뷰] It's Not What the Image Shows: Irrelevant Context Destabilises VLM Judges Without Informing Them
- 다음글 [논문리뷰] Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI
댓글