[논문리뷰] LoopVL: Recurrent Visual Intelligence
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zhe Qian, Ziyang Gong, Zhongxing Xu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Module-Loop: 전체 Transformer 레이어 스택을 반복적으로 적용하여 모델의 계산 깊이를 증가시키는 기법입니다.
- Model-Loop: Coupled L/H 업데이트 주기를 반복하여 고수준 상태(High-level state)를 점진적으로 갱신하는 구조입니다.
- LoopVL: Module-Loop와 Model-Loop를 결합하여 비전-언어 상태를 반복적으로 업데이트하는 recurrent vision-language 모델입니다.
- Visual Aha Moment: 반복적인 루프 과정에서 초기에는 주목받지 못했던 시각적 영역이 특정 루프 단계에서 강조되는 현상을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 recurrent computation을 비전-언어 모델에 효과적으로 확장하여 연산 효율성과 추론 성능을 극대화하는 것을 목적으로 합니다. 기존의 독립적인 Transformer 레이어 스택은 모델의 깊이를 늘리기 위해 파라미터 수를 비례적으로 증가시켜야 하는 한계가 있습니다. 반면, 시각 정보는 공간적 구조를 가지고 있어 반복적인 상태 갱신을 통한 추론이 필수적이지만, 기존 연구들은 주로 언어 모델에 집중되어 왔습니다. 저자들은 비전-언어 모델에서도 공유된 파라미터를 사용하여 깊은 다중 모달 연산을 수행하는 LoopVL 아키텍처를 제안합니다 [Figure 2].
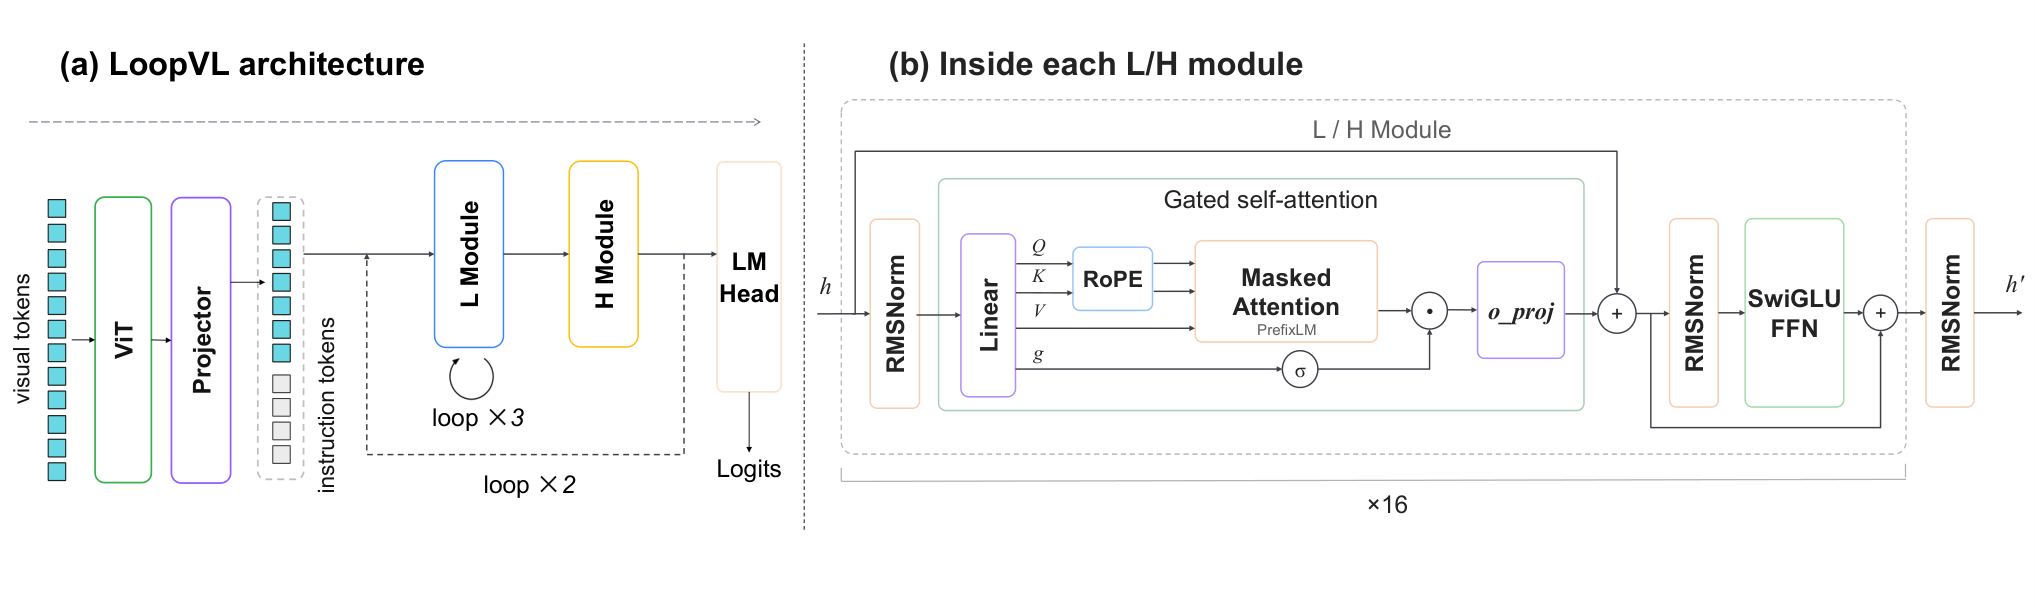
Figure 2 — LoopVL 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
LoopVL은 공유된 파라미터를 갖는 L/H 모듈을 반복적으로 적용하는 계층적 recurrent 구조를 채택합니다. 제안 모델은 비전-언어 입력을 고정된 Penguin Vision Encoder를 통해 처리하며, 학습 가능한 비전 인터페이스를 통해 recurrent 백본으로 전달합니다 [Figure 2]. 학습 과정은 언어 사전 학습, 시각-언어 정렬, 다중 모달 중간 학습, 그리고 SFT 및 시각적 Reinforcement Learning을 포함하는 체계적인 파이프라인으로 구성됩니다 [Figure 5]. 실험 결과, LoopVL-1B는 동일한 학습 데이터 예산 내에서 32층의 Transformer-VL 1B 베이스라인을 모든 벤치마크에서 큰 폭으로 상회하며, 훨씬 더 큰 규모의 dense Transformer 모델들과 경쟁력 있는 성능을 보입니다. 구체적으로 MMStar 벤치마크에서 LoopVL은 63.47점을 기록하여 베이스라인의 55.33점 대비 유의미한 성능 향상을 입증했습니다 [Table 1]. 또한, 반복적인 연산이 수행됨에 따라 시각적 주의가 재분배되는 Visual Aha Moment 현상을 관찰하여, 모델이 루프를 거치며 시각적 정보를 지속적으로 재구성하고 재사용함을 확인했습니다.
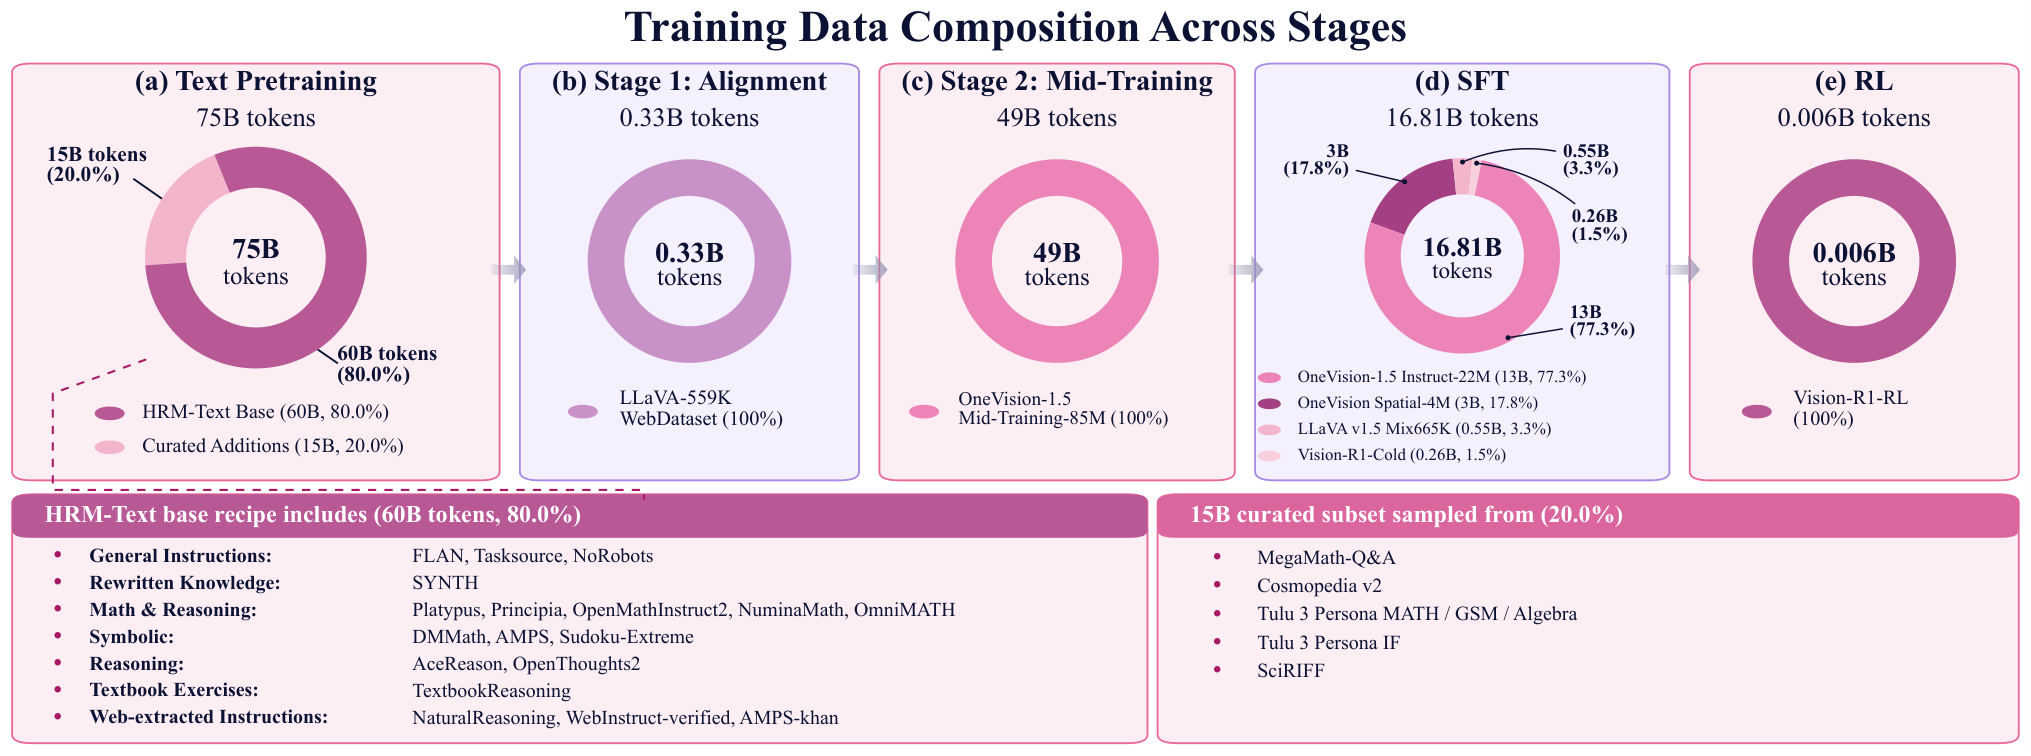
Figure 5 — 학습 데이터 및 워크플로우
4. Conclusion & Impact (결론 및 시사점)
본 논문은 recurrent Transformer가 비전-언어 모델에도 성공적으로 확장될 수 있음을 실증적으로 증명하였습니다. LoopVL은 파라미터 효율적인 설계를 통해 제한된 자원 내에서도 복잡한 시각적 추론을 가능하게 하며, 시각적 상태가 루프를 통해 진화하는 과정을 해석 가능한 형태로 제시하였습니다. 이 연구는 대규모 모델의 파라미터 증가 없이도 심층적인 다중 모달 연산을 가능하게 하는 실용적인 프레임워크를 제공하여, 향후 효율적인 비전-언어 인텔리전스 설계에 중요한 이정표가 될 것으로 평가됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Decouple to Generalize: Context-First Self-Evolving Learning for Data-Scarce Vision-Language Reasoning
- [논문리뷰] VisPlay: Self-Evolving Vision-Language Models from Images
- [논문리뷰] More Thought, Less Accuracy? On the Dual Nature of Reasoning in Vision-Language Models
- [논문리뷰] RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
- [논문리뷰] Visual Grounding Safety in Vision-Language Models
Review 의 다른글
- 이전글 [논문리뷰] Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI
- 현재글 : [논문리뷰] LoopVL: Recurrent Visual Intelligence
- 다음글 [논문리뷰] Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
댓글