[논문리뷰] OmniConfess: Eliciting Token Confessions to Mitigate Omni-Modal Hallucination
링크: 논문 PDF로 바로 열기
저자: Huiqiang Rong, Haoran Luo, Hui Feng, Zhonghong Ou, Kaiwen Xue, Guoxin Zhang, Yifan Zhu, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- OmniLLM: 텍스트, 이미지, 오디오, 비디오 등 다중 모달 데이터를 통합적으로 처리하고 추론하는 대규모 언어 모델을 의미합니다.
- Commitment Anchoring: 모델이 생성한 초기 후보 응답(candidate response)을 고정하여, 증거 채널(evidence channel) 개입에 따른 생성 궤적(trajectory) 변동을 제거하고 비교 가능성을 확보하는 기법입니다.
- Evidence Interrogation: 특정 증거 채널을 제거하거나 개입시켜 모델이 생성한 토큰이 해당 증거에 얼마나 의존하고 있는지를 토큰 단위로 분석하는 프로세스입니다.
- Token-by-Channel Confession: 각 토큰이 어떤 증거 채널에 의해 유도되었는지(Aligned, Over-reliance, Under-reliance)를 구조화하여, 할루시네이션(hallucination) 교정의 단서로 활용하는 정보를 뜻합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 OmniLLM에서 발생하는 오답 유도적 증거 의존성 및 관련 증거 활용 부족으로 인한 할루시네이션 문제를 해결하기 위해 OmniConfess를 제안합니다. 기존의 할루시네이션 제어 기법들은 추가적인 학습(training)이나 외부 자원을 요구하는 경우가 많고, 복합적인 멀티모달 환경에서 특정 채널이 최종 응답에 미치는 영향을 명확히 해석하지 못하는 한계가 있습니다. 특히 모델이 생성 중 증거 개입에 따라 궤적이 변하면, 할루시네이션의 원인을 명확히 구분하기 어렵다는 점이 큰 문제로 지목됩니다. 따라서 모델의 생성 궤적을 고정하고, 토큰 단위에서 채널별 기여도를 분석하여 할루시네이션을 교정할 수 있는 학습 프리(training-free) 방식의 추론(inference-time) 프레임워크가 필요합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
OmniConfess는 Commitment Anchoring, Evidence Interrogation, Confession-Guided Correction의 3단계 프레임워크를 통해 할루시네이션을 완화합니다. 먼저 모델이 생성한 후보를 고정(anchoring)한 후, 각 증거 채널을 순차적으로 제거(interrogation)하며 토큰 단위의 의존성 수치를 계산합니다. 이를 바탕으로 구성된 Confession은 판단형 태스크의 경우 신뢰 점수를 재조정하고, 생성형 태스크에서는 할루시네이션 위험이 높은 토큰 범위를 식별하여 수정합니다. 실험 결과, OmniConfess는 3,540개의 예제로 구성된 OmniHalluBench 벤치마크에서 기존 최고 수준의 베이스라인 대비 성능을 대폭 개선하였습니다. Qwen2.5-Omni-7B 모델을 기준으로 볼 때, 기존 방식들 대비 Judgement 태스크의 F1 점수에서 약 10.20 포인트 이상의 개선을 보였으며, RAGTruth와 같은 생성 태스크에서도 뛰어난 성능 향상을 기록했습니다. 이는 [Table 1]에 명시된 바와 같이, 서로 다른 아키텍처 모델들에서도 일관되게 높은 F1 성능 개선폭을 유지하는 것으로 확인됩니다.
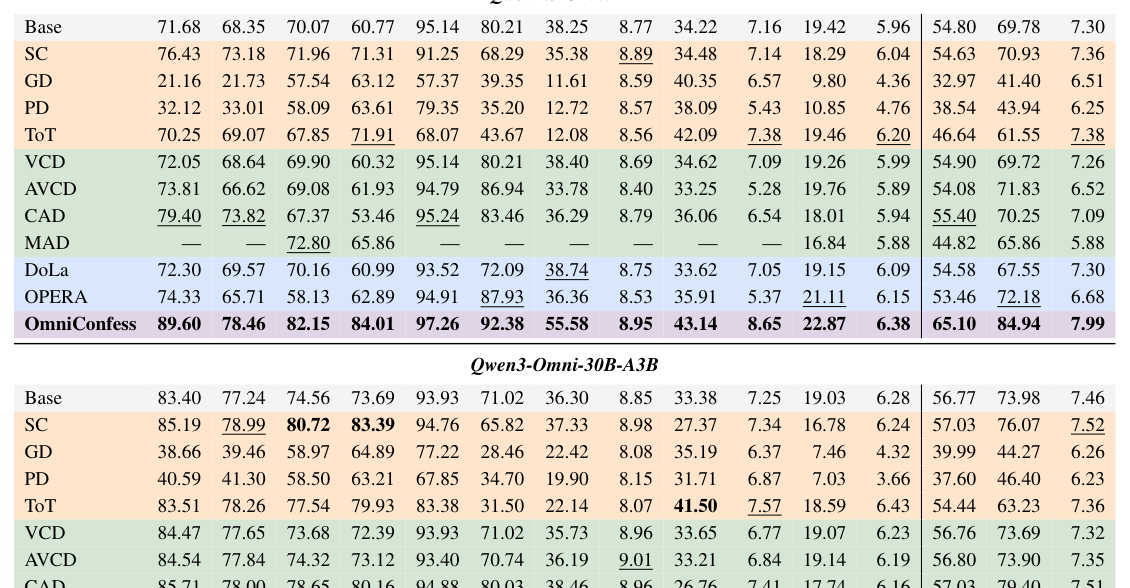
Table 1 — OmniConfess가 다양한 백본 모델에서 기존 베이스라인 대비 압도적인 성능 향상을 보임을 증명하는 핵심 지표
## 4. Conclusion & Impact (결론 및 시사점)
본 논문은 토큰 및 채널 수준의 증거 탐색을 통해 멀티모달 할루시네이션을 효과적으로 제어하는 OmniConfess를 성공적으로 입증하였습니다. 구조화된 'Confession'은 블랙박스 형태의 LLM이 응답을 생성할 때 특정 모달리티에 과하게 의존하거나 증거를 누락하는 과정을 투명하게 드러내며, 학습 없이도 모델의 사실적 신뢰성을 크게 향상시킵니다. 이는 향후 멀티모달 시스템의 추론 효율성과 해석 가능성(interpretability)을 동시에 확보하려는 연구 방향에 중요한 이정표가 될 것으로 기대됩니다. 또한 본 연구의 결과는 복잡한 멀티모달 추론 환경에서 모델의 오류를 진단하고 수정하는 표준화된 프레임워크로서 학계 및 산업계의 할루시네이션 문제 대응에 기여할 것입니다.
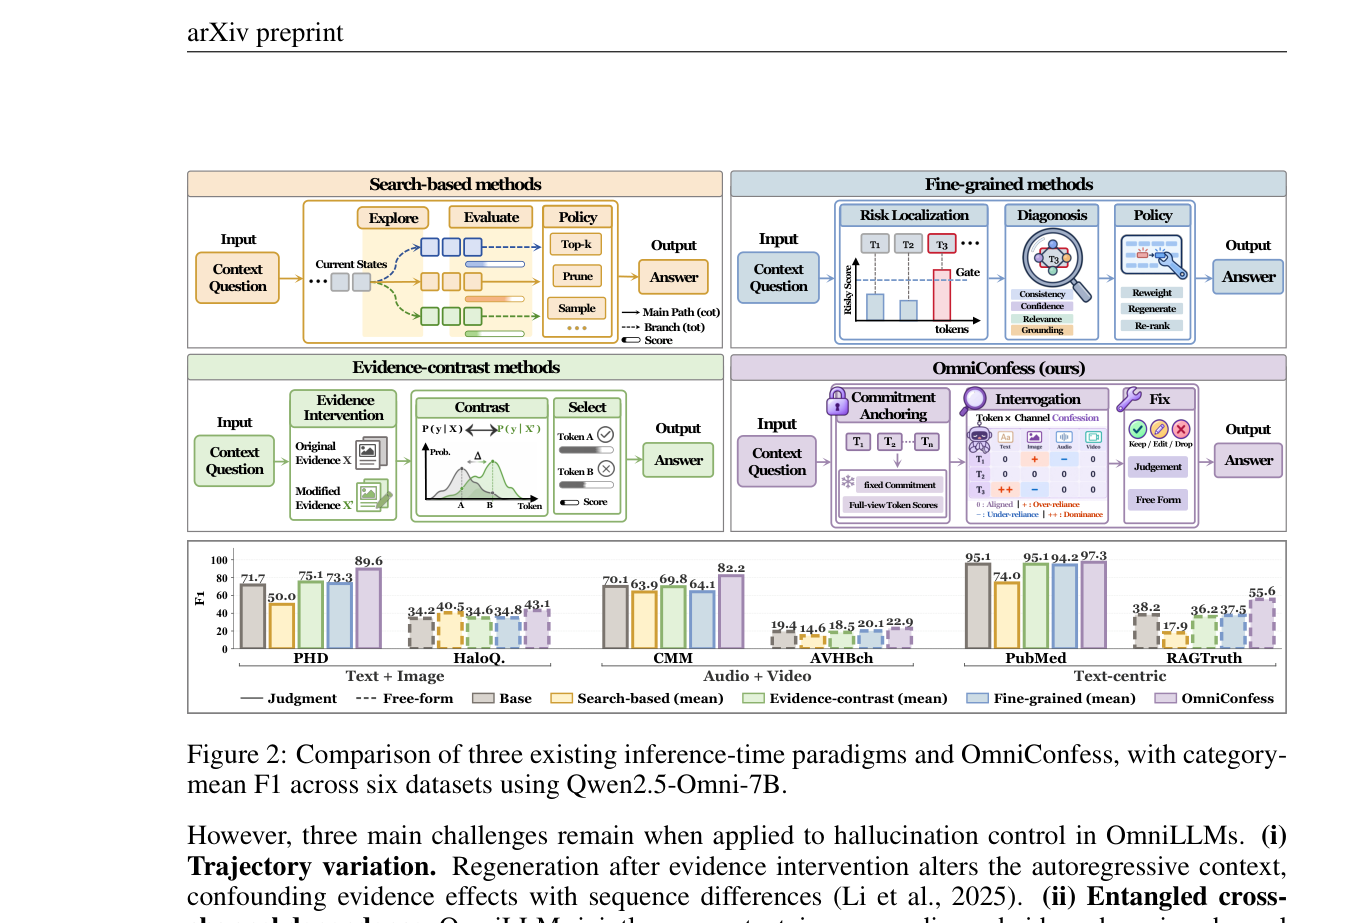
Figure 2 — OmniConfess 프레임워크의 고유한 워크플로우와 기존 방식과의 차별점을 설명하는 핵심 도식
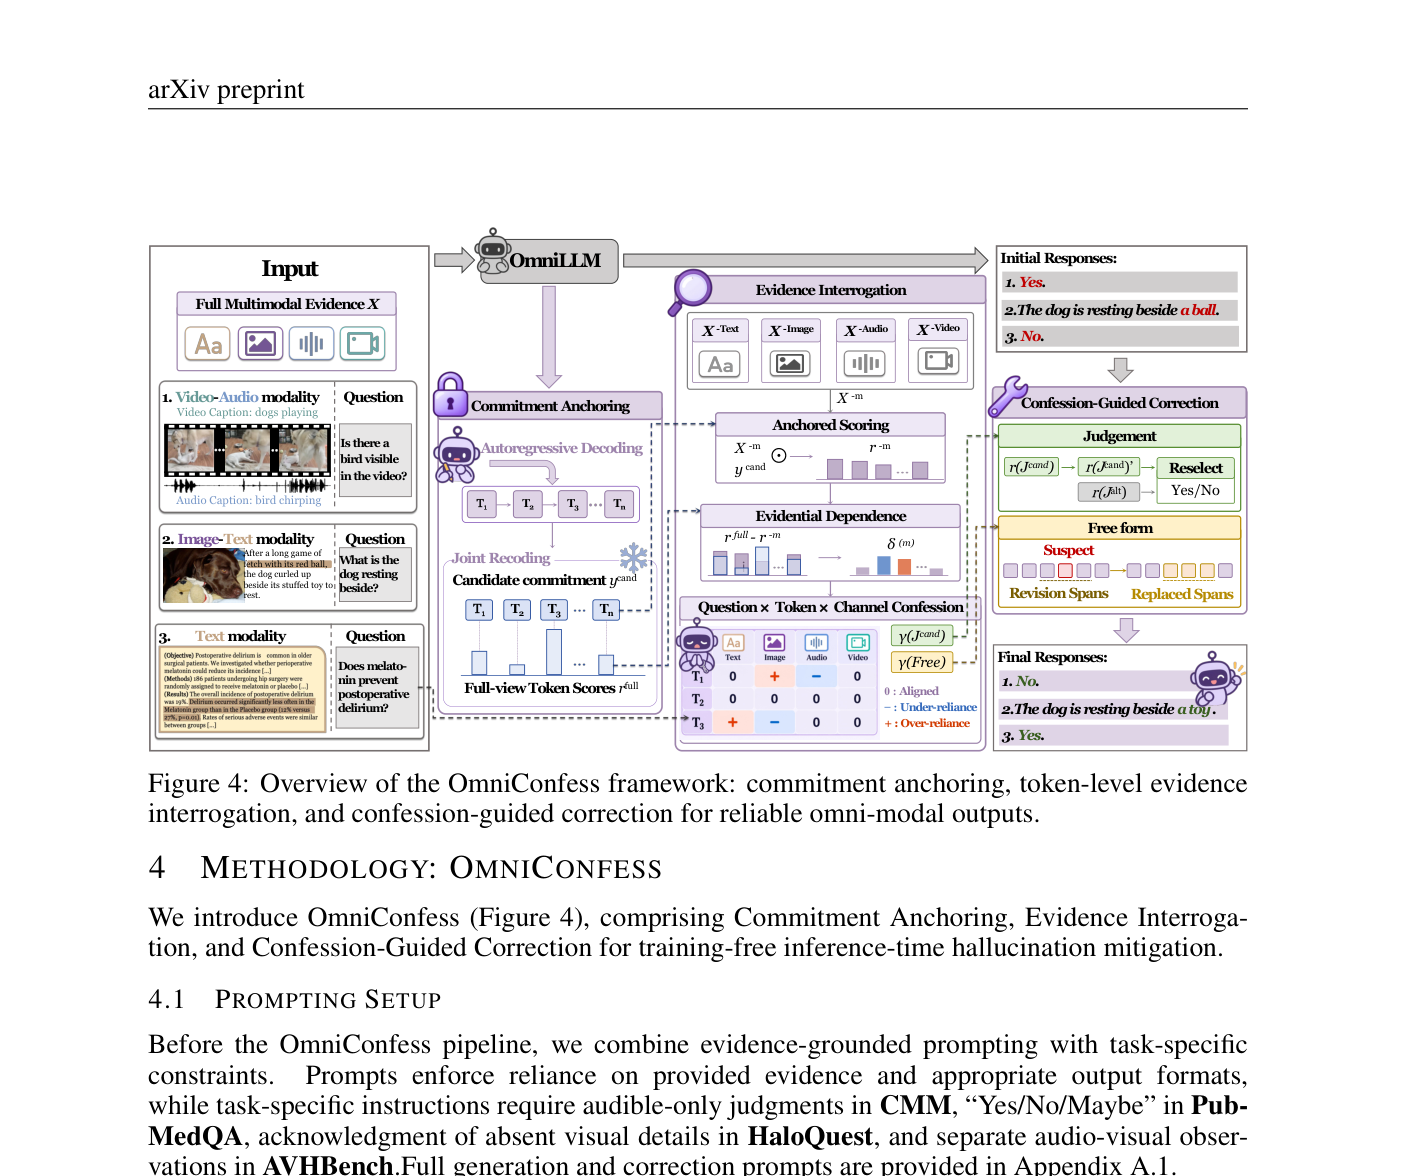
Figure 4 — OmniConfess의 전체 파이프라인과 각 구성 요소의 동작 원리를 보여주는 상세 아키텍처 다이어그램
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AutoResearch: Insight In, Hallucination Out
- [논문리뷰] LEDGERMIND: Provenance-Constrained Multimodal Agentic Reasoning with a Structured Evidence Ledger
- [논문리뷰] Hallo4D: Multi-Modal Hallucination Mitigation for Consistent Spatio-Temporal Generation
- [논문리뷰] Boosting Omni-Modal Language Models: Staged Post-Training with Visually Debiased Evaluation
- [논문리뷰] Perceptual Flow Network for Visually Grounded Reasoning
Review 의 다른글
- 이전글 [논문리뷰] OSWorld-Pro: Process-based Evaluation for Computer Use Agents
- 현재글 : [논문리뷰] OmniConfess: Eliciting Token Confessions to Mitigate Omni-Modal Hallucination
- 다음글 [논문리뷰] OpenRUA: Robot-Use Agents Are Zero-Shot Visuomotor Policies
댓글