[논문리뷰] QuantCode Model: Specializing Language Models for Executable Algorithmic Trading Code
링크: 논문 PDF로 바로 열기
저자: Alexey Chernysh, Orkhan Ekhtibarov, Dmitry Zmitrovich
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- QuantCode-Bench: 400개의 알고리즘 트레이딩 전략 생성 태스크로 구성된 벤치마크로, 코드 생성, 실행, 거래 생성, 의미론적 정합성을 단계별로 평가함.
- Backtrader: 논문에서 목표로 하는 알고리즘 트레이딩 전략 수행 프레임워크로, 모델이 생성한 코드의 실행 환경이자 API 의존성을 정의함.
- Judge Pass: LLM 기반의 시맨틱 저지(Semantic Judge)가 생성된 코드가 요청된 전략을 논리적으로 정확하게 구현했는지 평가하는 지표임.
- Agentic Evaluation: 에이전트가 구조화된 피드백을 수신하여 최대 10회까지 코드를 수정하는 과정에서의 성공률을 평가하는 방식임.
- Capability-Retention Failure: 특정 도메인 특화(Domain Specialization) 학습이 기존의 구조화된 Tool-calling 능력이나 인스트럭션 팔로잉(Instruction following) 성능을 저하시키는 현상임.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
- 본 연구는 일반적인 코드 생성 모델이 알고리즘 트레이딩과 같은 고도로 특화된 도메인의 실행 가능한 코드 생성에서 실패하는 문제를 해결하고자 한다.
- 기존의 모델은 범용 파이썬 코드 생성에는 능숙하지만, 트레이딩 프레임워크의 특정 API 규칙이나 상태 관리, 실행 의미론(Execution Semantics)을 제대로 이해하지 못하는 한계가 있다.
- 이러한 도메인 특화 작업은 텍스트 정합성만으로는 평가할 수 없으며, 실행(Execution) 결과와 실제 거래 생성 여부, 그리고 전략적 일관성이 동시에 보장되어야 한다.
- 본 연구는 이러한 능력을 정량적으로 측정하기 위해
[Table 2]에 제시된 QuantCode-Bench를 활용하여 모델의 도메인 특화 학습 과정에서의 변화를 분석한다.
Table 2 — 모델별 훈련 단계에 따른 주요 지표인 Backtest, Trades, Judge 성능 비교 테이블
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
- 본 논문은 모델의 도메인 적응력을 높이기 위해 알고리즘 트레이딩 관련 코드 기반의 Continued Pretraining과 에이전트 환경에서 검증된 데이터셋을 사용한 Supervised Fine-tuning (SFT)이라는 두 가지 보완적 메커니즘을 결합하였다.
- Qwen3.6-35B-A3B 모델을 대상으로 실험한 결과, Continued Pretraining은 Judge Pass를 27.8%에서 33.0%로 향상시켰으며, 이후 SFT를 적용했을 때 Judge Pass가 58.2%까지 급격히 상승하는 성과를 보였다.
- 에이전트 평가 결과에서도 SFT 적용 모델은 첫 번째 시도(T1) 성공률이 22.3%에서 58.3%로, 최종 성공률(T10)이 47.5%에서 79.5%로 대폭 개선되었음을
[Figure 2]를 통해 확인할 수 있다. - 반면, Continued Pretraining만 수행할 경우 초기 시도 성공률은 향상되나 반복적인 피드백 처리 능력이 저하되어 최종 단계의 성능이 오히려 낮아지는 현상이 발생함을 관찰하였다.
- 또한 도메인 특화 과정에서 Tool-calling 포맷이 붕괴되는 Capability-Retention Failure가 나타났으며, 이를 회복하기 위해 제안된 Recovery SFT 기법이 운영상의 호환성을 복구하는 데 효과적임을 입증하였다.
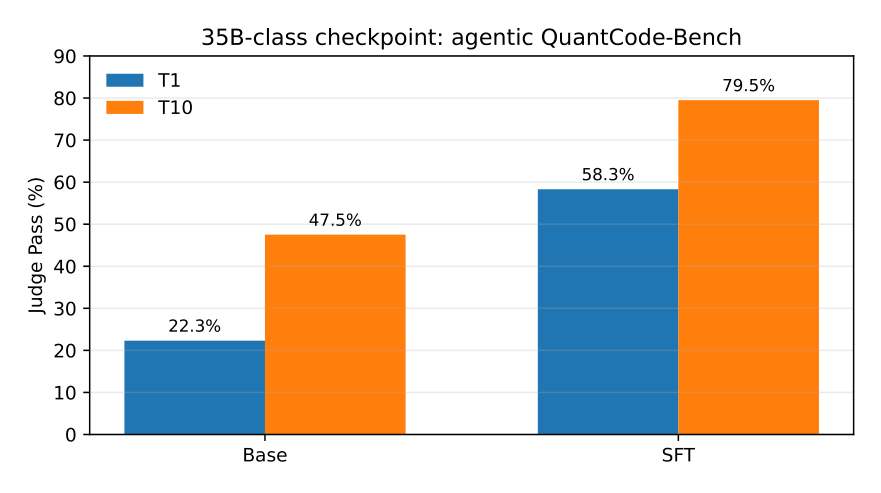
Figure 2 — 에이전트 기반 학습(T1, T10) 성공률 변화를 시각화한 핵심 그래프
## 4. Conclusion & Impact (결론 및 시사점)
- 본 논문은 도메인 특화 코드 생성을 위한 모델 학습 시, 단순 사전 학습을 넘어 검증된 SFT와 구조적 도메인 지식의 내재화가 필수적임을 결론짓는다.
- 또한, 도메인 성능 향상이 기존의 범용 능력(Tool-calling 등)에 미치는 부작용을 사전에 식별하고, 이를 평가하는 Capability-Retention 체크의 중요성을 강조하였다.
- 본 연구의 결과는 금융 도메인뿐만 아니라 복잡한 외부 프레임워크 환경에서 동작해야 하는 모든 소프트웨어 에이전트 개발 및 배포 과정에 중요한 방법론적 지침을 제공한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] QuantCode-Bench: A Benchmark for Evaluating the Ability of Large Language Models to Generate Executable Algorithmic Trading Strategies
- [논문리뷰] Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
- [논문리뷰] Can Large Language Models Execute Parent Orders?
- [논문리뷰] Compress-Distill: Reasoning Trace Compression for Efficient Knowledge Distillation
- [논문리뷰] CoVe: Training Interactive Tool-Use Agents via Constraint-Guided Verification
Review 의 다른글
- 이전글 [논문리뷰] ProgressCompass: Embodied Progress Reward Models Are Lost Without the Right Context
- 현재글 : [논문리뷰] QuantCode Model: Specializing Language Models for Executable Algorithmic Trading Code
- 다음글 [논문리뷰] RealtimeWAM: One-Step Asynchronous World Action Models
댓글