[논문리뷰] AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
링크: 논문 PDF로 바로 열기
저자: Dongki Kim, Namkyeong Lee, Surag Nair, Carl Edwards, Xiner Li, Edward De Brouwer, Jenna Lynn Collier, Sung Ju Hwang, Gabriele Scalia, Ehsan Hajiramezanali
1. Key Terms & Definitions (핵심 용어 및 정의)
- AutoSciBench: 과학적 에이전트의 능력을 평가하기 위한 벤치마크를 자동으로 생성하고 개선하는 프레임워크입니다.
- Concept: 과학적 도메인, 데이터 모달리티, 그리고 평가하고자 하는 분석적 작업(Required Operations)을 정의하는 고수준의 평가 계획입니다.
- Recipe: Concept의 요구사항을 구체적인 문제(Question), 환경, Ground-truth로 변환하는 저수준의 실행 계획입니다.
- Feedback-guided Iterative Refinement: 에이전트의 Solver 궤적과 Judge의 피드백을 활용하여 Recipe나 Concept를 수정함으로써, 데이터 재검토 및 결과 해석이 필수적인 더 어려운 평가 과제를 만드는 프로세스입니다.
- Experience-guided Concept Generation: 과거의 개선 과정(Refinement histories)에서 얻은 교훈을 요약(Experience cards)하여, 새로운 Concept 생성 시 동일한 실패나 비효율을 방지하는 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 과학적 도메인에서 에이전트의 발전 속도를 평가 벤치마크가 따라가지 못하는 문제를 해결하기 위해 고안되었습니다. 기존의 벤치마크는 수동으로 구축되어 많은 시간과 비용이 소요되며, 에이전트의 성능이 향상됨에 따라 빠르게 포화(Saturation)되어 차별적인 평가가 어렵다는 한계가 있습니다. 특히 과학적 과제는 단순한 정답 맞히기가 아닌, 원시 데이터(Raw data)의 분석, 중간 결과의 검증, 그리고 증거 통합(Evidence integration)과 같은 고도의 추론 과정이 필요합니다 [Figure 1]. 따라서 본 연구는 이러한 평가 과제를 자동으로 생성하고, 에이전트의 행동 피드백을 통해 지속적으로 난이도를 조절할 수 있는 자율적인 벤치마크 생성 프레임워크를 제안합니다.
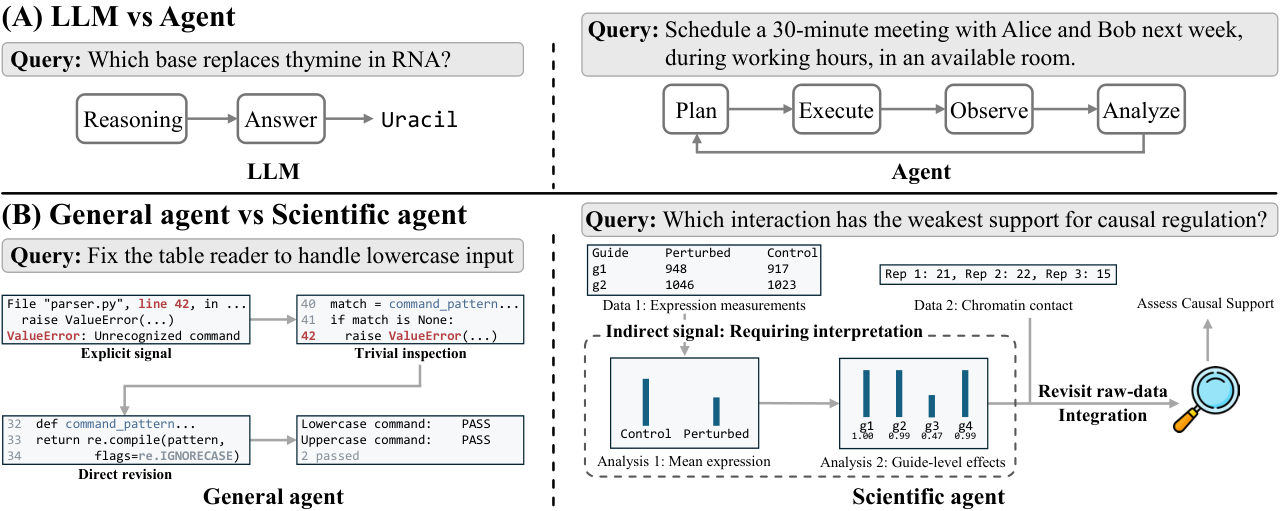
Figure 1 — 과학적 에이전트와 일반 에이전트 평가 차이
3. Method & Key Results (제안 방법론 및 핵심 결과)
AutoSciBench는 Concept 생성, Recipe 계획, 과제 구현, Solver 평가 및 피드백 기반의 정제 과정을 순환적으로 수행합니다 [Figure 2]. 각 Task는 먼저 문헌과 기존 벤치마크로부터 Concept를 추출하고, 이를 구체화하여 Recipe를 작성합니다 [Figure 3]. 평가 과정에서 에이전트가 단일 Tool 호출로 Shortcut을 찾는 경우, Judge 피드백을 통해 과제의 난이도를 높이고 데이터 의존성을 강화합니다. 연구 결과, Claude Opus 4.8 및 GPT-5.6 Sol을 사용하여 생성된 벤치마크는 기존의 수동 벤치마크 대비 Computational Biology 분야에서 평균 22.4%p, Materials Science 분야에서 25.5%p 낮은 Solver 정확도를 기록하며 평가의 변별력을 높였습니다 [Table 1]. 또한, 제안된 피드백 정제 과정을 통해 생성된 과제들은 세 가지 모든 도메인에서 수동 벤치마크보다 높은 평균 품질 점수를 획득하였습니다.
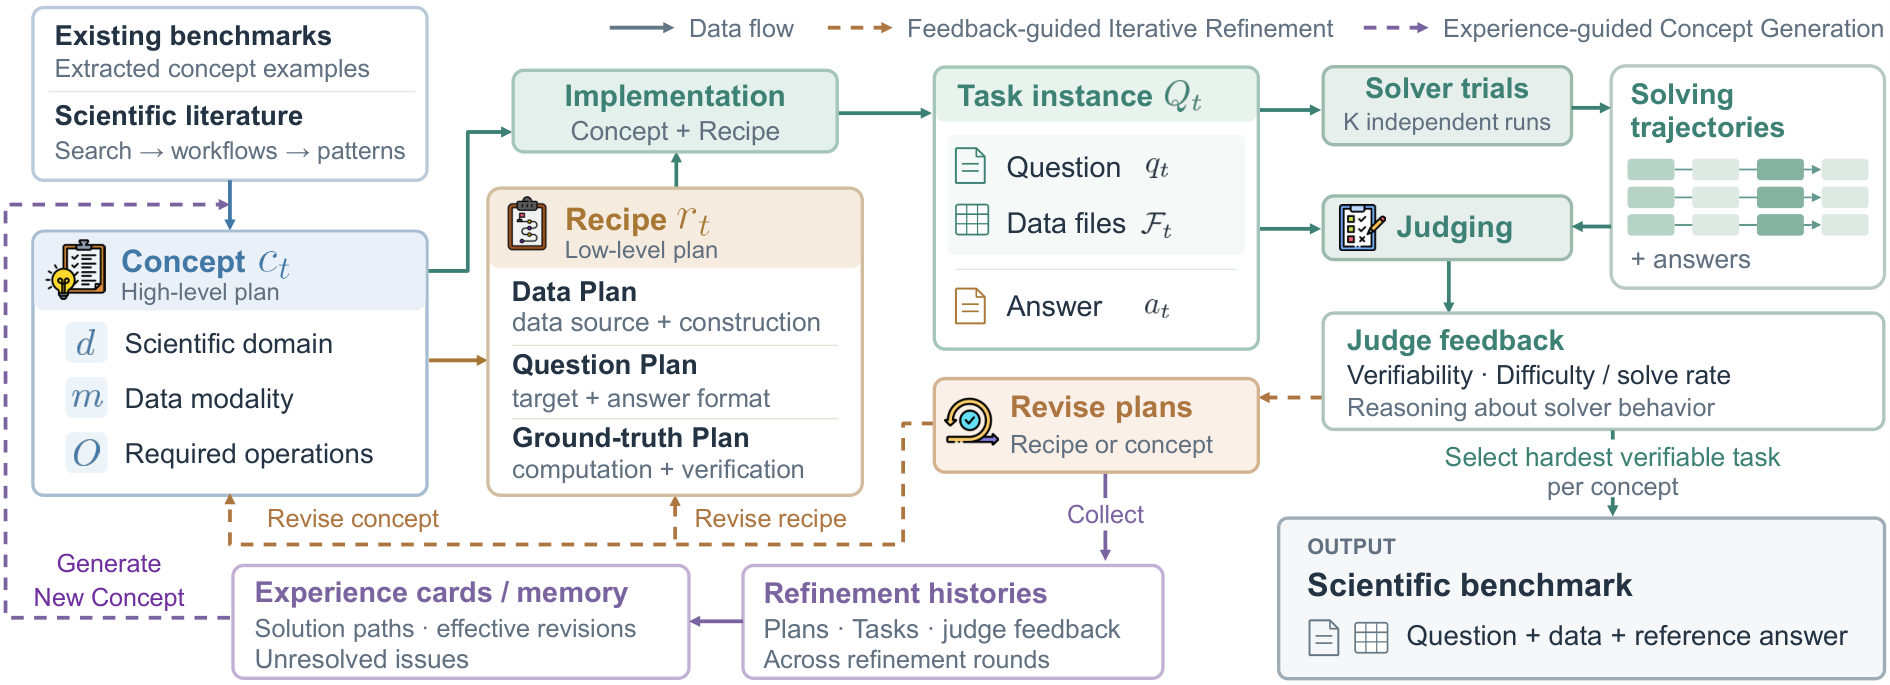
Figure 2 — AutoSciBench 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 과학적 에이전트 평가가 인간의 개입 없이도 에이전트의 능력과 진화에 맞춰 스스로 적응하고 발전할 수 있음을 입증하였습니다. AutoSciBench를 통해 생성된 벤치마크는 에이전트의 고질적인 문제인 '지름길 찾기'를 방지하고, 실제 과학적 추론을 요구하는 더 어려운 문제들을 성공적으로 배포하였습니다. 이 연구는 평가 자동화 기술이 과학 분야의 인공지능 발전을 가속화하고, 보다 신뢰성 있는 도메인 특화 에이전트 평가 체계를 구축하는 데 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
- [논문리뷰] A Pathway to General-Purpose Scientific AI: Multimodal Comprehension of Scientific Images
- [논문리뷰] Sci-VBench: Evaluating Knowledge- and Reasoning-Intensive Video Generation in Science Domains
- [논문리뷰] Apple-π: Benchmarking Thinking with Video Towards Law-Grounded Physical Intelligence
- [논문리뷰] Scalable Visual Pretraining for Language Intelligence
Review 의 다른글
- 이전글 [논문리뷰] Attacca: Goal-Directed Control under State Continuity for Long-Horizon Embodied Agents
- 현재글 : [논문리뷰] AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
- 다음글 [논문리뷰] Building Rome from a Single Image
댓글