[논문리뷰] GraphDecisionBench: Benchmarking System One Models on Graph Tasks
링크: 논문 PDF로 바로 열기
저자: Xianliang Yang, Yapu Zhang, Li Zhao, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- System One Models: 별도의 deliberative reasoning(심사숙고 단계) 없이 주어진 옵션 중에서 즉각적으로 선택을 수행하는 모델을 지칭함.
- Graph Cognition: 그래프의 구조적 속성(adjacency, cycle, connectivity 등)을 파악하는 능력을 평가하는 과업 세트.
- Graph-Text Decision-Making: 텍스트와 그래프 데이터를 통합적으로 사용하여 노드 분류 및 엔티티 선택을 수행하는 과업.
- Sequential Decision-Making on Graphs: 경로 건설(TSP)이나 최적화 문제(MaxCut, influence maximization 등)와 같이 일련의 결정을 순차적으로 내려 최종 솔루션을 구축하는 과업.
- Matched Input Conditions: 그래프-텍스트 모델의 입력 조건을 통제하여 정보 추가에 따른 성능 변화를 분석하기 위한 실험 프레임워크(T, G, TG, BAG, A 등).
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 System One models이 그래프 관련 과업에서 나타내는 구조적 이해 능력과 정보 활용 성격이 불분명하다는 문제를 해결하기 위해 GraphDecisionBench를 제안한다. 기존의 그래프 벤치마크들은 통합된 capability score에 집중하는 경향이 있어, 모델이 구조적 연산, 정보 사용의 효율성, 그리고 순차적 의사결정의 질적 수준을 어떻게 분리하여 수행하는지 진단하기 어렵다. 특히, 단순한 edge recognition 능력이 전체적인 구조적 올바름을 보장하지 않으며, 추가적인 정보 입력이 일관된 성능 향상으로 이어지지 않는다는 한계점이 존재한다. 따라서 본 연구는 이러한 세 가지 차원의 평가를 위한 진단형 벤치마크의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 GraphDecisionBench를 구축하여 Jev를 포함한 14개의 다양한 모델-인터페이스 구성을 평가함으로써 시스템적 성능을 검증하였다. 제안된 프레임워크는 graph cognition, graph-text decision-making, sequential decision-making이라는 세 가지 task family를 통해 모델을 독립적으로 평가한다. Graph Cognition 실험 결과, Jev는 adjacency 탐지에는 매우 능숙하지만, 복잡한 exact degree(67.8%)나 articulation(61.25%) 평가에서는 성능 저하를 보였다 [Figure 2]. Graph-Text Decision-Making 과업에서는 ogbn-arxiv와 STaRK-Prime 데이터셋을 사용하여 모델별 입력 조합(T, G, TG 등)의 효과를 비교하였는데, joint input(TG)이 항상 성능 향상을 보장하지 않으며 모델마다 민감도가 다르다는 결과를 얻었다 [Table 2]. Sequential Decision-Making on Graphs 실험에서는 direct construction 방식과 heuristic-proposal selection 방식을 비교하였으며, 대부분의 경우 heuristic 제안을 사용할 때 reference gap이 현저히 낮아져(예: Jev의 TSP gap이 59.66%에서 25.87%로 개선) 성능이 향상됨을 확인하였다 [Table 3].
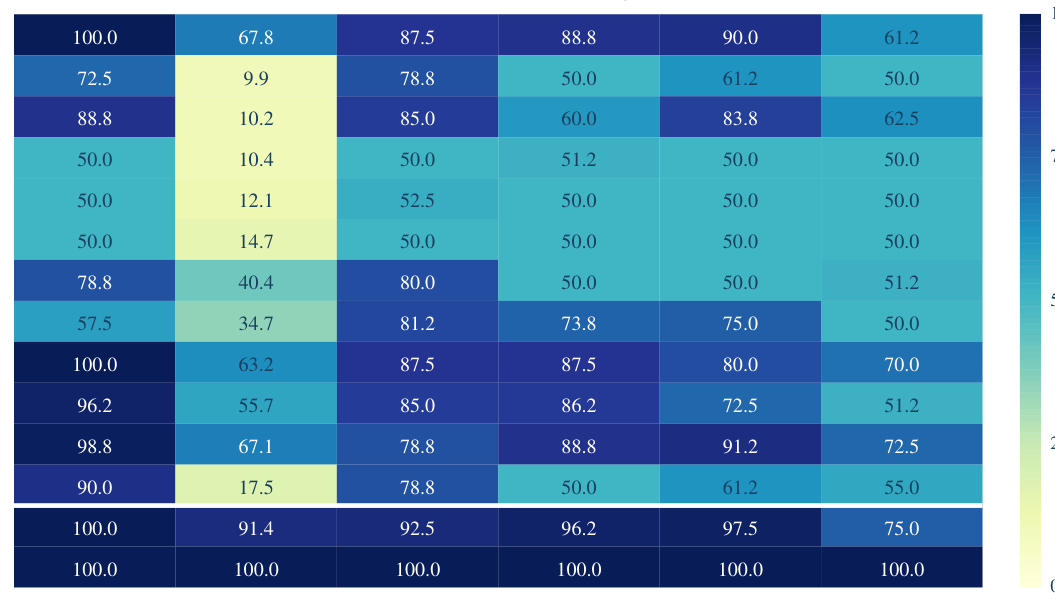
Figure 2 — 모델별 구조적 판단 능력 프로필을 한눈에 비교할 수 있는 핵심 지표
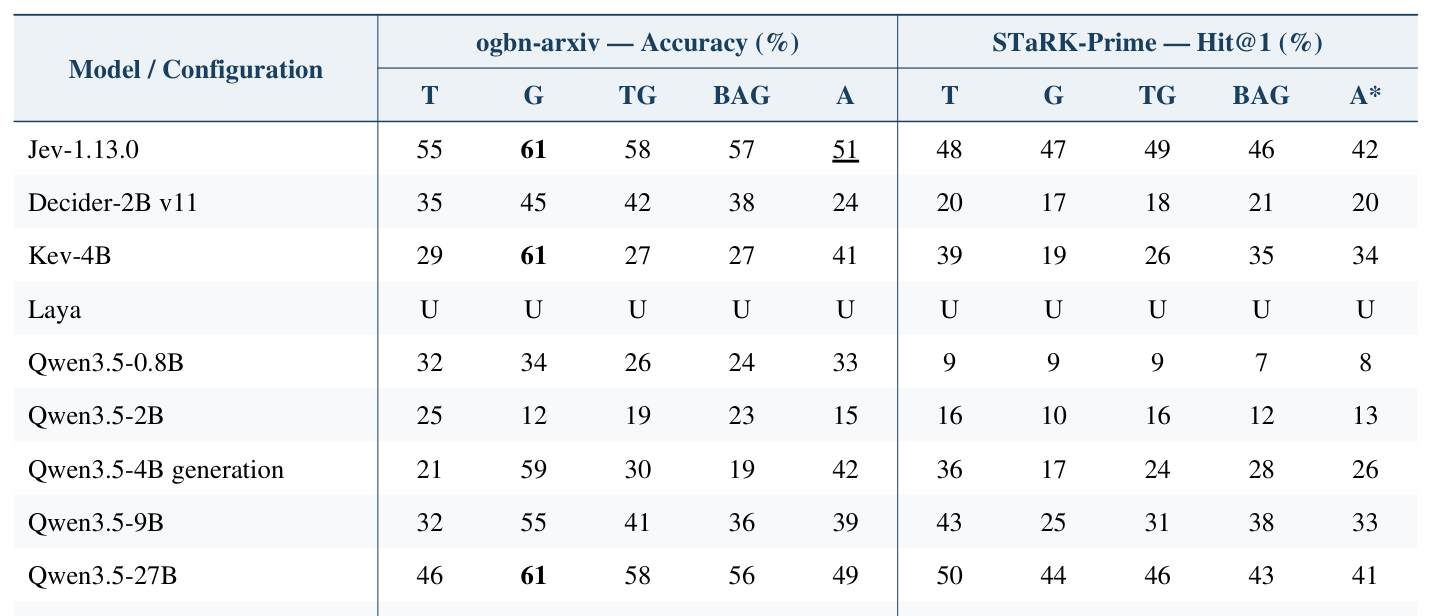
Table 2 — 텍스트-그래프 입력 조건에 따른 모델의 성능 변화를 대조한 주요 결과 테이블
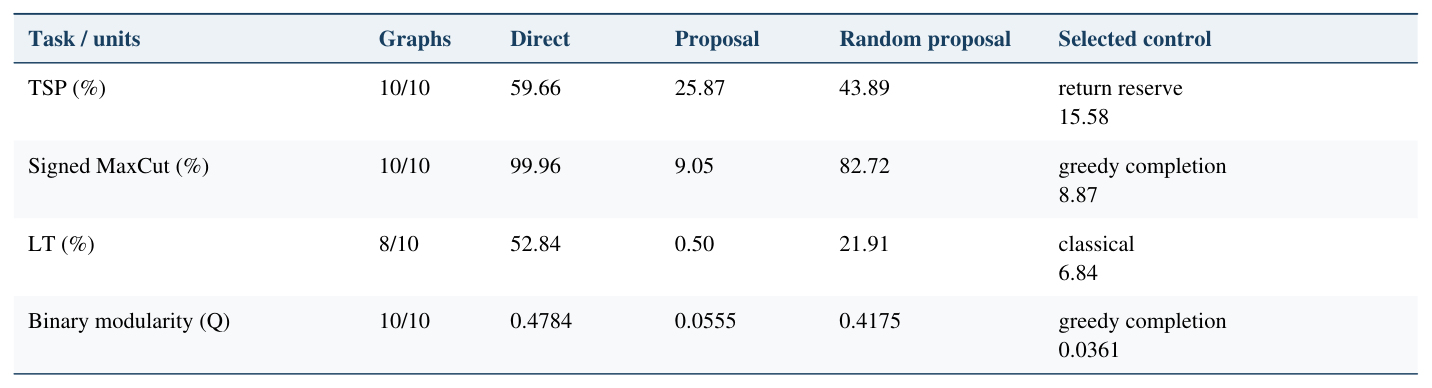
Table 3 — Jev 모델의 순차적 의사결정 방식(Direct vs Proposal)에 따른 성능 차이를 보여주는 결과
4. Conclusion & Impact (결론 및 시사점)
본 연구는 System One models의 그래프 추론 능력이 단일한 인터페이스나 통합 지표로 평가될 수 없으며, 과업의 특성에 따라 세분화된 진단이 필요함을 결론짓는다. GraphDecisionBench는 모델의 구조적 이해, 정보 결합 능력, 순차적 의사결정의 질적 진단을 가능하게 함으로써 향후 그래프 관련 AI 모델 설계와 평가에 중요한 방법론적 기준을 제시한다. 이 벤치마크는 특정 아키텍처에 의존하지 않는 독립적인 평가 프레임워크를 제공하여, 향후 등장할 다양한 의사결정 모델들에 대해서도 일관된 비교와 성능 분석을 가능하게 할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
- [논문리뷰] Jeva: System One Models from First Principles
- [논문리뷰] MemHarness: Memory Is Reconstructed, Not Replayed
- [논문리뷰] RealICU: Do LLM Agents Understand Long-Context ICU Data? A Benchmark Beyond Behavior Imitation
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
Review 의 다른글
- 이전글 [논문리뷰] From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
- 현재글 : [논문리뷰] GraphDecisionBench: Benchmarking System One Models on Graph Tasks
- 다음글 [논문리뷰] Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation
댓글