[논문리뷰] ARCS: Towards Precise Text-to-SQL via Structured Disambiguation
링크: 논문 PDF로 바로 열기
저자: Yihao Hu, Yanlin Feng, Naoki Otani, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Structured Disambiguation: 자연어 질의의 모호성을 해결하기 위해 자유로운 대화(free-form dialogue) 대신 명시적이고 제약된 상호작용(explicit, constrained interactions)을 통해 사용자가 올바른 해석을 선택하도록 하는 새로운 패러다임입니다. 이는
Recognition rather than Recall원칙을 활용합니다. - Conversational Disambiguation: 기존
Text-to-SQL시스템에서 사용되는 방식으로, 모호한 사용자 질문에 대해 시스템이 명확화 질문(clarification questions)을 던지고 사용자가 자연어(natural language)로 추가 정보를 제공하여 모호성을 해결하는 방법입니다. - Ambiguity Point: 질문 내에서 여러 가지 유효한 해석이 가능한 구문이나 개념을 의미합니다. 이는 유한한 해석을 가지는
Finite Ambiguity와 무한한 해석 공간을 가지는Infinite Ambiguity로 나뉩니다. - Linguistic Dimension:
Text-to-SQL질의의 모호성을 언어적 원천에 따라 분류하는 차원입니다.Semantic Ambiguity(단어나 구문의 다의성)와Syntactic Ambiguity(문장 구조의 다의성)로 구성됩니다. - Database Dimension:
Text-to-SQL질의의 모호성을 해당 질의가 데이터베이스 요소에 어떻게 매핑되는지에 따라 분류하는 차원입니다.Column Ambiguity,Table Ambiguity,Value Ambiguity,Computation Ambiguity의 네 가지 유형으로 나뉩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Text-to-SQL 시스템이 실제 환경(real-world deployment)에서 모호성(ambiguity) 문제로 인해 사용자 의도(user intent)와 다른 결과(system outputs deviate)를 초래하는 심각한 문제에 직면하고 있음을 지적합니다. 기존 Text-to-SQL 벤치마크(Spider 2.0 등)는 대부분 모호하지 않고 명확하게 명시된(unambiguous, often over-specified) 질문으로 구성되어 있어, 실제 사용자들이 질문하는 방식과는 차이가 있습니다. 이로 인해 "How many GitHub issues are opened in 2025?"와 같은 질문에서 opened가 단순히 생성된 이슈를 의미하는지, 아니면 재오픈된 이슈도 포함하는지에 대한 미묘한 모호성이 발생할 수 있으며, 이는 중요한 비즈니스 의사결정(critical business decisions)에 상당한 영향을 미칠 수 있습니다. 기존의 Conversational Disambiguation 방식은 비효율적이고 인지적 부담(cognitively demanding)이 크며 실제 사용자 워크플로우(user workflows)와 잘 맞지 않는 한계점을 가집니다. 따라서 저자들은 이러한 한계를 극복하고 Text-to-SQL 시스템의 정확성(precision)을 높이기 위해 새로운 모호성 해결 패러다임과 평가 벤치마크의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Text-to-SQL에서 모호성을 해결하기 위한 새로운 패러다임인 Structured Disambiguation을 제안하며, 이를 평가하기 위한 벤치마크 ARCS (Ambiguity Resolution Corpus for SQL)를 구축했습니다. Structured Disambiguation은 질문에서 Ambiguity Point를 식별하고, 유한한 해석(finite interpretations)을 가진 지점은 다중 선택(multiple-choice)으로, 무한한 해석(unbounded interpretation space)을 가진 지점은 값 조절(value adjustment)을 통해 해결합니다. 이 접근 방식은 SQL 쿼리(SQL query)와 실행 결과(execution results)를 즉시 생성하여 사용자가 다른 해석의 결과를 쉽게 비교하고 재선택할 수 있도록 합니다. 저자들은 언어적 및 데이터베이스적 모호성 유형을 포괄하는 이차원적 분류 체계(two orthogonal dimensions taxonomy)를 개발하여, Semantic Ambiguity, Syntactic Ambiguity, Column Ambiguity, Table Ambiguity, Value Ambiguity, Computation Ambiguity를 정의했습니다 [Figure 2, cite: 1]. ARCS 벤치마크는 실제 데이터베이스(real-world databases)에서 자연적으로 발생하는, 제약 없는 모호성(naturally occurring, unconstrained ambiguities)을 특징으로 하며, 모든 유효한 Ambiguity Point, 해석, 그리고 SQL 쿼리에 대한 완전한 주석(complete annotations)을 제공합니다 [Figure 3, cite: 1].
실험 결과, 모호한 질문(ambiguous questions)이 있을 때 Text-to-SQL은 최신 Large Language Models (LLMs)에게 여전히 중대한 도전 과제임을 보여줍니다. 가장 우수한 성능을 보인 gpt-6-sol 모델조차 51.77%의 End-to-End Execution Accuracy만을 달성했으며, 오픈 소스 모델(open-source LLM) 중에서는 어떤 모델도 27%를 초과하지 못했습니다. 특히, 모호성 해결(disambiguation)이 Text-to-SQL 성능의 주요 병목 현상(primary bottleneck)으로 작용하며, Full Recall 및 Perfect Disambiguation 지표가 SQL 생성 지표(EX_disambiguated)보다 현저히 낮게 나타났습니다. 예를 들어, gpt-5와 claude-opus-4.5, gemini-3-pro 같은 선도적인 LLM들은 EX_disambiguated가 65.27%에서 68.81%로 유사한 반면, Full Recall은 22.51%에서 61.09%로 큰 차이를 보였습니다. 이는 LLM 훈련 시 모호성 해결이 충분히 반영되지 않았을 가능성을 시사합니다. 또한, 추론 노력(reasoning effort)을 증가시키면 End-to-End Execution Accuracy가 향상되는 경향을 보였으며, Structured Disambiguation은 Conversational Disambiguation과 유사한 성능을 보이면서도 훨씬 적은 User Effort를 요구하는 것으로 나타났습니다 [Figure 5, cite: 1].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Text-to-SQL 시스템에서 자연어 질의의 모호성이 실제 환경 배포에 있어 중요한 미탐색 과제임을 확인했습니다. 저자들은 이러한 모호성을 효율적으로 해결하고 사용자 노력을 최소화하기 위해 Structured Disambiguation이라는 새로운 상호작용 패러다임을 도입했으며, 이를 통해 명시적이고 제약된 상호작용으로 모호성을 해소할 수 있음을 입증했습니다. 또한, 실제 데이터베이스를 기반으로 하는 Text-to-SQL 질문의 자연스러운 모호성을 담은 최초의 벤치마크인 ARCS를 구축했습니다. 실험 결과는 모호성이 존재하는 상황에서 Text-to-SQL이 LLM에게 여전히 매우 도전적인 과제임을 명확히 보여주었습니다. 이 연구는 모호성을 인지하고 해결하는 Text-to-SQL 시스템에 대한 미래 연구를 촉진하고, 실제 사용자 워크플로우에 더 잘 부합하는 상호작용 패러다임 개발에 기여할 것으로 기대됩니다.
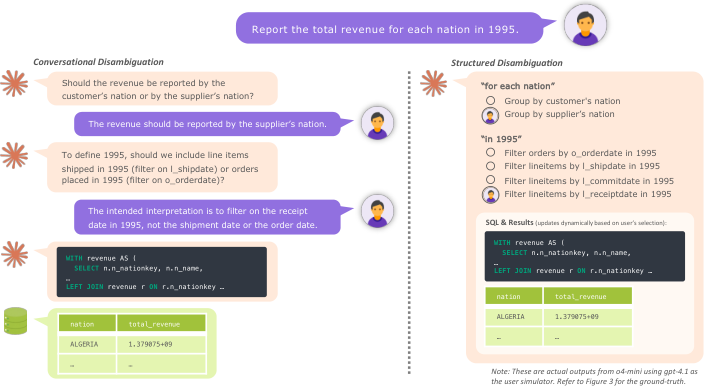
Figure 1 — 대화형/구조화된 모호성 해소 비교
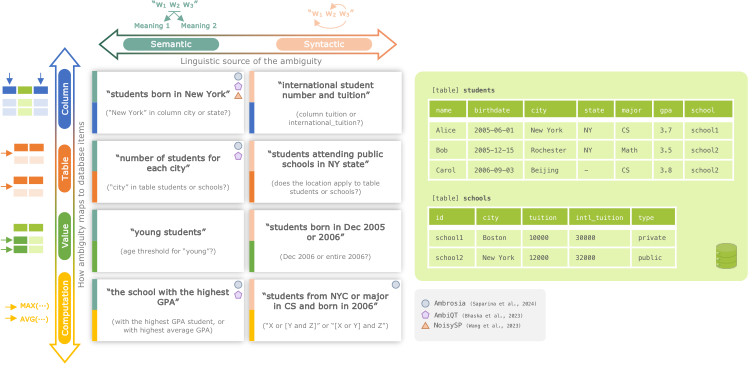
Figure 2 — ARCS 모호성 분류 체계
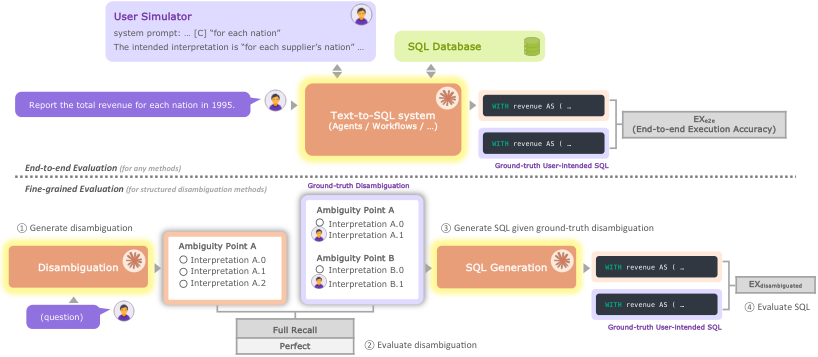
Figure 4 — ARCS 평가 설정 및 지표
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MiniAppBench: Evaluating the Shift from Text to Interactive HTML Responses in LLM-Powered Assistants
- [논문리뷰] Lost in Stories: Consistency Bugs in Long Story Generation by LLMs
- [논문리뷰] Legal RAG Bench: an end-to-end benchmark for legal RAG
- [논문리뷰] VL-LN Bench: Towards Long-horizon Goal-oriented Navigation with Active Dialogs
- [논문리뷰] BhashaBench V1: A Comprehensive Benchmark for the Quadrant of Indic Domains
Review 의 다른글
- 이전글 [논문리뷰] Work2Skill: Capturing Human GUI Experience for Reusable Agent Skill Induction
- 현재글 : [논문리뷰] ARCS: Towards Precise Text-to-SQL via Structured Disambiguation
- 다음글 [논문리뷰] AgentSWE: Can Coding Agents Build the Agent You Actually Want?
댓글