[논문리뷰] Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps
링크: 논문 PDF로 바로 열기
저자: Jiaxin Zhang, Xiangyu Peng, Qinglin Chen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 Prospective Hindsight (PH) 방법론과 관련된 핵심 용어들은 다음과 같습니다.
- Prospective Hindsight (PH): 기존의 회고적(retrospective) 훈련 방법론에 에이전트의 *사전 예측(prospective prediction)*과 사후 평가(retrospective evaluation) 간의
Prediction-Reality Gap에서 파생된 신호를 추가하여 자가 보정(self-calibrating) 능력을 강화하는 훈련 원칙입니다. - Hindsight Trap: 에이전트 RL에서 학습 신호가 행동 실행 이후에만 관찰되는 환경적 결과로부터 계산되므로, 행동 시점의 에이전트
belief가gradient에 반영되지 않아overconfidence문제를 해결하지 못하는 구조적 한계를 의미합니다. - Prediction-Reality Gap: 에이전트가
feedback을 받기 전에 수행하는prospective prediction과feedback이후의retrospective evaluation사이의 불일치를 나타냅니다. 이는 에이전트의 자가 모델이 가장 부정확한 샘플을 식별하는 데 사용됩니다. - Calibration Cells (CS, OF, US, AF): 에이전트의 사전
belief(zt)와 실제 결과 (yt)를 조합하여 롤아웃을 분류하는 4가지 범주입니다:Confident Success (CS),Overconfident Failure (OF),Underconfident Success (US),Aware Failure (AF). - Overconfident Failure Rate (OFR): 에이전트가 성공할 것이라고 예측했으나 실제로는 실패한 비율로,
Pr[yt=0 | zt=+1]로 정의되는miscalibration지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 기반 에이전트가 long-horizon task를 수행할 때 발생하는 overconfident failure 문제를 해결하고자 합니다. 현재 agentic RL은 전적으로 회고적(retrospective) 훈련 신호에 의존하며, 이는 환경적 결과가 관찰된 후에야 credit이 부여되어 에이전트의 행동 시점 belief가 gradient에 반영되지 않는 hindsight trap에 빠지게 합니다. 이러한 구조적 한계로 인해 기존 방법들은 task accuracy는 향상시키지만, 에이전트의 overconfidence 문제를 해결하지 못합니다. 기존 LLM calibration 연구들은 주로 inference-time 보정이나 별도의 confidence-target losses를 추가하는 방식이었으며, 이는 종종 capability-calibration trade-off를 야기하여 task performance 저하를 수반했습니다. 따라서 저자들은 prediction-reality gap을 단순한 diagnostic 지표가 아닌, training signal로 활용하여 에이전트의 자가 모델 inaccuracy를 직접적으로 개선하는 새로운 접근 방식이 필요하다고 지적합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Prospective Hindsight (PH)라는 자가 보정 훈련 원칙을 제안하여 기존의 모든 retrospective base method를 보강합니다. PH는 verifier 또는 PRM에 의해 롤아웃이 평가되기 전에, 동일한 policy를 다른 prompt로 재질문하여 최종 결과에 대한 prospective prediction을 유도합니다. 이 예측을 retrospective evaluation과 비교하여 per-rollout surprise 신호를 생성하며, 이 신호는 에이전트의 자가 모델이 가장 부정확한 훈련 샘플을 식별합니다. PH는 stop-gradient surprise-weighted advantage를 통해 이 surprising 샘플들의 gradient 기여도를 증폭시킵니다. prospective predictor가 policy와 parameter를 공유하기 때문에, 둘은 함께 발전하며 에이전트의 남은 blind spot에 점진적으로 초점을 맞춥니다. 이 원리는 privileged-information gap과 연결되며, surprise residual 최소화가 에이전트의 miscalibration rate에 대한 descent pathway를 제공함을 보여, calibration이 별도의 objective 추가 없이 optimization의 부산물로 나타나게 합니다. PH의 전체 과정은 [Figure 1]에서 시각적으로 요약되어 있습니다.
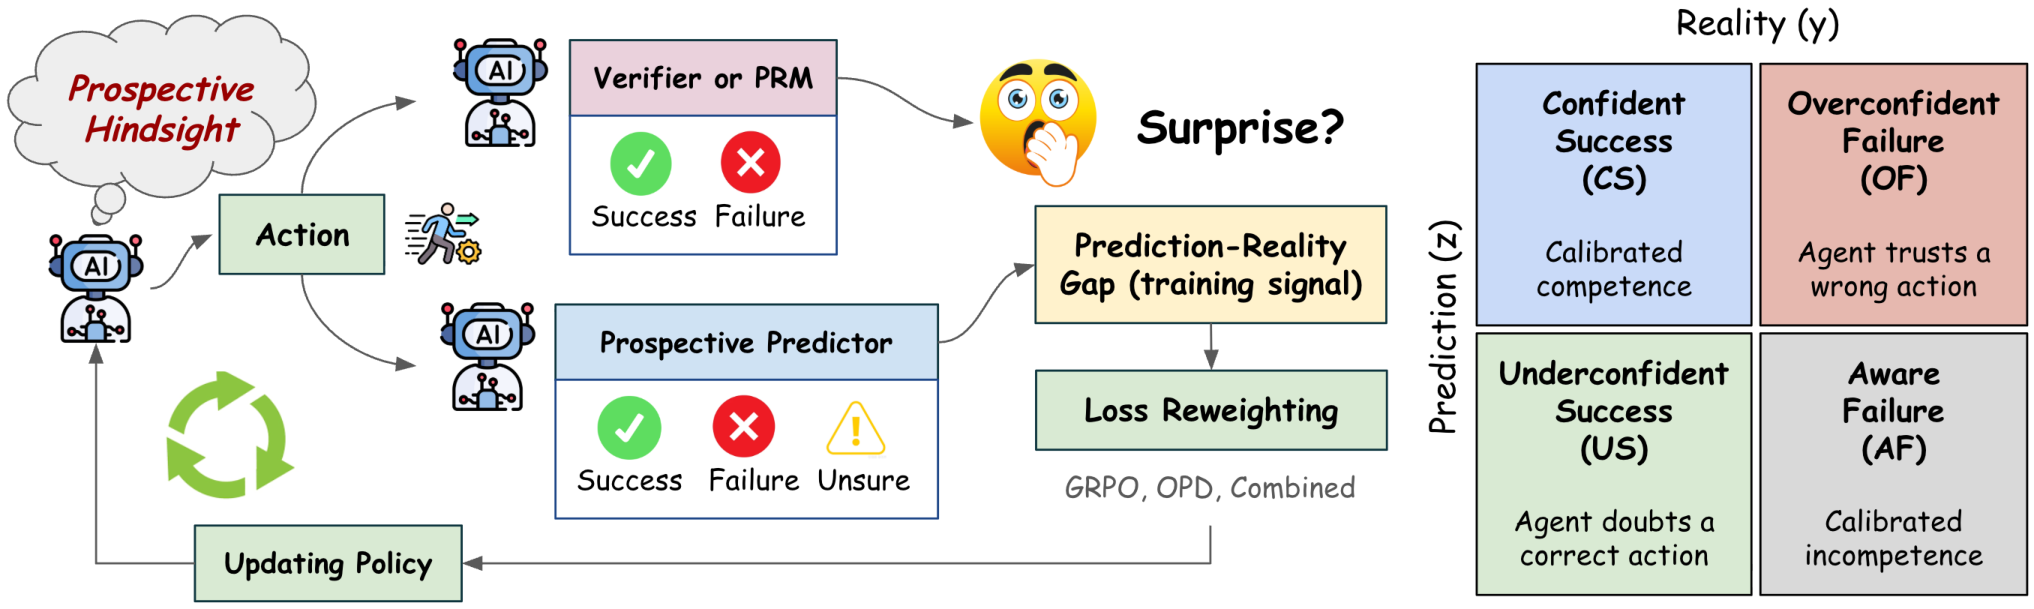
Figure 1 — 제안 PH 방법론 개요
실험 결과는 PH가 single-turn verifiable tasks와 multi-turn personal-agent task 모두에서 task performance와 calibration을 향상시켰음을 보여줍니다. Science Q&A 및 Tool Use와 같은 single-turn 작업에서 PH는 SDPO baseline 대비 validation accuracy를 유지하거나 약간 개선하면서 calibration error를 크게 감소시켰습니다. 특히 Science Q&A에서 late-training OFR은 SDPO의 34.2%에서 PH (α=0.5) 적용 시 20.9%로 감소했으며, surprise rate도 35.2%에서 21.8%로 줄었습니다 [cite: 1, Table 2]. [Figure 2]는 PH 하의 자가 평가 dynamics를 보여주며, overconfident failures가 감소하고 confident successes가 증가하는 것을 확인할 수 있습니다. 또한, 평균 PH weight는 verifier pass rate가 상승함에 따라 감소하여 PH가 prediction-reality gap이 좁혀질수록 자연스럽게 anneal되는 adaptive training signal 역할을 함을 나타냅니다. multi-turn personal-agent task에서는 single-turn과 달리 Underconfident Successes (US)가 지배적인 miscalibration mode로 나타났음에도, PH는 GRPO, OPD, Combined 세 가지 base method 모두에서 성능을 개선했습니다 [cite: 1, Figure 5]. 특히 OPD의 경우 평균 capability 점수가 +15.3 (α=1.0) 향상되었으며, Prospective Accuracy는 RL+PH에서 87.8%, OPD+PH에서 86.3%에 도달했습니다 [cite: 1, Table 3].
4. Conclusion & Impact (결론 및 시사점)
Prospective Hindsight (PH)는 에이전트의 prospective belief와 verifier의 retrospective outcome 사이의 gap을 학습 자원으로 활용하여 retrospective signal이 불충분한 롤아웃에 대한 gradient를 증폭시키는 효과적인 메커니즘을 제공합니다. 이 접근 방식은 에이전트 RL의 hindsight trap을 성공적으로 해결하며, 에이전트의 policy와 자가 모델이 함께 발전하도록 유도합니다.
이 연구는 task performance와 self-calibration을 동시에 최적화하는 신뢰할 수 있는 agent-RL pipeline을 구축하기 위한 중요한 발걸음을 제시합니다. PH는 기존 연구에서 보고된 capability-calibration trade-off를 피하며, single-turn의 overconfident failures와 multi-turn의 underconfident successes와 같이 상이한 miscalibration mode에 성공적으로 대처합니다. self-extinguishing 특성으로 인해 adaptive curriculum 역할을 하며, 다양한 task, base method, model scale에 걸쳐 별도의 tuning 없이 적용 가능하다는 점에서 학계 및 산업계 전반에 걸쳐 더욱 신뢰할 수 있고 calibration된 LLM 에이전트 개발에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
- [논문리뷰] The Confidence Dichotomy: Analyzing and Mitigating Miscalibration in Tool-Use Agents
- [논문리뷰] MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
- [논문리뷰] Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
- [논문리뷰] OPD Before RL: Warm-Starting Rubric-Based RL with On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] Multi-Stream Attention Residuals
- 현재글 : [논문리뷰] Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps
- 다음글 [논문리뷰] Relevance Does Not Imply Applicability: Experience Activation for Personal GUI Agents
댓글