[논문리뷰] Thinking Inertia: LLMs Keep Thinking When Told Not To
링크: 논문 PDF로 바로 열기
The paper "Thinking Inertia: LLMs Keep Thinking When Told Not To" by Dianqiao Lei, Kevin Qinghong Lin, Pan Lu, Philip Torr, and James Zou investigates the "no-thinking" behavior of Large Language Models (LLMs).
Part 1: 요약 본문
저자: Dianqiao Lei, Kevin Qinghong Lin, Pan Lu, Philip Torr, James Zou
1. Key Terms & Definitions (핵심 용어 및 정의)
- Thinking Inertia: LLM이 명시적인 no-thinking control에도 불구하고 가시적인 explicit inference를 지속적으로 보이는 현상을 지칭합니다. 이는 특히 answer space가 넓어질수록 더욱 두드러집니다.
- Empty-Thinking Rate (ETR): LLM의 응답이 엄격하게 answer-only인지 여부를 측정하는 지표입니다. pre-answer text가 전혀 없는 경우 1로 간주됩니다.
- Question–Pre-answer Relevance (QRel.): pre-answer text(T)가 질문(Q)과 얼마나 의미적으로 관련되어 있는지를 측정하는 연속적인 지표입니다. instruction-aware embedding encoder를 사용하여 계산됩니다.
- Explicit Inference Rate (EIR): pre-answer text(T)에 질문(Q)을 해결하는 명시적인 inferential step이 포함되어 있는지를 LLM judge가 분류하여 측정하는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM이 추론 과정에 추가 토큰을 할당하여 성능을 크게 향상시켰지만, 이에 따른 latency 및 token consumption 증가 문제를 해결하기 위한 "no-thinking" 행동에 대한 체계적인 연구가 부족함을 지적합니다. 기존 연구에서는 no-thinking을 주로 thinking mode 비활성화, 긴 추론 trace의 부재, 짧은 응답 길이와 같은 표면적인 proxy를 통해 정의했으나 [cite: 1, Figure 2], 이러한 proxy들은 실제 LLM 응답 내용의 question-conditioned 정보를 신뢰성 있게 반영하지 못합니다 [cite: 1, Figure 2]. 예를 들어, thinking mode를 비활성화해도 여전히 추론 단계를 포함하는 응답이 생성될 수 있으며, 짧은 응답도 핵심적인 inferential step을 담을 수 있습니다 [cite: 1, Figure 2]. 이러한 한계점은 LLM이 언제 직접적으로 응답하고 언제 추론해야 하는지 적응적으로 제어하는 능력에 대한 명확한 이해를 방해하므로, response-level에서 no-thinking을 측정하고 평가하는 새로운 프레임워크가 필요함을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 LLM 응답을 pre-answer text (T)와 final answer (A)로 분해하고, 이를 세 가지 level에서 평가하는 response-centric framework를 제안합니다 [cite: 1, Figure 3]. 첫째, ETR을 통해 엄격한 answer-only compliance를 측정합니다. 둘째, instruction-aware Qwen3-Embedding-4B를 사용하여 QRel.을 측정하여 pre-answer text의 질문 관련성을 평가합니다. 셋째, GPT-5.5를 judge로 활용하여 EIR을 측정, 명시적인 inferential step의 유무를 판단합니다. 이 세 가지 지표는 answer-only output, 관련성 있지만 추론적이지 않은 텍스트, 그리고 명시적인 추론을 분리합니다.
실험 결과, 명시적인 no-think control이 가시적인 explicit inference를 안정적으로 제거하지 못한다는 "Thinking Inertia" 현상을 발견했습니다. 특히, answer space가 Boolean task에서 multiple-choice, open-ended task로 확장될수록 visible explicit inference가 점진적으로 증가했습니다 [cite: 1, Figure 4, Figure 5]. 예를 들어, DeepSeek-V4-Flash (284B) 모델은 disabled-thinking 설정에서도 open-ended 응답의 99.9%에서 visible explicit inference를 유지했습니다. 또한, open-ended task에서는 stronger answer-only instruction이 answer-only compliance를 향상시키고 visible inference를 감소시켰지만, task accuracy를 약 15 percentage points 감소시키는 trade-off가 발생했습니다 [cite: 1, Figure 5]. 반면, Boolean 및 multiple-choice task에서는 accuracy가 비교적 안정적으로 유지되었습니다. Answer interface를 변경하는 실험에서는 동일한 질문에 대해서도 candidate answer가 제공되는 Boolean verification이나 multiple-choice format이 open-ended generation보다 answer-only 응답을 생성하기 훨씬 용이하게 만들었습니다 [cite: 1, Figure 6].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 LLM의 "no-thinking" 능력을 표면적인 proxy가 아닌 observable response behavior로 정의하고 평가하는 체계적인 프레임워크를 제시합니다. 핵심적으로 LLM은 명시적인 no-think 지시에도 불구하고 "Thinking Inertia"를 보이며 visible explicit inference를 완전히 억제하기 어렵고, 이러한 경향은 answer space의 개방성에 크게 의존함을 밝혀냈습니다. 특히 open-ended task에서는 answer-only compliance와 task accuracy 사이에 trade-off가 존재함이 확인되었습니다. 이러한 발견은 LLM이 인간처럼 필요에 따라 추론 여부를 적응적으로 결정할 수 있도록 개발하기 위해서는, 단순히 추론 trace를 숨기거나 짧은 출력을 강제하는 것 이상으로, 태스크의 구조적 지원과 연계하여 직접적인 답변이 실제로 지원되는지 평가하는 것이 중요함을 시사합니다. 이는 향후 LLM의 효율성, 제어 가능성 및 인간과 유사한 적응형 추론 능력 개발에 중요한 기초를 제공할 것입니다.
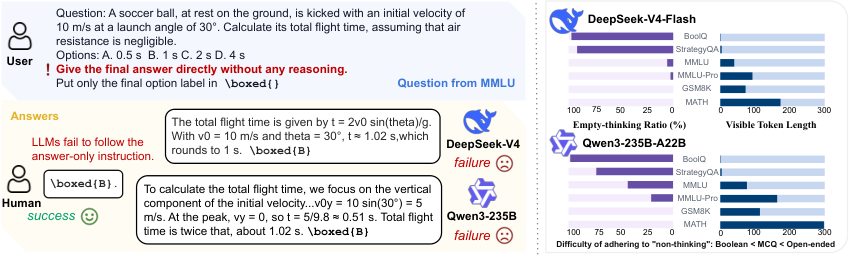
Figure 1 — No-thinking control 실패
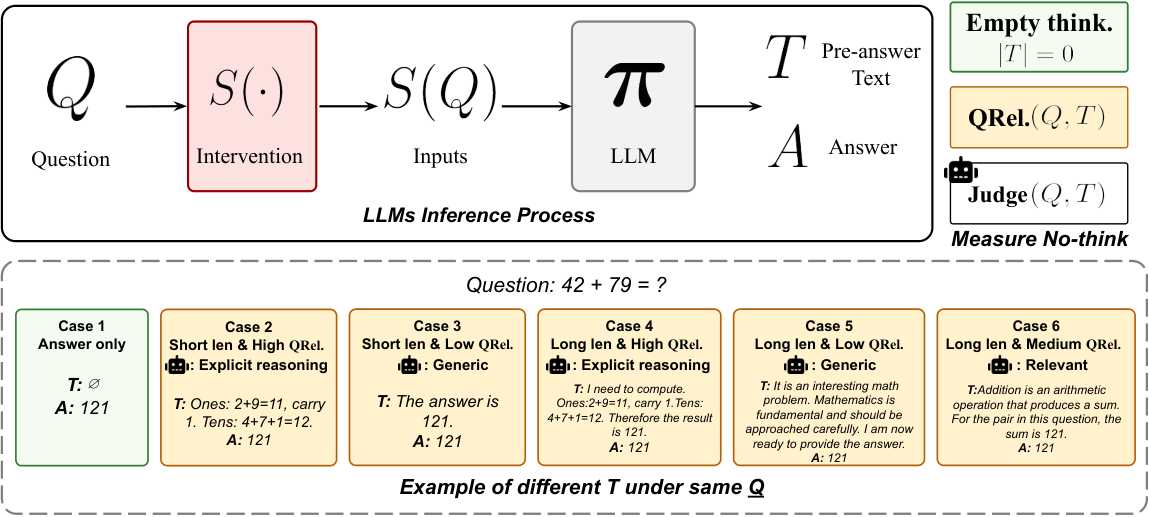
Figure 3 — No-thinking 측정 지표
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Instruction-Following Evaluation in Function Calling for Large Language Models
- [논문리뷰] LSRIF: Logic-Structured Reinforcement Learning for Instruction Following
- [논문리뷰] Do You Hear What I Mean? Quantifying the Instruction-Perception Gap in Instruction-Guided Expressive Text-To-Speech Systems
- [논문리뷰] Inverse IFEval: Can LLMs Unlearn Stubborn Training Conventions to Follow Real Instructions?
- [논문리뷰] Light-IF: Endowing LLMs with Generalizable Reasoning via Preview and Self-Checking for Complex Instruction Following
Review 의 다른글
- 이전글 [논문리뷰] T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
- 현재글 : [논문리뷰] Thinking Inertia: LLMs Keep Thinking When Told Not To
- 다음글 [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
댓글