[논문리뷰] LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
링크: 논문 PDF로 바로 열기
메타데이터
저자: Riccardo De Santi, Federico Di Gennaro, Angelo Gnazzo, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LLM-to-Flow Distillation (LFD): LLM이 도메인 특화 생성 모델(예: Flow model)의 teacher 역할을 수행하여, 자연어로 주어진 과학적 목표를 학습하도록 유도하는 프레임워크입니다.
- Observables (𝒪(x)): 모델이 생성한 과학적 설계(예: 펩타이드 서열, 분자 구조)로부터 추출 가능한 수치적 특성으로, LLM이 설계물의 품질을 추론할 수 있게 하는 중간 매개체입니다.
- dDPO (distilled Direct Preference Optimization): LLM의 판단을 통해 생성된 선호도 데이터(Preferences)를 활용하여 생성 모델을 최적화하는 기법으로, LFD에서 생성 모델의 파라미터를 업데이트하는 핵심 수단입니다.
- Discovery Region (Ωg): 자연어 목표(Goal, g)가 유도하는 설계 공간 내의 영역으로, 생성 모델이 최종적으로 도달하고자 하는 목표 분포를 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 도메인 특화 생성 모델을 명시적인 보상 함수(Proxy Reward) 없이 자연어 기반의 과학적 탐색 목표에 직접 정렬(Align)하는 문제를 해결합니다. 기존 연구들은 Flow나 Diffusion 모델을 fine-tuning하기 위해 명시적인 보상 함수가 필요했으나, 복잡한 과학적 영역에서는 신뢰할 수 있는 보상 함수를 정의하기 어렵다는 한계가 있습니다 [Figure 1]. 또한, 기존 생성 모델은 LLM이 가진 고차원적인 과학적 지식을 해석하지 못하며, 목표로 하는 발견 영역이 모델의 초기 확률 분포에서 매우 멀리 떨어져 있을 경우 학습 신호가 부족하다는 문제가 존재합니다. 따라서 저자들은 LLM을 Adaptive Teacher로 활용하여 생성 모델을 점진적으로 목표 영역으로 유도하는 새로운 Distillation 기법을 제안합니다 [Figure 2].
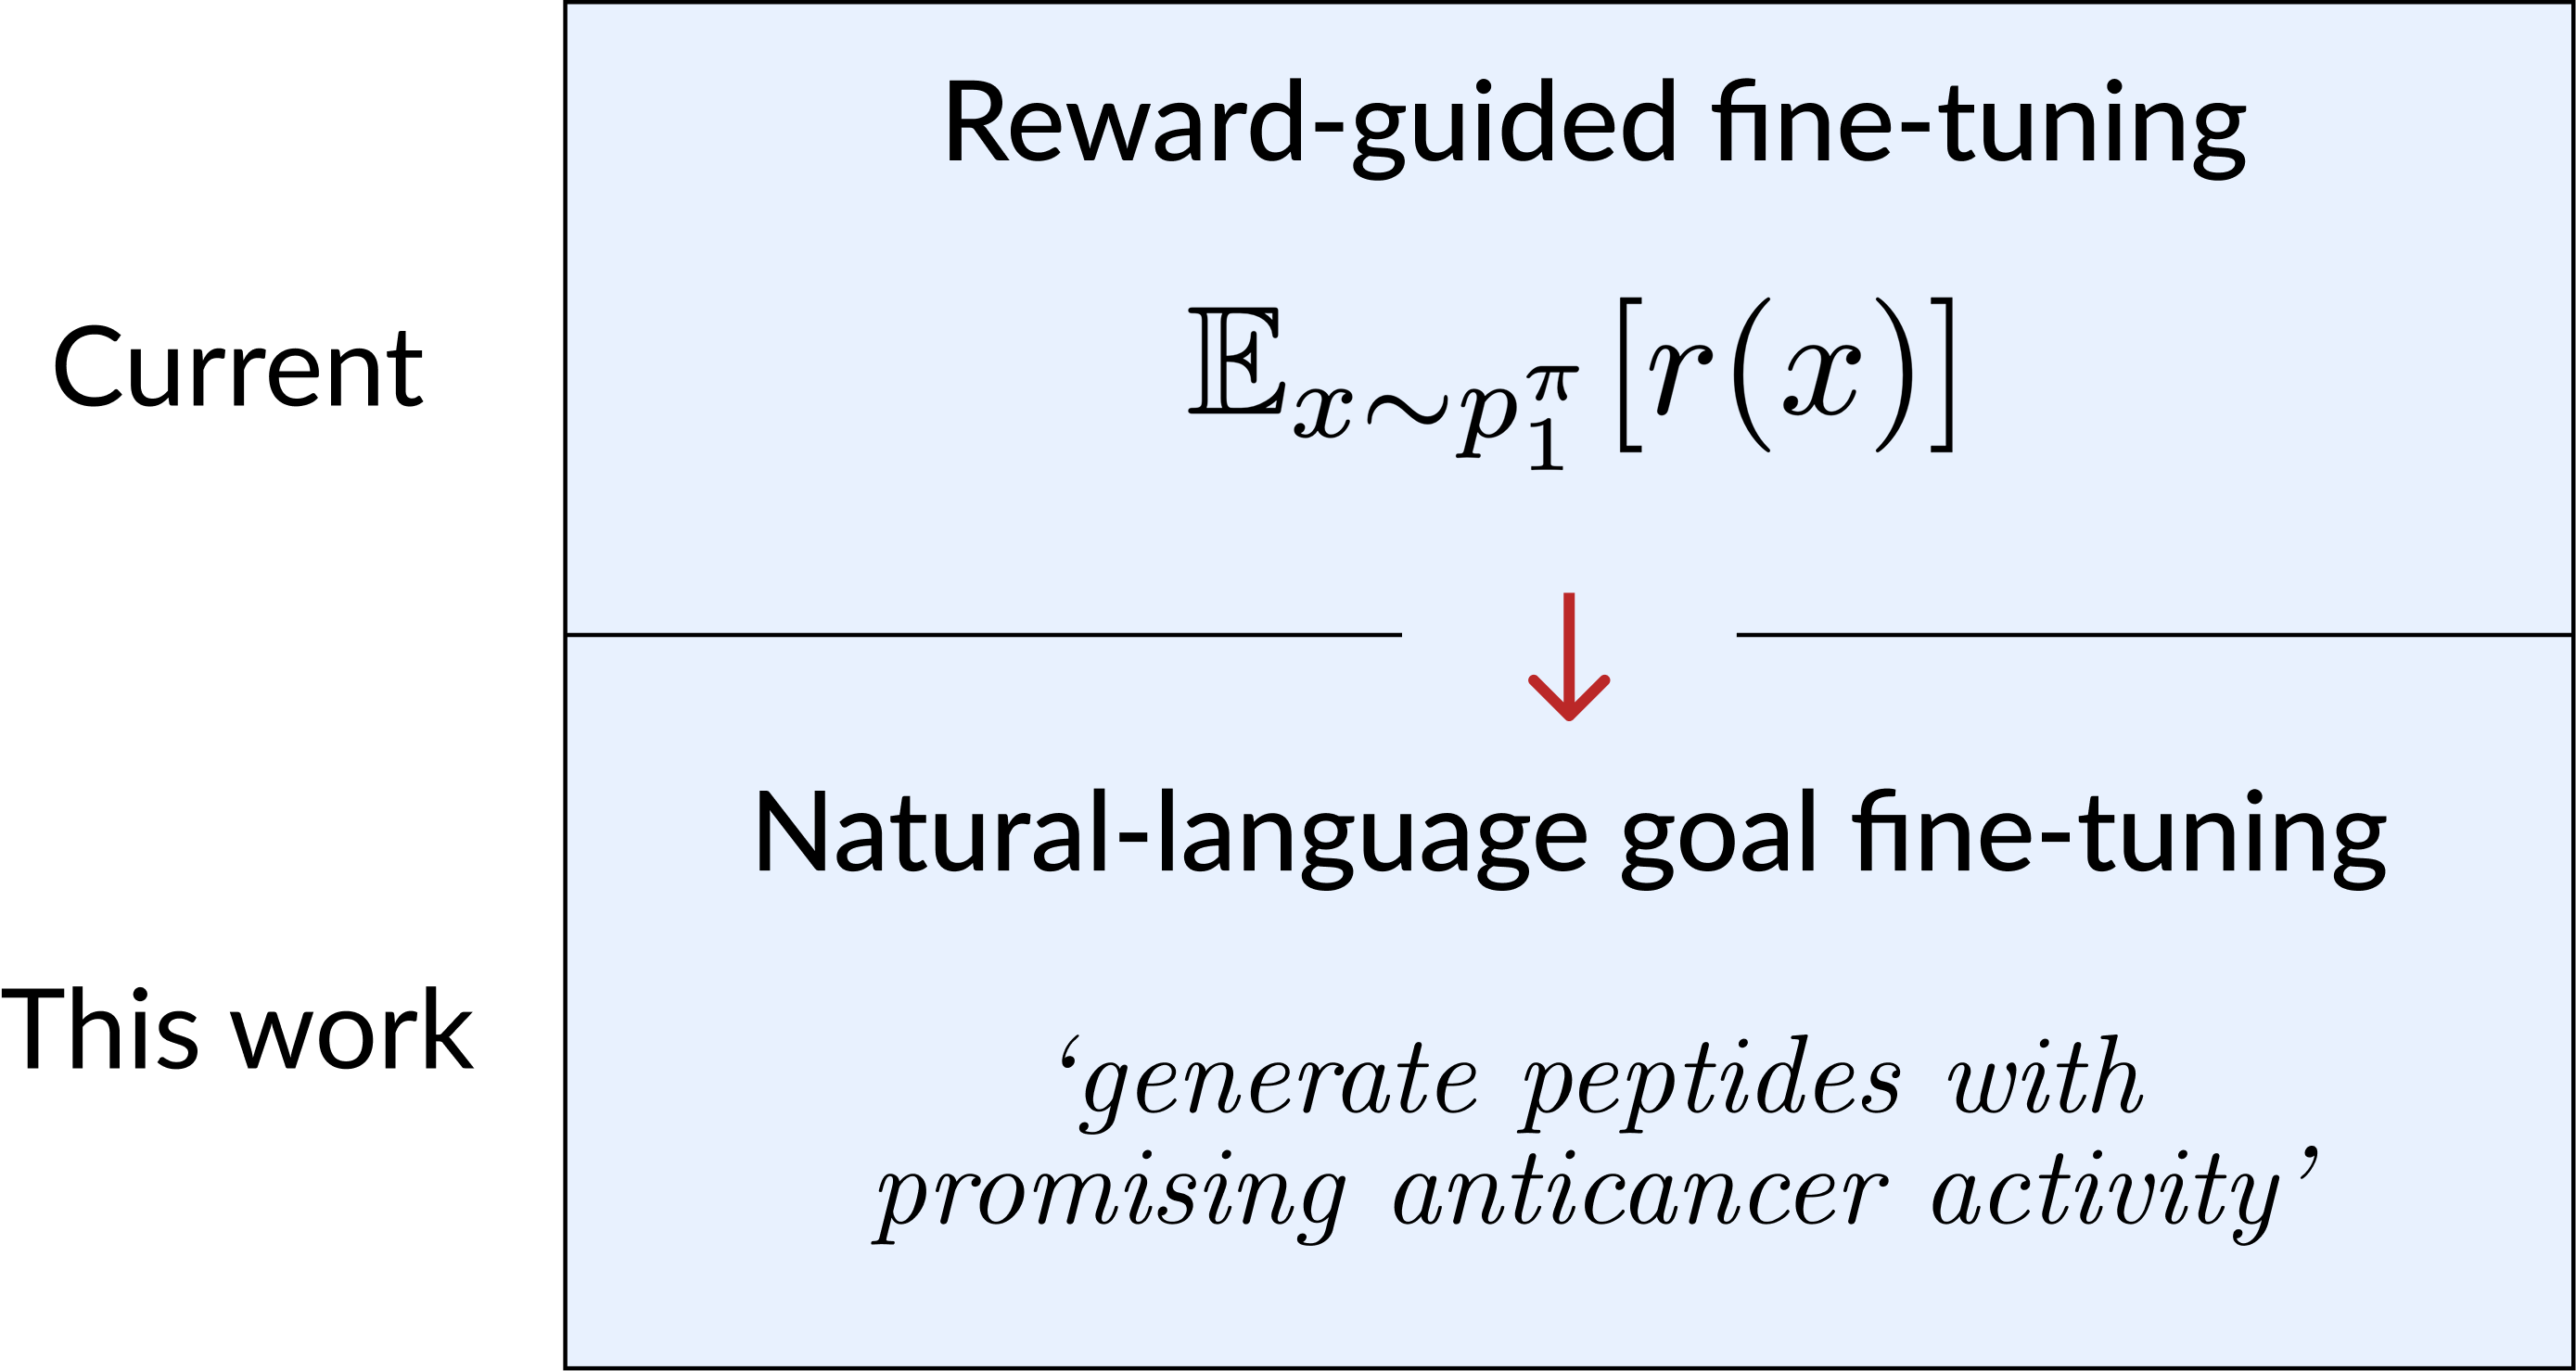
Figure 1 — 자연어 기반 모델 정렬 개념도
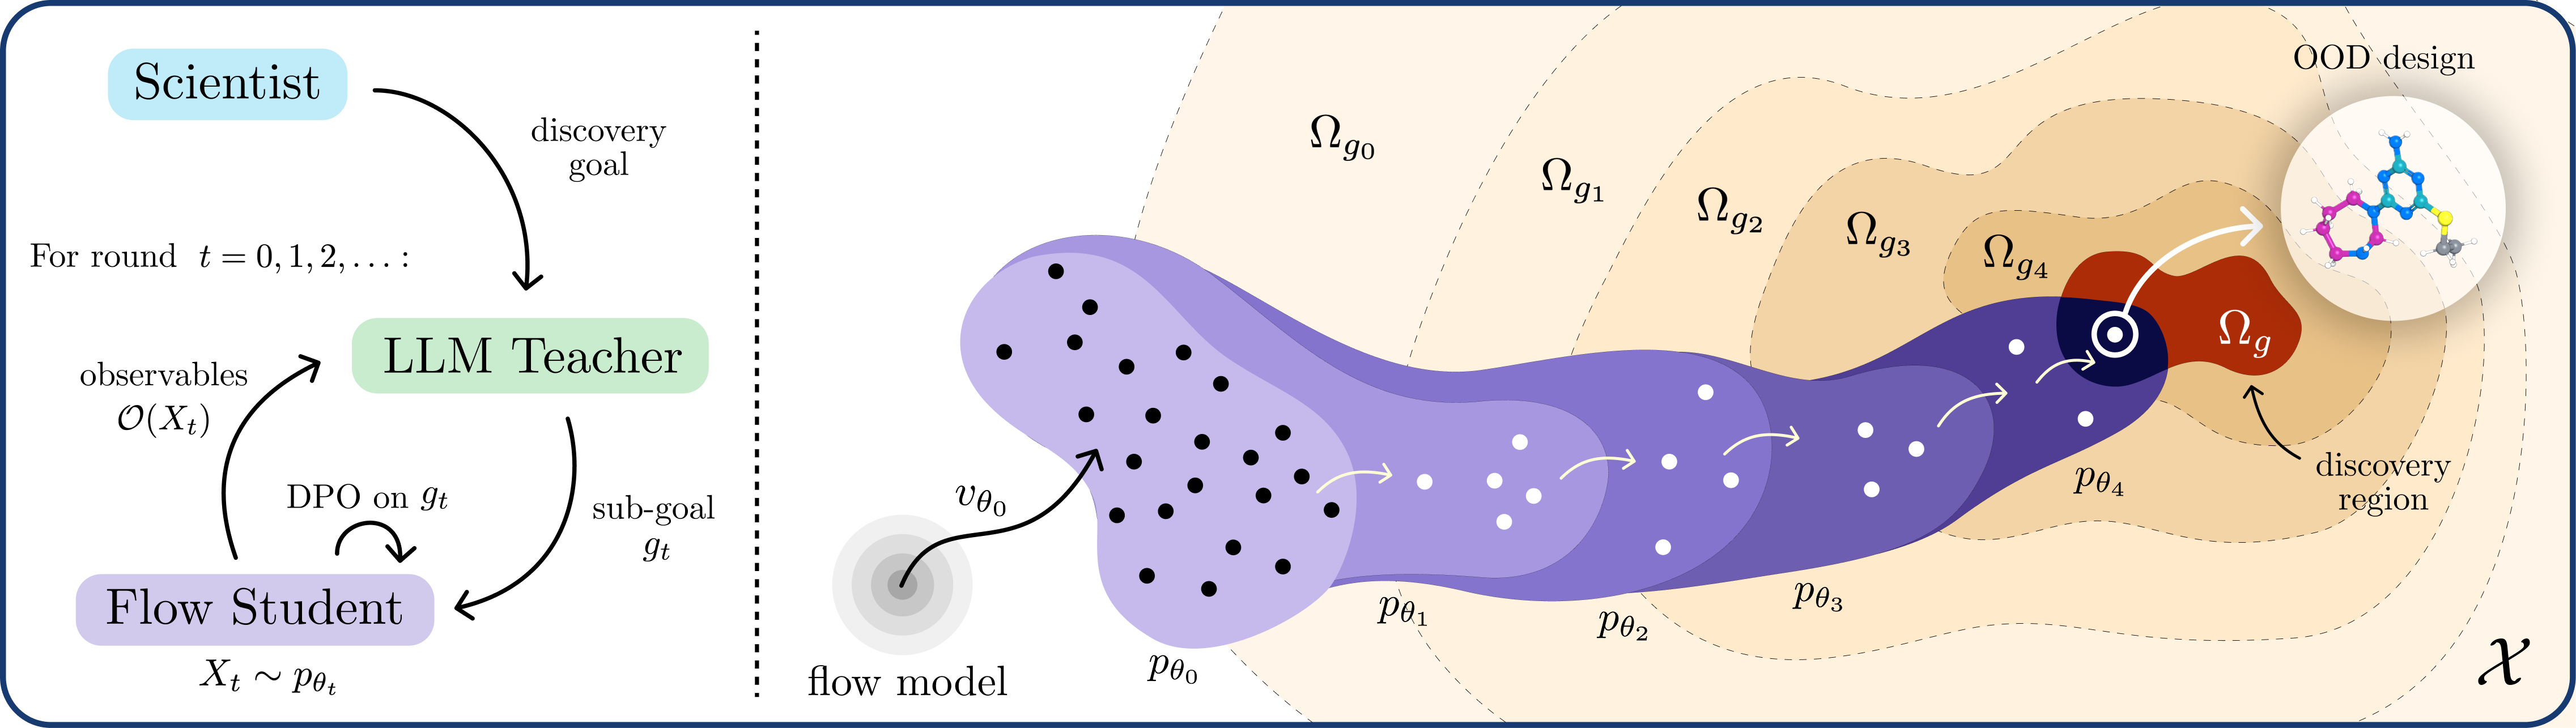
Figure 2 — LFD의 전체 아키텍처 및 커리큘럼 방식
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 LLM이 설계물의 절대적인 품질 점수를 추정하는 데는 미흡하지만, 설계물 간의 상대적인 우열을 가리는 'ordinal signal'을 제공하는 데는 매우 탁월하다는 점에 착안하여 LFD를 설계했습니다 [Figure 3]. LFD는 매 학습 라운드마다 현재 생성 모델의 기능적 도달 범위를 관찰하고, LLM이 이를 바탕으로 중간 단계의 'Sub-goal'을 생성하는 커리큘럼 기반 학습을 수행합니다. 생성 모델은 이 Sub-goal에 따라 샘플링을 진행하고, LLM의 피드백을 통해 획득한 선호도 데이터를 dDPO를 사용하여 자신의 파라미터를 업데이트합니다. 실험 결과, LFD는 기존의 보상 기반(Reward-guided) Baseline 모델들 대비 우수한 성능을 보였으며, 특히 보상 함수가 정의되기 어려운 Out-of-Distribution 영역에서 높은 적응력을 나타냈습니다. 정량적 지표로 평가된 Pairwise Accuracy 및 발견 성공률(Discovery success rate)에서 보상 기반 기법보다 뛰어난 정렬 성능을 입증하였습니다.
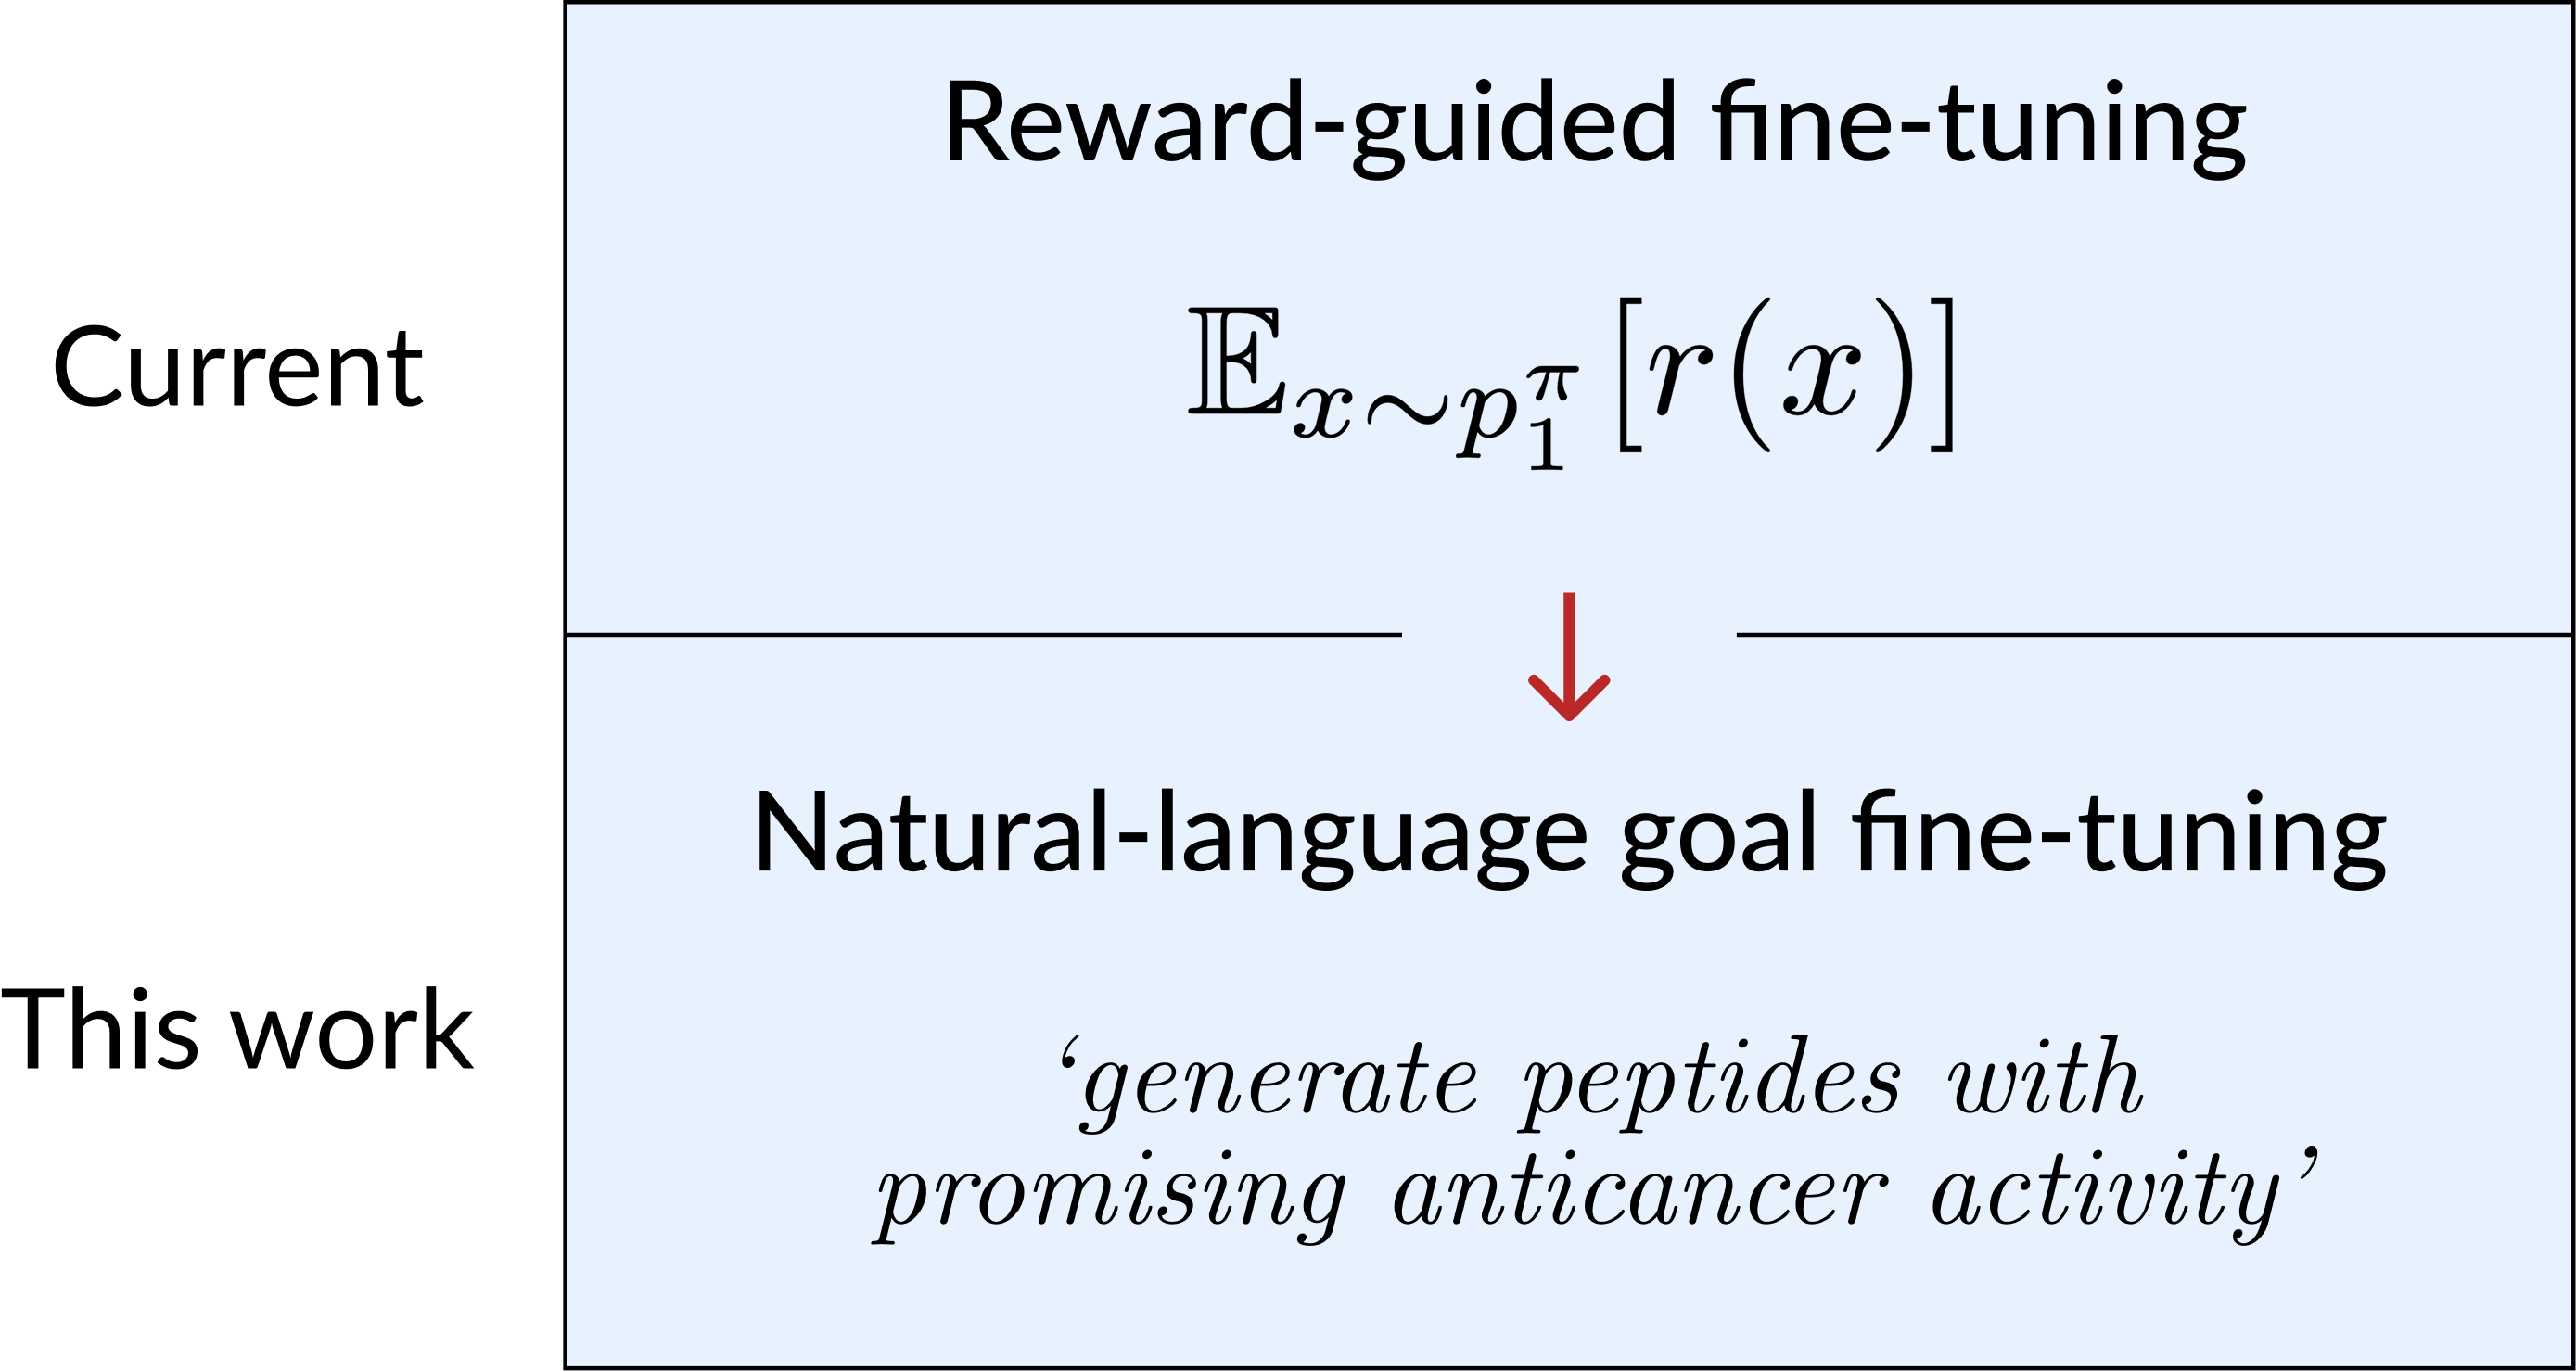
Figure 3 — LLM의 과학적 피드백 신뢰도 분석
4. Conclusion & Impact (결론 및 시사점)
본 연구는 자연어 목표를 사용하여 전문 과학 생성 모델을 직접 제어할 수 있는 새로운 패러다임을 제시합니다. 이 접근 방식은 명시적인 보상 모델 설계 없이도 LLM의 추론 능력을 도메인 특화 생성 모델에 성공적으로 이식할 수 있음을 보여줍니다. 향후 제약 바이오, 신소재 설계 등 복잡한 과학적 발견 과정에서 인간의 의도를 직관적으로 생성 모델에 반영하는 핵심 기술로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
- [논문리뷰] AdvSim2Real : Training Web Agents Against Adaptive Prompt Injection in a Web World Model
- [논문리뷰] LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
- [논문리뷰] False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents
- [논문리뷰] Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
Review 의 다른글
- 이전글 [논문리뷰] KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
- 현재글 : [논문리뷰] LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
- 다음글 [논문리뷰] LabInstruct: Benchmarking Situated Instructional Video Generation for Lab Procedures
댓글