[논문리뷰] SWEeper-Bench: Can Agents Discover Bugs in Interactive Software?
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yang Yao, Haozhe Chen, Bingyi Kang, Karthik R Narasimhan, Zhuang Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- SWEeper-Bench: 소프트웨어의 버그를 사전에 발견하고 수정하는 능력을 평가하기 위해 제안된 200개의 실무 기반 작업 벤치마크입니다.
- Agentic Verifier: 에이전트가 수행한 수정 사항을 실제 브라우저 환경에서 실행하고, 사용자가 관찰하는 기능적 변화를 기반으로 검증하는 시스템입니다.
- Target/Preservation Behavior Tests: 각각 버그를 재현하고 의도된 기능이 복구되었는지 확인하는 테스트와 주변 기능이 영향을 받지 않았는지 검증하는 테스트입니다.
- Open-Ended Prompt: 버그의 존재나 위치를 명시하지 않고, 제품 영역만을 제시하여 에이전트가 능동적으로 문제를 발견하고 탐색하도록 유도하는 프롬프트 형식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 소프트웨어 공학 벤치마크가 사용자의 버그 신고 이후의 수정 능력만을 평가하는 한계에서 벗어나, 에이전트가 스스로 버그를 발견할 수 있는지 측정하는 것을 목표로 합니다. 기존 연구(Baseline)들은 이미 식별된 이슈를 처리하는 데 집중하며, 내부 상태 기반의 Hidden Unit Test를 사용하여 사용자 관점의 실제 버그를 놓칠 가능성이 큽니다 [Figure 1]. 특히 상호작용이 복잡한 소프트웨어의 경우, 특정 사용자 시퀀스에서만 발생하는 버그는 코드만으로는 파악하기 어려우며, 이를 발견하지 못한 채 에이전트가 개발을 진행할 경우 사용자 경험이 크게 저해됩니다 [Figure 1].
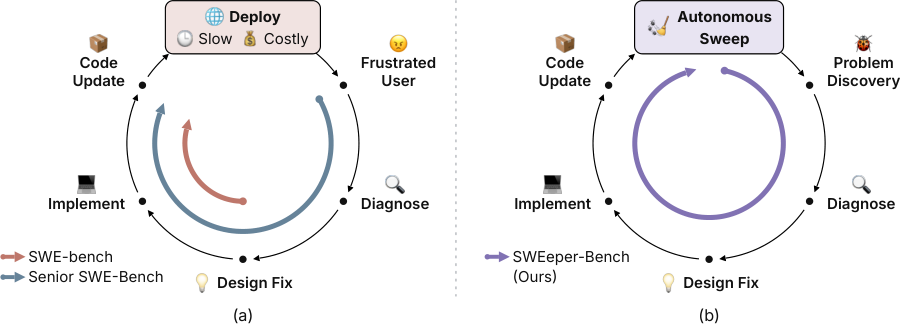
Figure 1 — 수동 버그 신고와 자동 버그 발견 프로세스 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 에이전트가 코드와 함께 브라우저 환경에서 실시간으로 소프트웨어를 탐색하고 상호작용하여 문제를 진단하는 SWEeper-Bench 프레임워크를 제안합니다 [Figure 3]. 제안된 Agentic Verifier는 에이전트의 패치를 적용한 후, 실제 사용자의 동작을 재현하는 테스트 시나리오를 실행하여 성공 여부를 판별합니다 [Figure 3]. 15개의 Frontier Agent를 대상으로 실험한 결과, 최고 성능을 보인 모델조차 59.0%의 Pass Rate를 기록하는 데 그쳤으며, 이는 에이전트가 버그를 발견하고 테스트하는 과정에서 큰 병목이 존재함을 시사합니다 [Table 2]. 특히, 에이전트들은 버그가 포함된 Feature에 도달하는 비율은 75.4%에 달했으나, 실제 버그 동작을 인지하는 비율은 50.0%로 급격히 하락했습니다 [Figure 7]. 상세 버그 설명이 제공되는 경우 Pass Rate가 96% 이상으로 상승하는 것으로 보아, 현재 에이전트의 수정(Repair) 능력은 뛰어나나 발견(Discovery) 단계에서의 인지 능력이 주요 해결 과제임을 확인하였습니다 [Table 4].
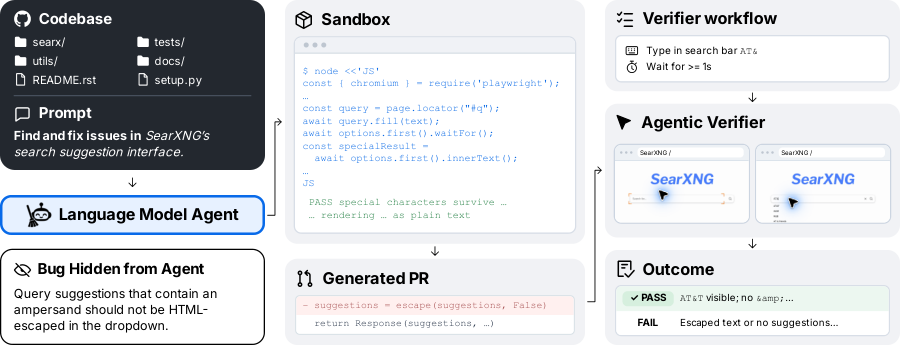
Figure 3 — SWEeper-Bench 작업 실행 및 검증 파이프라인
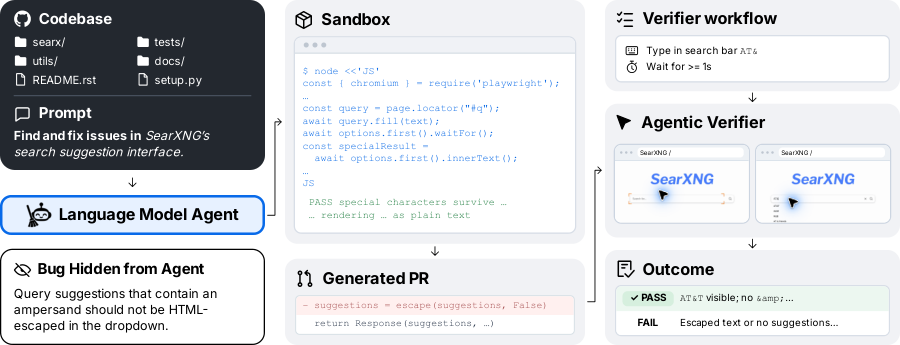
Figure 7 — 에이전트 단계별 버그 발견 성공률
4. Conclusion & Impact (결론 및 시사점)
본 논문은 에이전트가 스스로 소프트웨어의 잠재적 버그를 발견하고 수정하는 능력을 평가하는 새로운 이정표를 제시합니다. 연구 결과, 에이전트들은 버그 수정 능력은 뛰어나지만, 실제 실행 환경에서의 테스트 및 버그 인지 능력은 여전히 불충분함이 밝혀졌습니다. 이러한 발견은 향후 에이전트가 독립적으로 고품질 소프트웨어를 배포하기 위해 반드시 극복해야 할 지점을 명확히 짚어주며, 향후 연구자들이 사용자 관점의 기능 검증 능력을 높이는 방향으로 에이전트 학습을 설계하도록 기여합니다.
Part 2: 중요 Figure 정보

Figure 1 — 수동 버그 신고와 자동 버그 발견 프로세스 비교

Figure 3 — SWEeper-Bench 작업 실행 및 검증 파이프라인
Figure 7 — 에이전트 단계별 버그 발견 성공률
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWE-EVO: Benchmarking Coding Agents in Long-Horizon Software Evolution Scenarios
- [논문리뷰] SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
- [논문리뷰] ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
- [논문리뷰] ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
- [논문리뷰] SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents
Review 의 다른글
- 이전글 [논문리뷰] RuleTrek: Benchmarking Agentic Rule Reasoning in Complex Scenarios
- 현재글 : [논문리뷰] SWEeper-Bench: Can Agents Discover Bugs in Interactive Software?
- 다음글 [논문리뷰] SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving
댓글