[논문리뷰] RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
링크: 논문 PDF로 바로 열기
메타데이터
저자: Haonan Han, Yukang Lin, Minliang Lin, Haoxian Tan, Jun-Yan He, Rui Yang, Zhi-Qi Cheng, Jie Hu, Guanglu Wan, Xiu Li
1. Key Terms & Definitions (핵심 용어 및 정의)
- RAP (Reconstruct A Poster): 본 논문에서 제안하는 25,435개의 verified paper-poster 쌍으로 구성된 대규모 데이터셋 및 벤치마크입니다.
- Derendering Pipeline: 래스터 형태의 포스터 이미지를 편집 가능한 HTML/CSS로 자동 변환하는 파이프라인으로, 텍스트, 이미지, 수식 등 콘텐츠를 재배치 가능한 슬롯으로 분해합니다.
- PosterRAG: 데이터셋 내의 포스터들을 재사용 가능한 디자인 라이브러리로 활용하여, 적합한 템플릿을 검색하고 콘텐츠를 리필(refill)하는 Training-free 방식의 멀티 에이전트 프레임워크입니다.
- Render-and-Compare: 포스터 생성 모델을 평가할 때, 기존의 주관적인 VLM 점수 대신 실제 렌더링된 결과물과 원본 인간 제작 포스터를 직접 비교하는 객관적 평가 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 학술 포스터 제작을 Visual Coding의 일종으로 정의하고, 기존 포스터 생성 벤치마크들의 데이터 부족 및 평가 방식의 한계를 해결하고자 합니다. 기존 연구들은 레이아웃 박스 수준의 정보만 제공하거나, 모델이 처음부터 레이아웃을 생성하도록 하여 전문적인 디자인 지식 반영이 어렵다는 문제가 있었습니다 [Figure 1]. 또한, 객관적인 정량 평가 대신 VLM이나 사람의 주관적 판단에 의존함으로써 재현성과 통계적 강건성이 결여되어 있었습니다. 이에 저자들은 대규모의 검증 가능한(verifiable) 데이터셋과 이를 활용한 새로운 생성 및 학습 프레임워크가 필요하다고 판단했습니다.
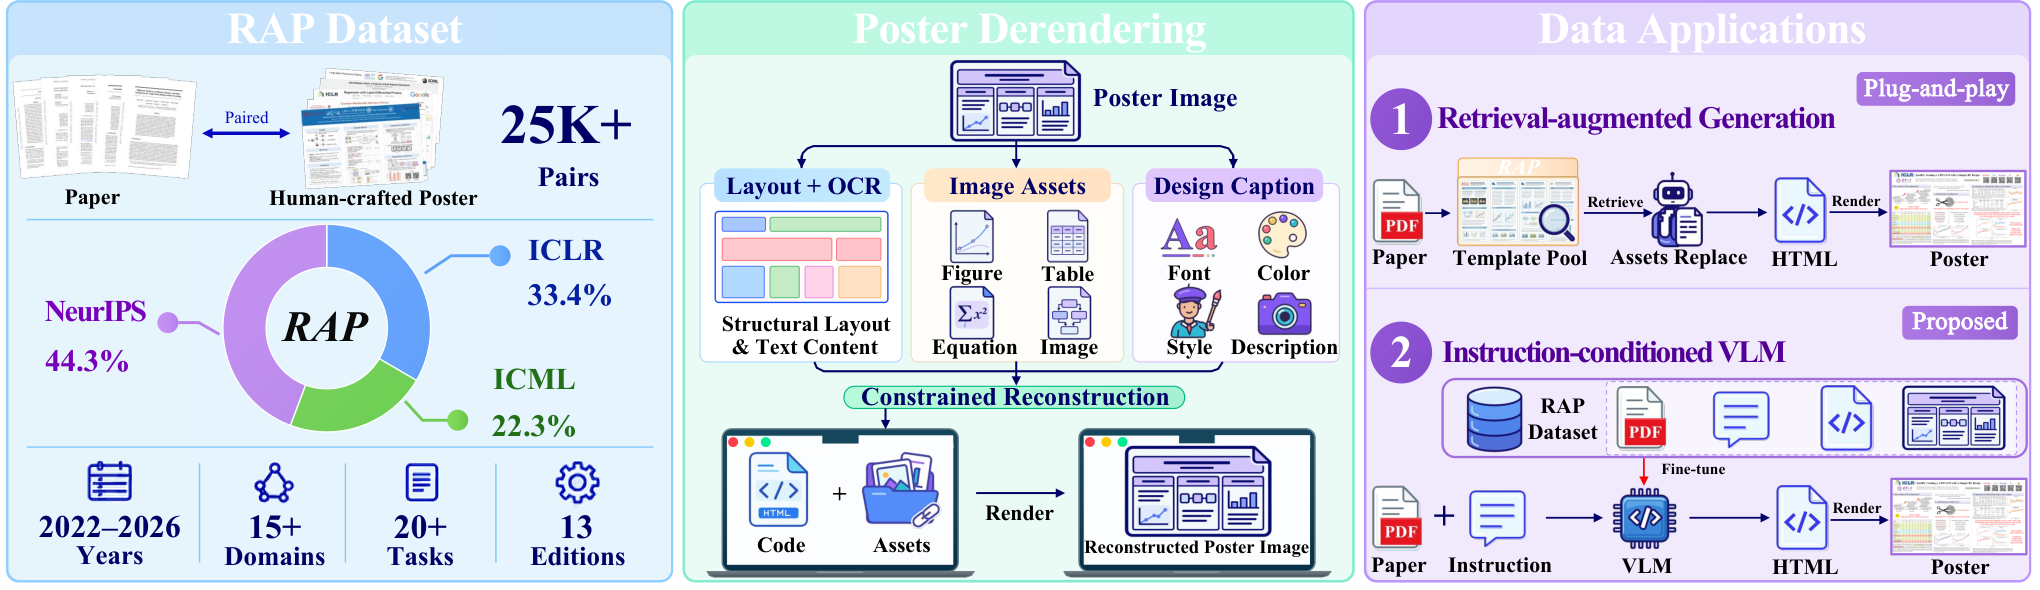
Figure 1 — RAP 데이터셋 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 대규모 데이터셋인 RAP를 구축하고, 이를 기반으로 PosterRAG와 SFT+RL 기반의 모델 학습 방법론을 제안합니다. PosterRAG는 카테고리 필터링, 서사적 유사성(Narrative Matching), 심미적 선택(Aesthetic Selection)의 3단계 검색 캐스케이드를 통해 최적의 템플릿을 선별하고, MappingAgent가 콘텐츠를 프로그래밍 방식으로 삽입합니다 [Figure 3]. Post-training 단계에서는 SFT(Supervised Fine-Tuning) 후, GRPO를 이용한 렌더링 인식 강화학습을 수행하여 유효한 HTML 생성률을 높이고 구조적 완성도를 보장합니다 [Figure 4].
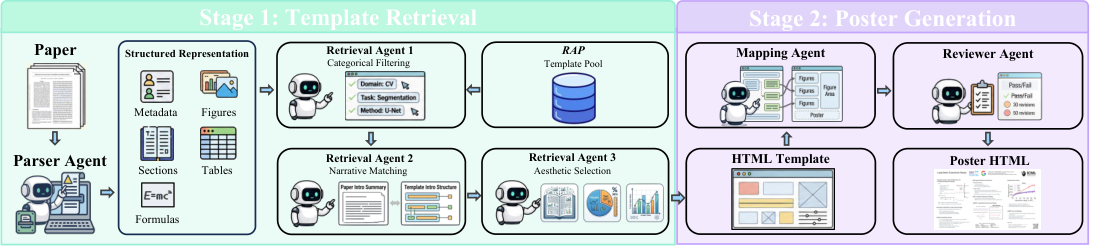
Figure 3 — PosterRAG 파이프라인
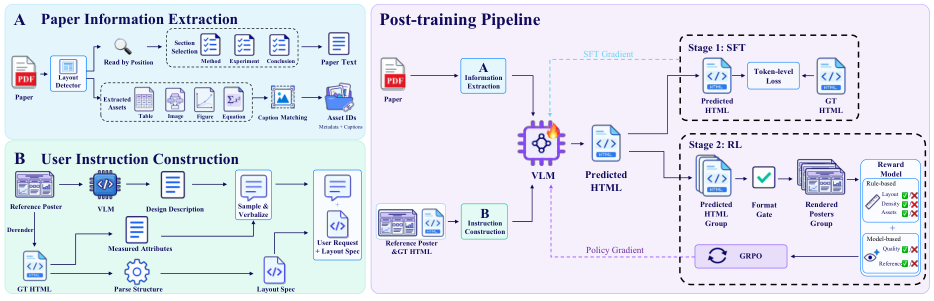
Figure 4 — 포스트 트레이닝 파이프라인
주요 실험 결과, 제안하는 방법론들은 기존 베이스라인(Nano Banana, P2P 등) 대비 우수한 생성 성능을 입증했습니다. 특히 FID 및 FDiD와 같은 분포 수준의 측정 지표에서 인간이 제작한 포스터와의 분포 간극을 획기적으로 줄였으며, LPIPS 및 DISTS 지표에서도 높은 생성 다양성을 유지하며 SOTA 성능을 달성했습니다. 본 방법론은 전문적인 디자인 레이아웃을 훼손하지 않으면서도 다양한 논문 내용을 일관되게 포스터로 변환하는 데 성공했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 학술 논문에서 포스터를 생성하는 작업을 Visual Coding 분야의 핵심적인 벤치마크로 격상시켰습니다. 25,435개의 대규모 데이터셋 RAP와 자동화된 Derendering Pipeline은 향후 연구자들이 더 정교한 멀티모달 모델을 개발할 수 있는 견고한 토대를 제공합니다. 특히 Training-free 방식의 PosterRAG와 SFT+RL 모델은 실제 산업 현장이나 학계에서 논문 요약 및 발표 자료 제작의 효율성을 크게 증진시킬 것으로 기대됩니다. 본 연구가 제시한 데이터셋과 평가 패러다임은 향후 더 복잡한 문서 변환 및 자동 디자인 생성 연구에 중요한 표준이 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
- 현재글 : [논문리뷰] RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
- 다음글 [논문리뷰] ReaDy: Recurrent States as Dynamic Context for Speculative Drafting in Hybrid Linear Attention Large Language Models
댓글