[논문리뷰] Remembering Has a Price: Learning Memory Worth under Resource Constraints
링크: 논문 PDF로 바로 열기
저자: Guannan Lai, Zi-Yang Bai, Jun-Peng Jiang, Han-Jia Ye
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- TokenWorth: 리소스가 제한된 환경에서 온라인 실행 피드백을 통해 쿼리 의존적 메모리 가치를 학습하는 경량 메모리 프레임워크입니다.
- Resource-Constrained Lifelong Agent: generation, interaction, memory capacity가 엄격하게 제한된 환경에서 지속적으로 학습 및 적응해야 하는 에이전트입니다.
- RFM (Recursive Feature Machine): 비선형 및 쿼리 특화 메모리 가치 추정을 위해 잔차 학습을 수행하는 모델로, AGOP를 사용하여 특징 기하구조를 적응적으로 학습합니다.
- Memory Worth: 특정 쿼리와 태스크 결과에 기반하여, 해당 메모리가 향후 태스크 수행에 얼마나 유용한지를 정량화한 지표입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 엄격한 자원 제약 환경에서 기존의 많은 lifelong-memory 방식이 단순 검색이나 메모리가 없는 에이전트보다 성능이 저하되거나 미미한 향상만을 보이는 문제점을 해결하고자 합니다. 자원이 제한된 환경에서는 메모리 용량 부족보다 '어떤 경험을 기억하고 재사용할 것인가'에 대한 결정이 더 중요해집니다. 관련성 높은 메모리라 할지라도 실질적인 downstream utility가 낮으면 제한된 문맥(context)을 낭비하여 성능을 저해하기 때문입니다. 따라서 저자들은 단순히 relevance를 찾는 것을 넘어, 제한된 자원에서 최대의 효과를 낼 수 있는 '가치 있는 기억'을 선별하는 것이 핵심 과제임을 명시합니다. [Figure 1]은 이러한 자원 제약 환경에서의 에이전트 운영 모델과 기존 방식 대비 효율성의 차이를 시각적으로 보여줍니다.
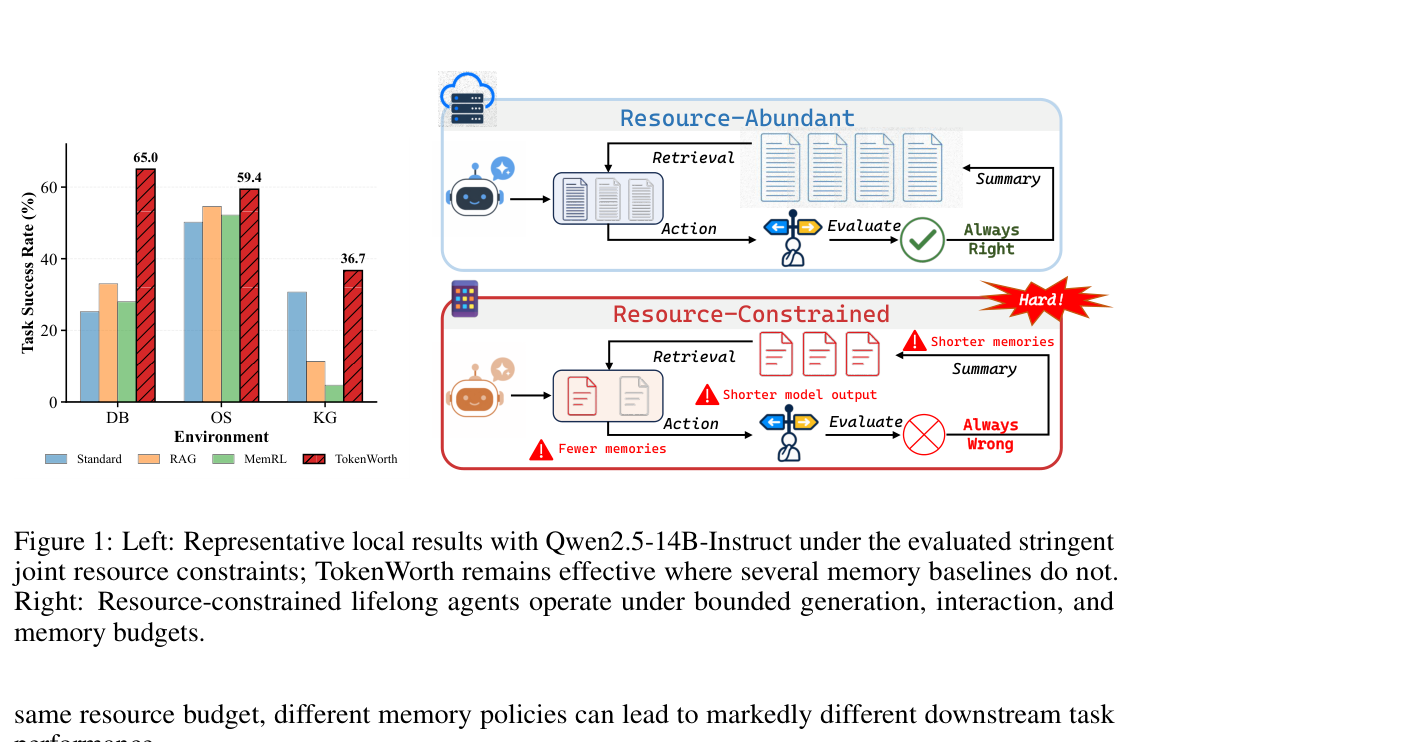
Figure 1 — 제안 방법론의 성능 우위와 자원 제약 환경에서의 운영 개념을 보여주는 핵심 도표
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 TokenWorth 프레임워크를 통해 메모리의 가치를 query-dependent하게 추정하고 이를 기반으로 메모리 검색 및 관리를 최적화합니다. 제안 방법론은 두 가지 보완적 컴포넌트를 사용하는데, 우선 안정적인 글로벌 패턴을 학습하는 선형 base scorer를 배치하고, 그 위에 RFM 기반의 비선형 잔차 학습 모델을 결합하여 정교한 가치 추정을 수행합니다. 특히 AGOP 기반의 두 가지 타임스케일 적응(fast residual adaptation 및 slow geometry adaptation)을 통해 sparse한 실행 피드백으로부터 효율적으로 학습합니다. 성능 평가 결과, TokenWorth는 LifelongAgentBench 환경에서 모든 경쟁 방식을 상회하며 가장 높은 Task Success Rate를 기록했습니다. 또한 모든 실험 조건에서 가장 적은 수의 output tokens를 사용하여 세대 효율성(generation efficiency) 면에서도 압도적인 우위를 보였습니다. [Table 1]은 다양한 환경 및 배포 방식(local vs API)에서 본 방법론이 달성한 우수한 task success rate 수치를 입증합니다.
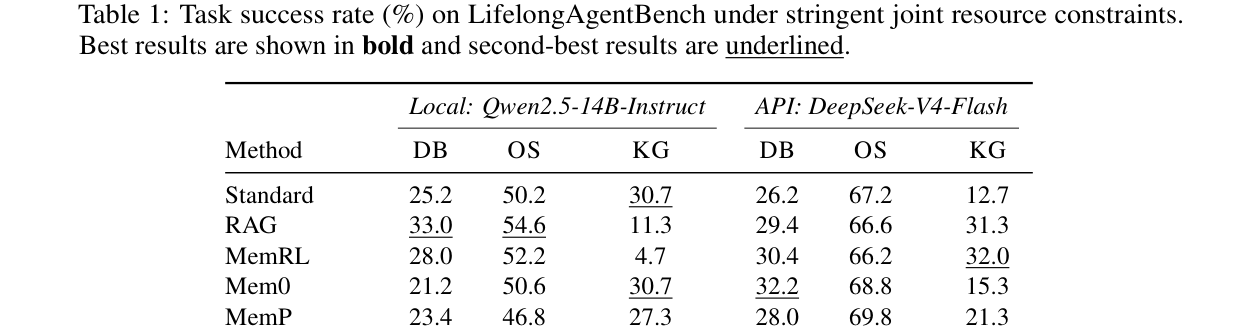
Table 1 — 다양한 환경과 모델 환경에서 제안된 모델이 경쟁 모델 대비 우수함을 보여주는 정량적 결과
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 자원이 제한된 환경에서의 lifelong adaptation은 기억의 양보다 '무엇이 기억할 가치가 있는가'를 결정하는 능력에 달려 있음을 입증하며, 이를 해결하기 위한 TokenWorth 프레임워크를 제안하였습니다. 본 연구는 LLM 기반 에이전트가 현실적인 자원 제약하에서도 지속적인 성능 향상을 이룰 수 있는 실용적인 경로를 제시했습니다. 이러한 접근은 연산 자원이 부족한 엣지 디바이스 환경이나 API 비용 최적화가 필수적인 대규모 에이전트 시스템 배포에 중요한 시사점을 제공합니다. 향후 연구에서는 메모리 기여도에 대한 더욱 정교한 크레딧 할당(credit assignment) 방식을 통해 에이전트의 적응력을 더욱 높일 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DigiData: Training and Evaluating General-Purpose Mobile Control Agents
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] World Model Interpretability: From Decoding Representations to Understanding Latent Worlds
- [논문리뷰] Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
- [논문리뷰] UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
Review 의 다른글
- 이전글 [논문리뷰] Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
- 현재글 : [논문리뷰] Remembering Has a Price: Learning Memory Worth under Resource Constraints
- 다음글 [논문리뷰] RoAR-VAE: Improving Latent Diffusability through Robust Prediction
댓글