[논문리뷰] Looped Uniform Diffusion Language Models
링크: 논문 PDF로 바로 열기
저자: Saiteja Utpala, Chieh-Hsin Lai, Yuki Mitsufuji, Praneeth Vepakomma, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- UDLMs (Uniform Diffusion Language Models): 토큰을 확률적으로 무작위 토큰으로 치환하여 손상된 시퀀스를 생성하고, 이를 반복적으로 denoising하는 방식의 Discrete diffusion language models입니다.
- Looped Transformers: 특정 Transformer 블록들을 고정된 가중치로 여러 번 재사용(loop)하여 파라미터 증가 없이 모델의 유효 깊이(effective depth)를 확장하는 기법입니다.
- NFE (Number of Function Evaluations): Diffusion 모델의 생성 과정에서 denoiser를 호출하는 총 횟수이며, 추론 비용을 결정하는 주요 지표입니다.
- Adaptive Looping: 고정된 반복 횟수 대신, denoiser의 은닉 상태(hidden state) 변화가 임계값 이하로 떨어질 때까지 반복하여 추론 효율을 높이는 기법입니다.
- DUO++: 고차원 vocabulary에서도 낮은 메모리 사용량과 빠른 수렴을 달성하기 위해 설계된 UDLM 학습 레시피입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 UDLM 학습 시 발생하는 높은 연산량(FLOPs) 부담과 효율적인 추론을 위한 최적의 깊이 할당 문제를 해결하고자 합니다. UDLMs은 MDLMs(Masked Diffusion Language Models)와 달리 손상된 토큰의 위치 정보가 제공되지 않아 denoiser가 더 복잡한 예측을 수행해야 하며, 이로 인해 더 많은 훈련 비용이 필요합니다. 기존 연구들은 MDLMs에서 반복적인 계층 구조(looping)를 통해 효율성을 개선했으나, UDLM 구조에서도 이러한 기법이 훈련 효율과 추론 성능을 향상할 수 있는지에 대해서는 미답 상태였습니다. 저자들은 파라미터 추가 없이 반복적인 계산을 통해 동일한 noisy sequence에서 더 높은 성능을 뽑아내는 방식을 제안합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 DUO++ 아키텍처의 초기 Transformer 블록들을 반복(loop)하도록 구성하고, 훈련 과정에서 다양한 loop-count 분포를 적용하여 모델의 범용성을 확보했습니다. 제안된 Looped UDLM은 OpenWebText와 FineWeb-Edu 데이터셋에서 기존 non-looped baseline 대비 2.7~3.3배 적은 training FLOPs로 동일한 validation NLL을 달성했습니다. 특히, inference 과정에서 loop 횟수를 유동적으로 조절하는 adaptive looping을 적용한 결과, 추론 정확도를 유지하면서도 기존 고정 loop 모델 대비 26~35% 더 적은 iteration으로 연산을 수행할 수 있음을 확인했습니다. [Figure 1]과 [Table 1]은 각각 학습 효율성 증대와 다양한 벤치마크에서의 zero-shot perplexity 성능 우위를 명확히 보여줍니다. 또한, [Figure 2]를 통해 제안된 파이프라인의 구조적 변경 사항을 구체화하였습니다.
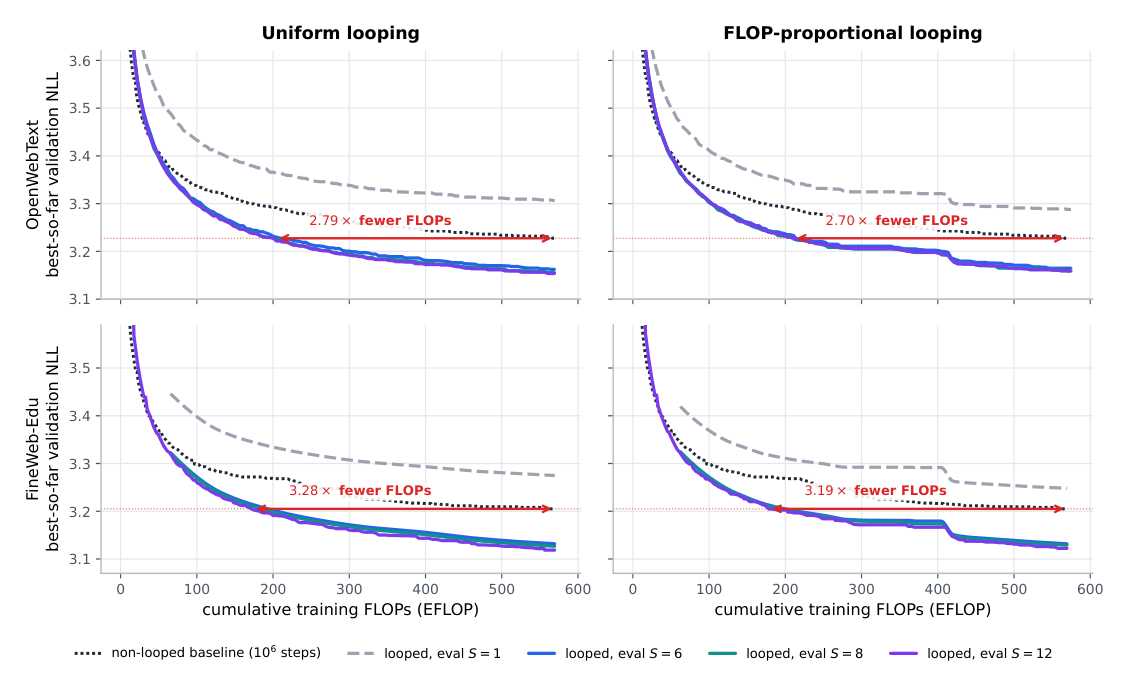
Figure 1 — Looped 모델이 baseline 대비 적은 FLOPs로 학습 가능함을 보여주는 핵심 결과
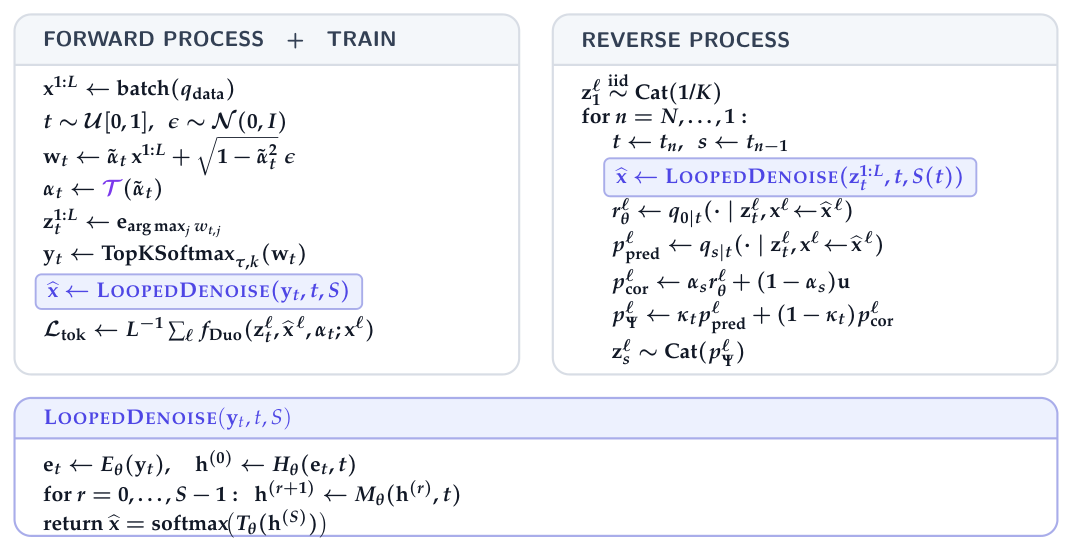
Figure 2 — 제안하는 Looped UDLM의 전체 파이프라인 및 순환 구조를 설명
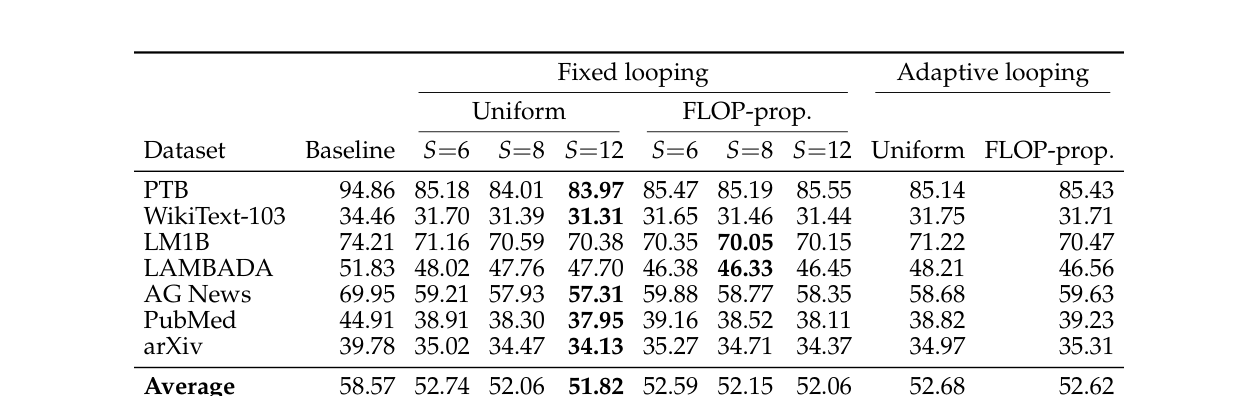
Table 1 — 다양한 데이터셋에서의 zero-shot 추론 성능 비교 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 UDLM denoiser 내의 반복적 연산이 파라미터 효율성을 극대화하며, 결과적으로 훈련 및 추론 단계 모두에서 상당한 비용 절감을 가져올 수 있음을 입증했습니다. Looped UDLM은 generative perplexity를 9.8% 이상 낮추고 zero-shot 성능을 개선함으로써 대규모 언어 모델의 reasoning 강화에 중요한 기여를 할 것으로 보입니다. 이러한 방법론은 대규모 모델 학습의 자원 제약을 해결하는 실무적인 가이드라인을 제시하며, 향후 다양한 discrete diffusion 연구 분야에서 표준적인 효율화 전략으로 활용될 가능성이 큽니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LEV: Thinking Fast and Deep with Looped Decision Models
- [논문리뷰] How to Loop MoE: Flatten the Experts, Untie the Attention
- [논문리뷰] ProAR: Learning Prospective Reasoning with Autoregressive Video Models
- [논문리뷰] Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
- [논문리뷰] Decoding Looped Transformers Better for (Almost) Free
Review 의 다른글
- 이전글 [논문리뷰] Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
- 현재글 : [논문리뷰] Looped Uniform Diffusion Language Models
- 다음글 [논문리뷰] Memory-Centric Continual Learning for AI Agents
댓글