[논문리뷰] Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
링크: 논문 PDF로 바로 열기
저자: Hongcan Guo, Yian Zhao, Feng Wang, Shen Nie, Guoqiang Wei, Yan Zeng, Hengshuang Zhao, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Cola2: 연속적인 의미적 압축(Continuous Semantic Compression)과 균형 잡힌 이산 생성(Balanced Discrete Generation)을 통합한 계층적 언어 모델링 프레임워크입니다.
- MDM (Masked Diffusion Model): 고정된 span 레이아웃 내에서 양방향 토큰 노이즈 제거(Bidirectional Token Denoising)를 수행하는 블록 단위 생성 디코더입니다.
- DiT (Diffusion Transformer): 잠재 공간(Latent Space)에서 Flow Matching을 통해 데이터 분포를 학습하며, 인코더와는 독립적으로 사전 분포를 모델링하는 생성기입니다.
- CFG (Classifier-Free Guidance): 잠재 조건과 토큰 컨텍스트를 활용하여 의미적 재구성(Reconstruction)과 자율적 생성(Autonomous Generation) 간의 균형을 동적으로 조절하는 기법입니다.
- Co-adaptation: 인코더와 디코더가 토큰 예측 기울기(Gradients)를 통해 잠재 표현과 이산 생성 성능을 상호 최적화하며 진화하는 학습 방식을 지칭합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존의 자동 회귀(AR) 패러다임이 가진 고정된 직렬 생성 방식의 한계를 극복하고, 연속적인 잠재 공간과 이산적인 토큰 공간 간의 효과적인 역할 분담 모델을 제시하고자 합니다. 기존의 계층적 생성 모델들은 잠재 공간의 정보 압축 효율이 낮거나, 인코더와 디코더가 독립적으로 설계되어 표현 학습과 생성 능력이 동기화되지 않는 문제점이 있었습니다. 또한, 잠재 Prior 학습이 인코더의 표현을 생성에 최적화된 방향이 아닌, fitting이 쉬운 방향으로 왜곡(Latent Hacking)시키는 문제가 존재합니다. [Figure 1]에서 제시된 바와 같이, 본 연구는 연속적인 의미 압축과 이산적인 생성 균형을 학습 과정에서 긴밀히 조정하는 통합 프레임워크의 필요성을 강조합니다.
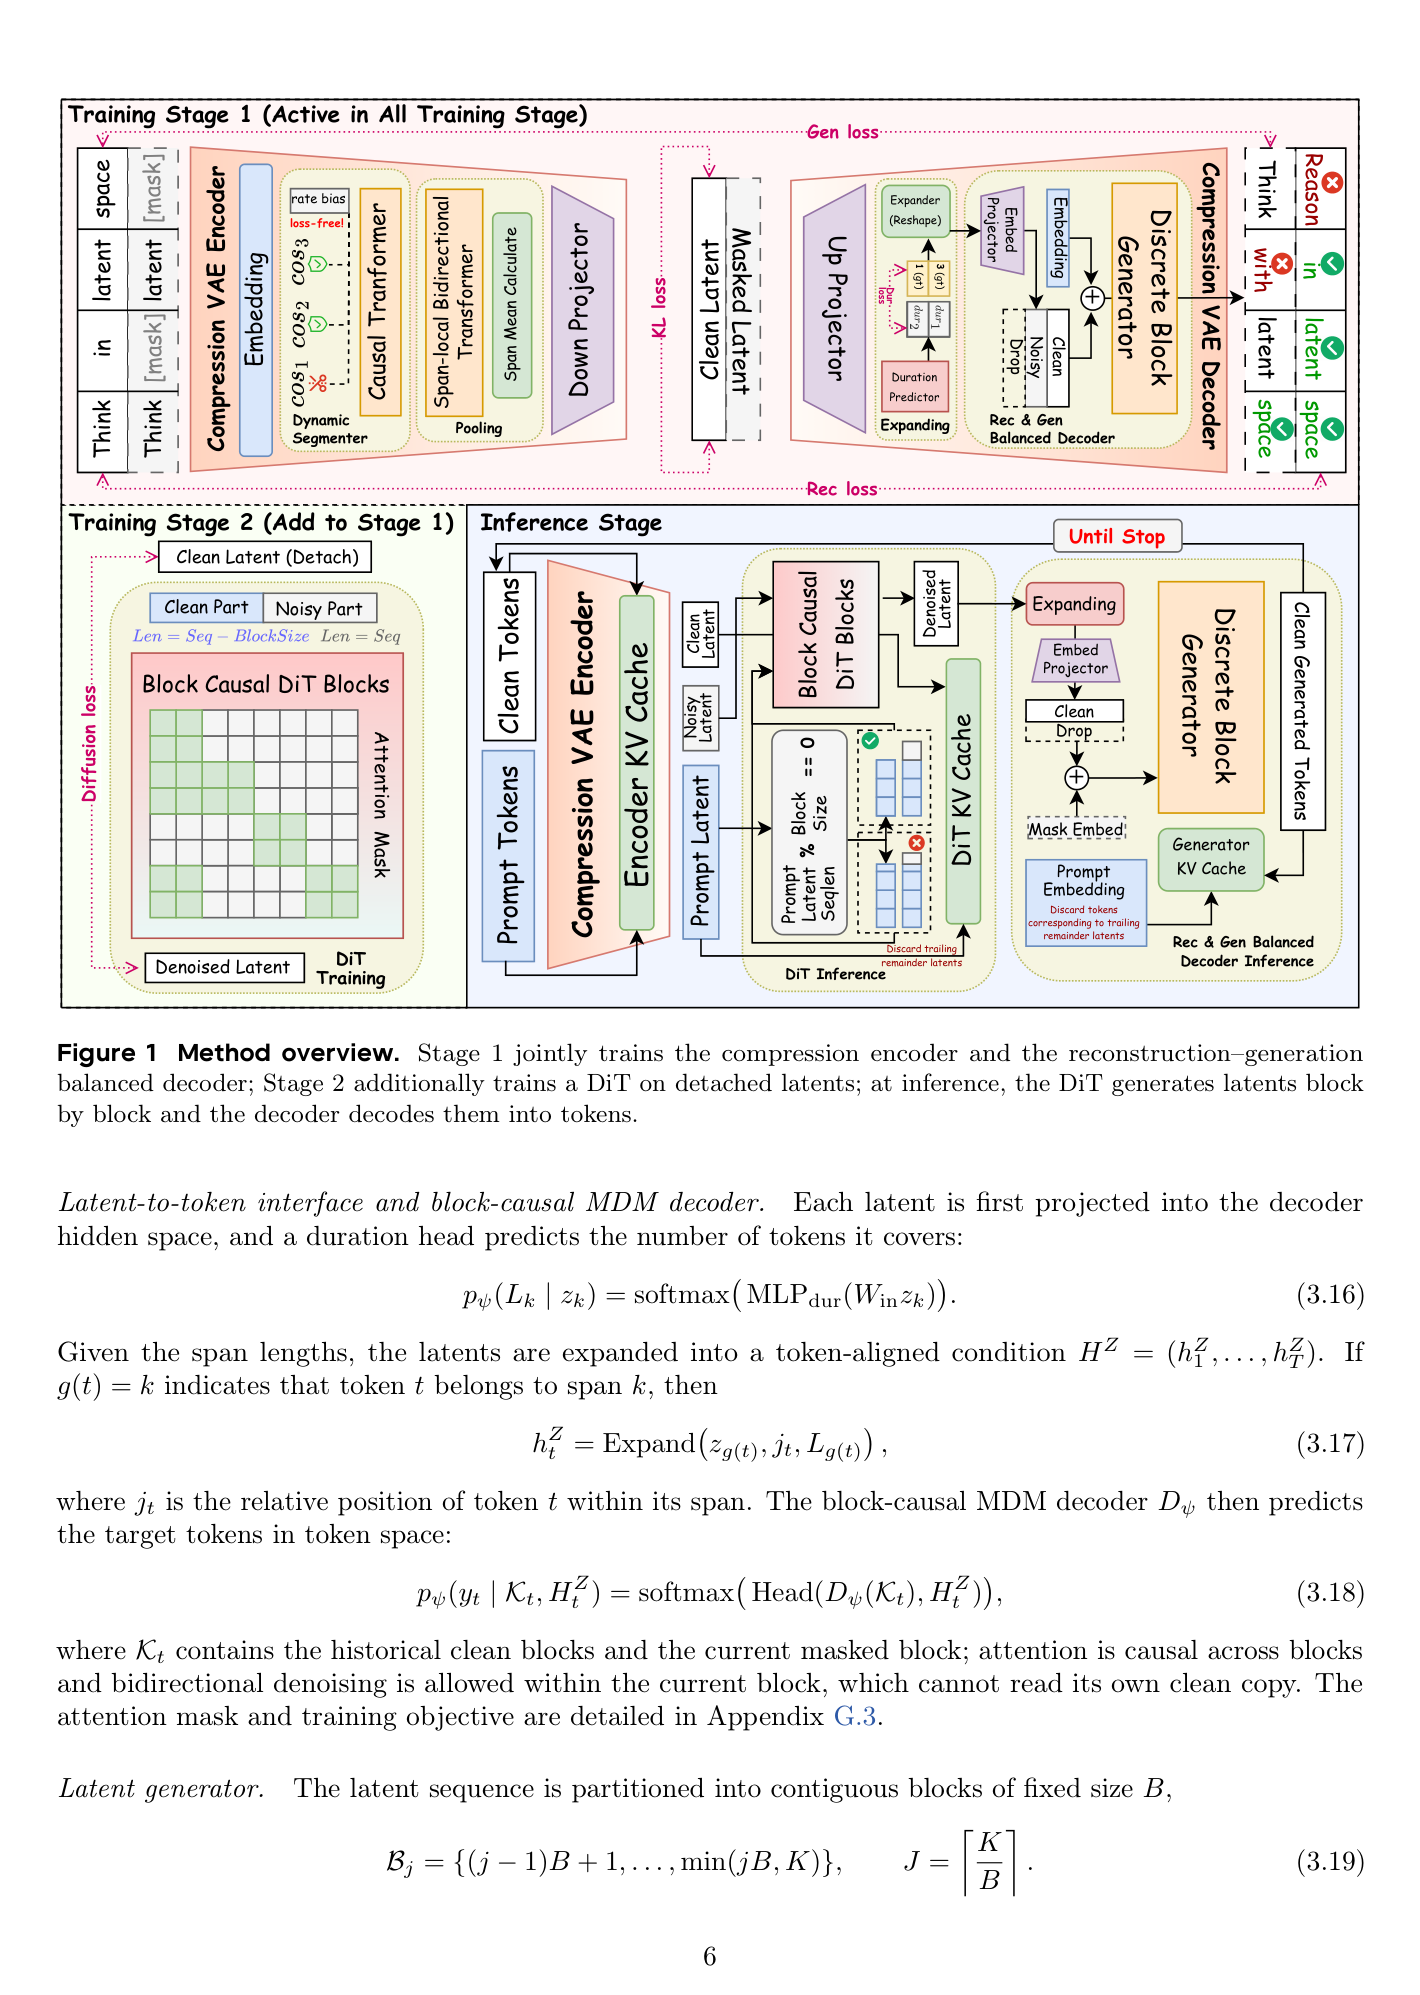
Figure 1 — Cola2의 전체 학습 및 추론 파이프라인과 모듈 간의 연결 구조를 보여주는 핵심 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 dynamic semantic segmentation을 통해 텍스트를 효율적으로 압축하고, auxiliary-loss-free 방식의 negative-feedback 컨트롤을 적용하여 압축률을 정밀하게 제어합니다. 인코더와 디코더는 토큰 예측 오차를 잠재 공간으로 역전파(Backpropagation)함으로써 co-adaptation을 수행하며, 이때 Prior 학습인 Flow Matching 기울기는 차단(Stop-gradient)하여 표현 학습과 분리하는 gradient decoupling 전략을 취합니다. 학습 시에는 cond/noise/drop 상태를 혼합하여 모델이 재구성 능력과 생성 능력을 균형 있게 학습하도록 유도합니다. 실험 결과, Cola2는 약 346B 토큰 규모의 학습만으로도 8개 task 평균 점수 60.10을 달성하였습니다. 특히 Llama-3-8B 대비 적은 학습 데이터로도 HellaSwag 및 StoryCloze에서 우수한 성능을 기록하며 계층적 생성 모델의 확장 가능성을 입증하였습니다. 이는 [Figure 2]와 [Table 4]에서 나타난 것처럼, 동적 세그멘테이션과 생성 지향적 감독 학습이 모델의 예측 성능을 크게 개선함을 보여줍니다.
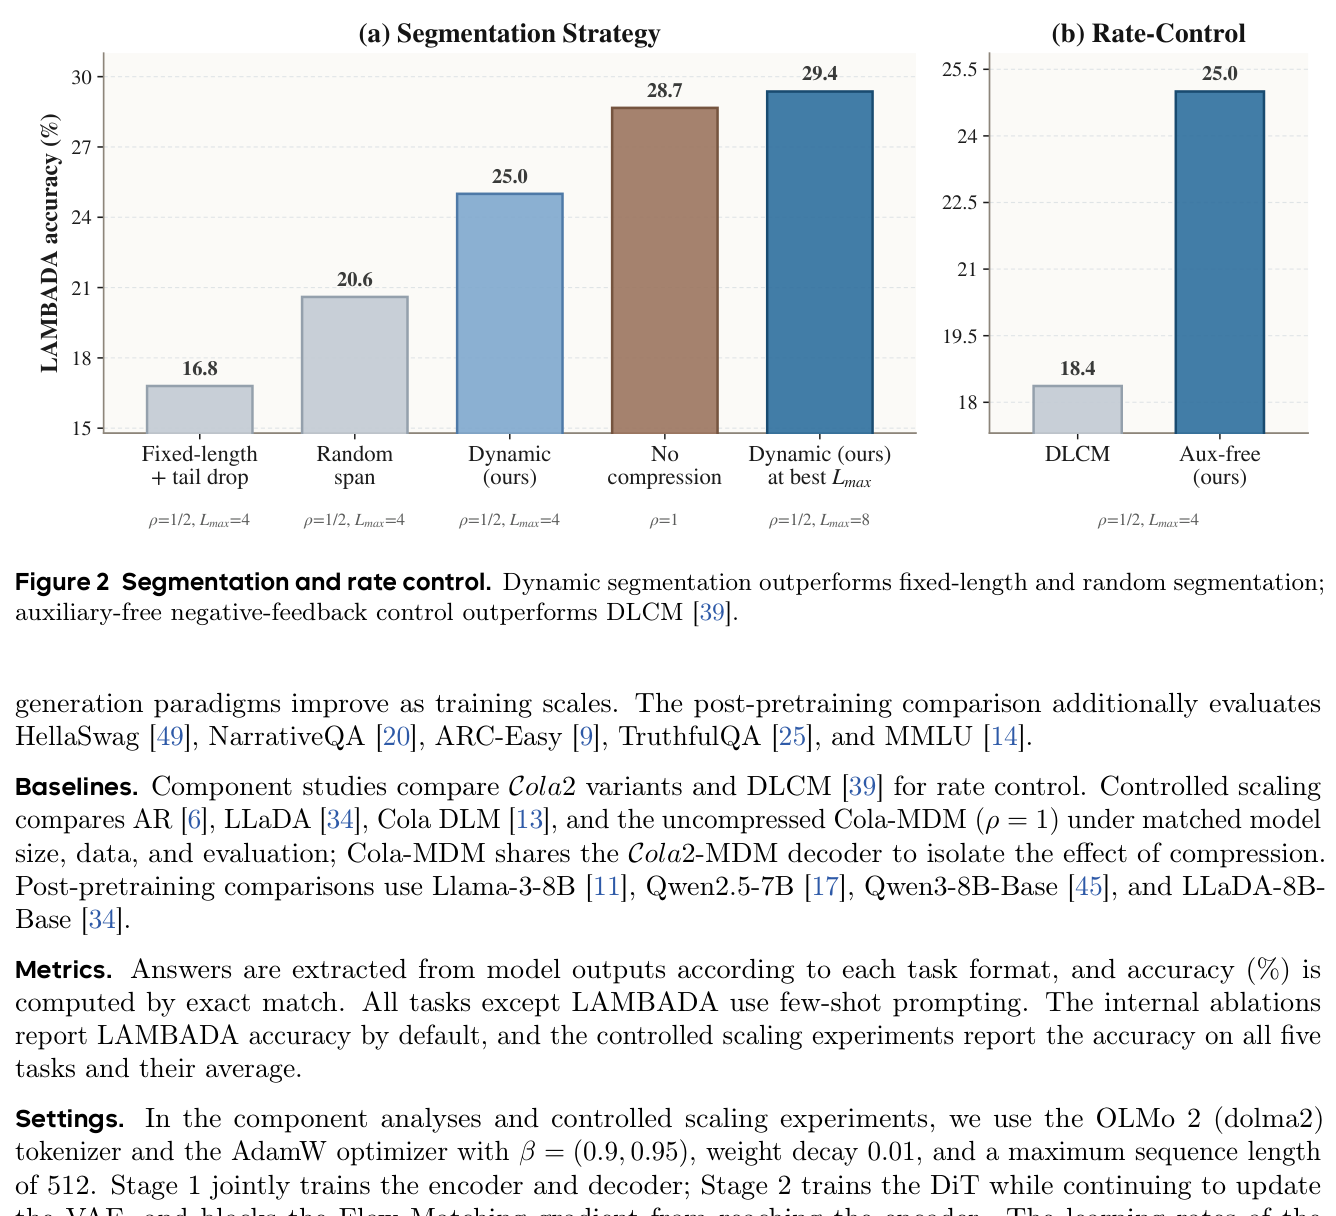
Figure 2 — 동적 세그멘테이션과 보조 손실 없는 레이트 컨트롤의 성능 효율성을 입증하는 주요 지표 그래프
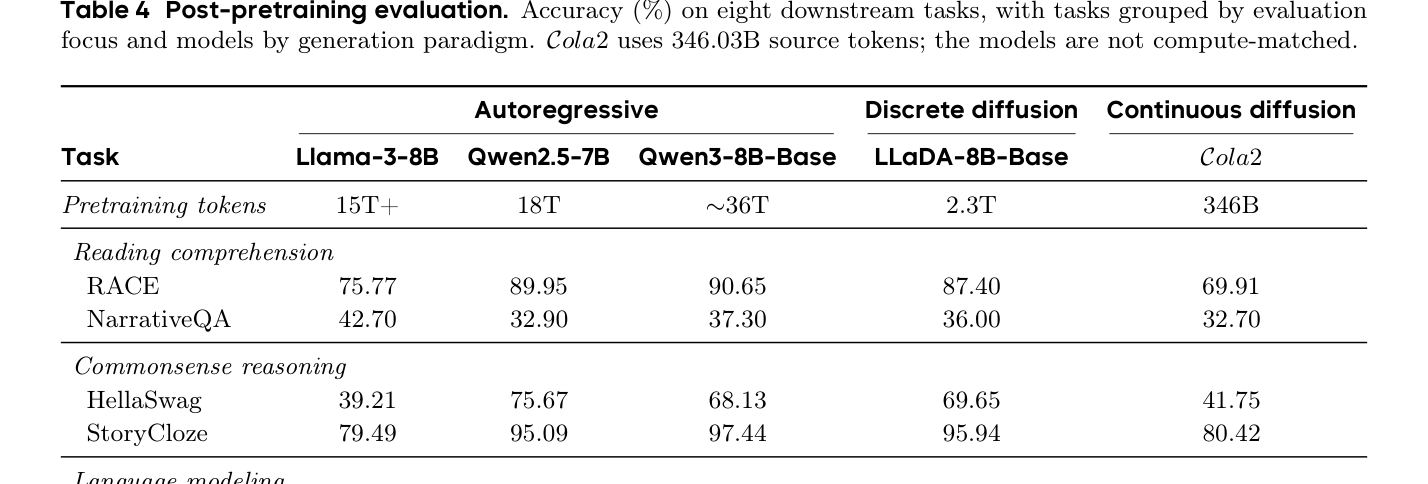
Table 4 — 주요 모델들과의 다운스트림 태스크 성능을 비교한 정량적 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 연속 잠재 공간 기반의 계층적 언어 모델링이 기존의 토큰 생성 패러다임과 효과적으로 결합할 수 있음을 입증하였습니다. 제안된 Cola2는 잠재 공간의 정보 밀도를 최대화하고 인코더-디코더의 공동 최적화를 통해 강력한 스케일링 잠재력을 보여주었습니다. 본 연구의 결과는 향후 초거대 모델의 학습 효율성을 개선하고, 더 복잡한 추론이나 제어 가능한 텍스트 생성 시스템을 설계하는 데 중요한 기반 지식을 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoAR-VAE: Improving Latent Diffusability through Robust Prediction
- [논문리뷰] Scaling and Distilling Text Embeddings for Better Diffusibility
- [논문리뷰] HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
- [논문리뷰] OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation
- [논문리뷰] DiffGI: Differentiable Geometry Images for High-Fidelity Thin-Shell 3D Generation
Review 의 다른글
- 이전글 [논문리뷰] Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
- 현재글 : [논문리뷰] Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
- 다음글 [논문리뷰] Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
댓글