[논문리뷰] RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
링크: 논문 PDF로 바로 열기
저자: Jaeyeon Heo, Geuntaek Lim, Yukyung Choi
1. Key Terms & Definitions (핵심 용어 및 정의)
- Relational Semantic Inertia: 비디오 프레임 간 엔티티가 유지되더라도 관계(predicate)가 변경되었을 때, 이전 프레임의 관계 예측을 그대로 유지하려는 모델의 실패 모드입니다.
- RTAformer (Relation-Transition-Aware Transformer): 관계 변화를 명시적으로 모델링하기 위해 제안된 one-stage 프레임워크로, entity persistence와 relation change를 분리하여 처리합니다.
- TADI (Transition-Aware Delta Injection): 인접 프레임 간의 relation-query 차이(displacement)를 보정하여 관계 업데이트를 위한 단서로 활용하는 기법입니다.
- SSIA (Spatio-Semantic Instance Alignment): 훈련 과정에서 인접 프레임의 instance-pair 쿼리 간 일관성을 유지하도록 contrastive regularization을 적용하여, TADI에서 사용하는 displacement의 representational drift를 감소시킵니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 VidSGG(Video Scene Graph Generation)에서 발생하는 Relational Semantic Inertia 문제를 해결하고자 합니다 [Figure 1]. 기존의 VidSGG 연구들은 프레임 간 정보를 결합하여 시간적 일관성을 높이는 데 주력했으나, 이로 인해 오히려 관계가 급격히 변화하는 상황에서도 이전 프레임의 관계를 답습하는 한계를 보입니다. 연구팀은 이러한 현상이 특히 동일한 엔티티가 지속적으로 존재하는(persistent) 상황에서 두드러진다는 점에 주목하였습니다. 따라서 엔티티의 정보는 유지하면서도 관계의 변화를 효과적으로 포착할 수 있는 새로운 시간적 모델링 방식이 필요합니다.
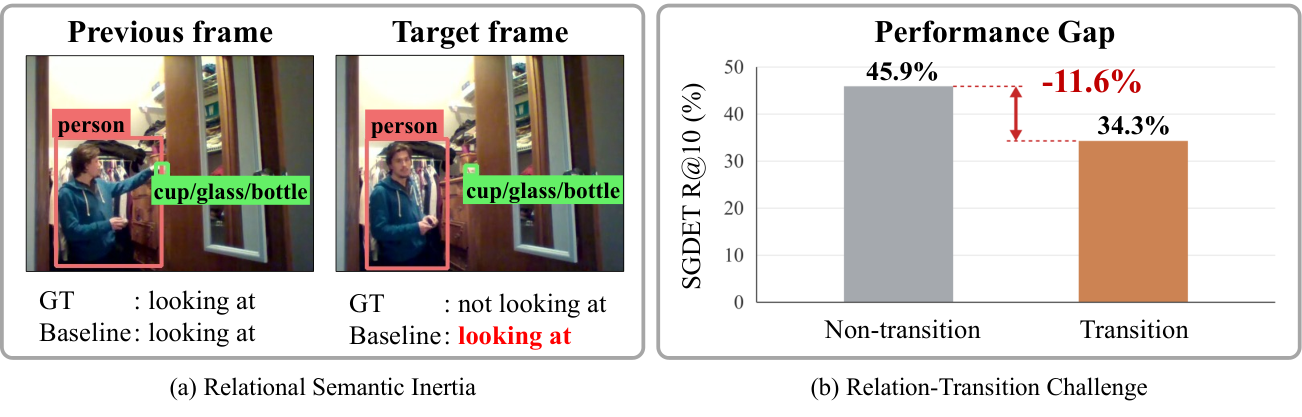
Figure 1 — 관계 변화 실패 모드
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 엔티티와 관계의 시간적 정보를 분리하여 처리하는 DTA(Disentangled Temporal Aggregation) 프레임워크를 제안합니다 [Figure 2]. 인스턴스 스트림은 엔티티의 연속성을 보존하고, 관계 스트림은 TADI 기법을 통해 인접 프레임 간 관계 쿼리의 차이를 주입하여 예측을 업데이트합니다 [Figure 3]. 또한 SSIA를 통해 학습 시 쿼리의 grounding 일관성을 강화함으로써 관계 변화 포착의 정확도를 높였습니다. Action Genome 데이터셋을 이용한 실험 결과, RTAformer는 기존 SOTA 모델인 UNO 대비 ViT-L/14 백본 환경에서 R@10 기준 최대 6.4%p(No Constraint) 높은 성능을 기록했습니다. 특히 Relational Semantic Inertia가 발생하는 전환 프레임(transition frame)에서 baseline 대비 훨씬 큰 성능 향상을 보여 관계 변화에 대한 대응력이 우수함을 입증했습니다 [Table 4].
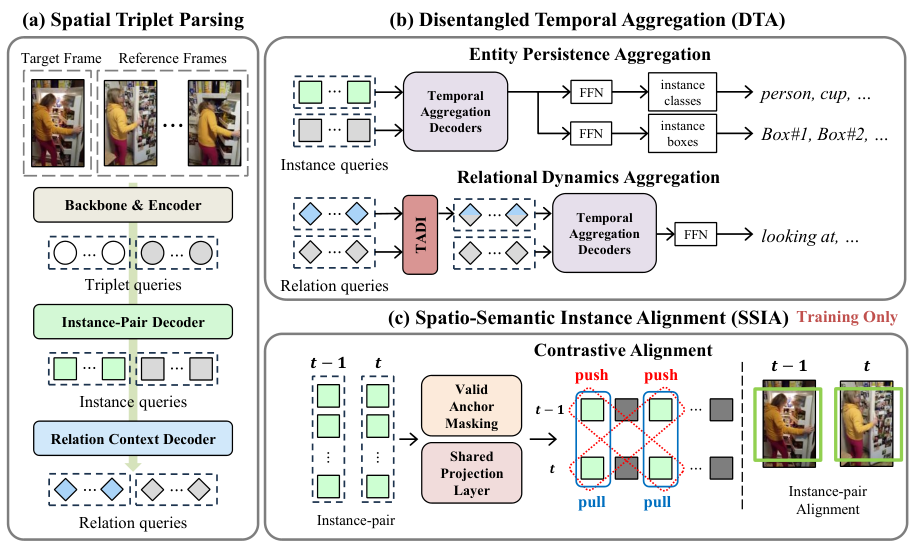
Figure 2 — RTAformer 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VidSGG에서 간과되었던 관계 전환 문제를 정의하고, 이를 해결하기 위한 RTAformer를 성공적으로 설계하였습니다. 제안된 방법론은 관계 쿼리의 시간적 차이를 직접적으로 이용함으로써 모델이 변화에 민감하게 반응하도록 유도합니다. 이 연구는 비디오 기반의 복잡한 상호작용 이해를 필요로 하는 Embodied AI 및 비디오 추론 분야에 중요한 학술적 기여를 하며, 향후 실시간 비디오 이해 시스템의 신뢰성을 높이는 데 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Speaker-Aware Temporal Aggregation Strategies on Segment Representations for Depression Detection in Dyadic Interaction: A Benchmark Study
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Who Takes the Lead? Model Ability and Task-Conditioned Collaboration with Humans
- [논문리뷰] What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
- [논문리뷰] What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
Review 의 다른글
- 이전글 [논문리뷰] RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
- 현재글 : [논문리뷰] RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
- 다음글 [논문리뷰] Reading, Writing, Sharing, and Interacting with the World through Video
댓글