[논문리뷰] DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents
링크: 논문 PDF로 바로 열기
저자: Sergio Burdisso, Esaú Villatoro-Tello, Dairazalia Sánchez-Cortés, Yanis Labrak, Jordi Luque, Milos Cernak, Petr Motlicek
1. Key Terms & Definitions (핵심 용어 및 정의)
- Procedural Hallucination: 개별 발화는 사실적이고 유창하지만, 전체 대화의 흐름이나 설계된 절차(workflow)를 따르지 않고 이탈하는 실패 모드.
- DialFork: 대화의 흐름을 통제된 방식으로 조작하여 procedural hallucination을 측정하기 위해 구축된 데이터셋 및 벤치마크 프레임워크.
- Forking: conformant(정상) 대화를 특정 지점(turn)에서 분기시켜, 그 이후에 특정 할루시네이션 유형을 주입함으로써 절차적 편차를 의도적으로 생성하는 기법.
- FlowKL / FlowScore: 대화의 내용(content)이 아닌 대화가 전개되는 방식(flow)을 비교하여 절차적 유사성을 측정하는 신규 지표.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM이 에이전트 역할을 수행할 때 발생하는 'Procedural Hallucination'이라는 새로운 실패 모드를 해결하기 위해 제안되었다. 기존 연구들은 주로 사실적 정확도(factuality)에 집중하여 컨텐츠의 진위 여부만을 검증해왔으나, 에이전트가 절차를 이탈하는 문제에 대해서는 간과하고 있다. 저자들은 기존의 사실성 중심 평가 체계가 대화의 절차적 적합성을 판별하지 못한다는 한계를 지적하며, 대화의 '내용'과 '진행 방식(process)'은 서로 직교하는 성질임을 강조한다. 따라서 대화의 절차적 논리(procedural logic)를 평가할 수 있는 명확한 기준과 데이터셋 구축이 필수적으로 요구된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 대화의 절차적 구조를 정형화하고, 이를 바탕으로 분기된 데이터를 생성하는 DialFork 벤치마크 프레임워크를 제안한다. 저자들은 Workflow Identity Corruption (WIC), Step Selection Policy Corruption (SSPC), Goal Replacement (GR), Conflicting System Constraints (CSC)의 4가지 할루시네이션 유형을 정의하고, 이를 통해 36,278개의 대화 샘플을 생성하였다. 데이터셋의 유효성은 30명의 인간 평가자를 통한 검증을 거쳤으며, 특히 분기 지점이 빠를수록 절차적 유사도가 낮아지는 ground-truth ordering을 확인하였다 [4.1]. 주요 결과로서, 제안된 FlowScore는 7개의 인코더 모델 전반에 걸쳐 기존 baseline을 크게 상회하며, 절차적 유사성 측정에서 내용 중심의 의미론적 유사성(semantic similarity)보다 우수한 성능을 보였다. 실험 결과, 세 가지 평가 태스크(set-to-set, dialog-to-dialog, hallucination turn prediction)에서 모두 유의미한 수치를 기록하며 대화의 절차적 흐름을 효과적으로 정량화함을 입증하였다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 procedural hallucination을 대화형 AI의 핵심적인 실패 모드로 정의하고, 이를 측정하기 위한 대규모 벤치마크인 DialFork를 구축하였다. 제안된 FlowKL 및 FlowScore 지표는 대화의 '내용'이 아닌 '전개 방식'을 평가함으로써 에이전트의 절차적 준수 여부를 더 정밀하게 측정할 수 있음을 보여준다. 본 연구는 향후 에이전트 시스템의 신뢰성을 확보하고, 실제 배포된 대화형 AI가 설계된 프로토콜 내에서 안전하게 작동하는지 모니터링하는 데 중요한 학술적·산업적 토대를 제공한다.
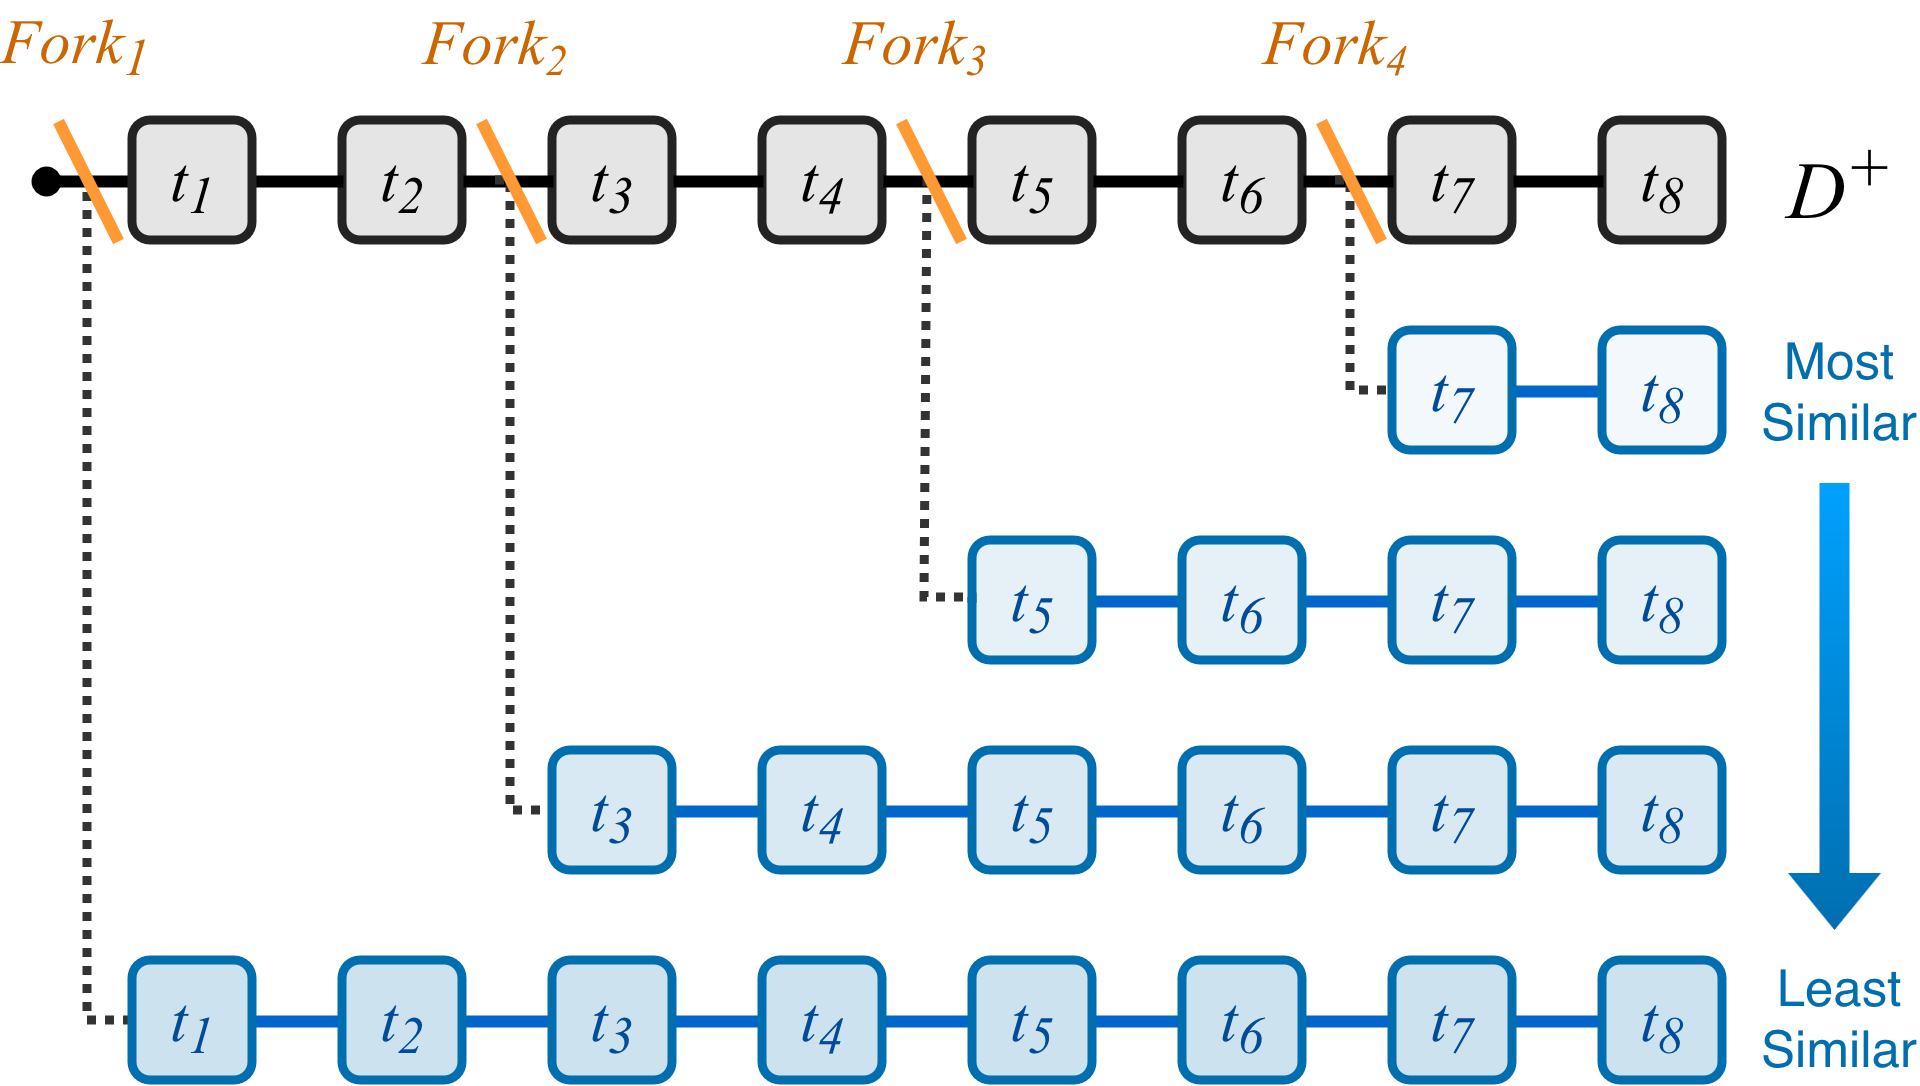
Figure 1 — DialFork의 제어된 분기 생성 과정
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboHarness: A Simple Harness Outperforms VLA and World Action Models
- [논문리뷰] Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
- [논문리뷰] DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
- [논문리뷰] SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
- [논문리뷰] PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
Review 의 다른글
- 이전글 [논문리뷰] Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
- 현재글 : [논문리뷰] DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents
- 다음글 [논문리뷰] DynaFlow: Learning Free-Form Multi-Agent Orchestration
댓글