[논문리뷰] PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
링크: 논문 PDF로 바로 열기
저자: Yue Gong, Le Zhang, Rui Chen, Song Chang, Xiaochao Qu, Luoqi Liu, Ting Liu, Yebin Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Geometry-Guided Adaptation (GGA): 타겟 씬의 기하학적 구조를 반영하여 삽입될 객체의 자세와 조명을 적응시키는 핵심 프레임워크입니다.
- InsertWorld: 조명, 시점, 씬 구성이 엄격하게 정렬된 counterfactual 이미지 쌍을 포함하는 객체 삽입 전용 대규모 데이터셋입니다.
- 2D Object–Scene Spatial Supervision (2D-OSS): 삽입되는 객체의 점유율(occupancy)과 그림자/반사 등 환경 변화를 지도 학습하기 위한 2D 공간 감독 기법입니다.
- PhysInsert-Bench: 일반적인 객체 복사가 아닌, 복잡한 조명 및 시점 변화 환경에서의 삽입 성능을 정량적으로 측정하기 위해 설계된 벤치마크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 객체 삽입(Object Insertion) 과정에서 발생하는 물리적 불일치 문제를 해결하기 위해 PhysInsert 프레임워크를 제안한다. 기존의 방식들은 단순히 객체를 복사하여 붙여넣는 수준에 머물러 있어, 타겟 씬에 따른 조명 변화, 시점(viewpoint) 최적화, 객체와 주변 환경 간의 상호작용(그림자, 반사 등)을 충분히 반영하지 못하는 한계가 있다 [Figure 1]. 특히, 기존 학습 데이터셋은 시점과 조명 변화에 따른 정밀한 감독 신호가 부족하여 실제 환경에서의 일관성 있는 객체 삽입이 어렵다 [Figure 1]. 이에 본 연구는 기하학적 사전 지식과 양방향 객체-씬 상호작용을 통합한 새로운 접근 방식을 도입한다.
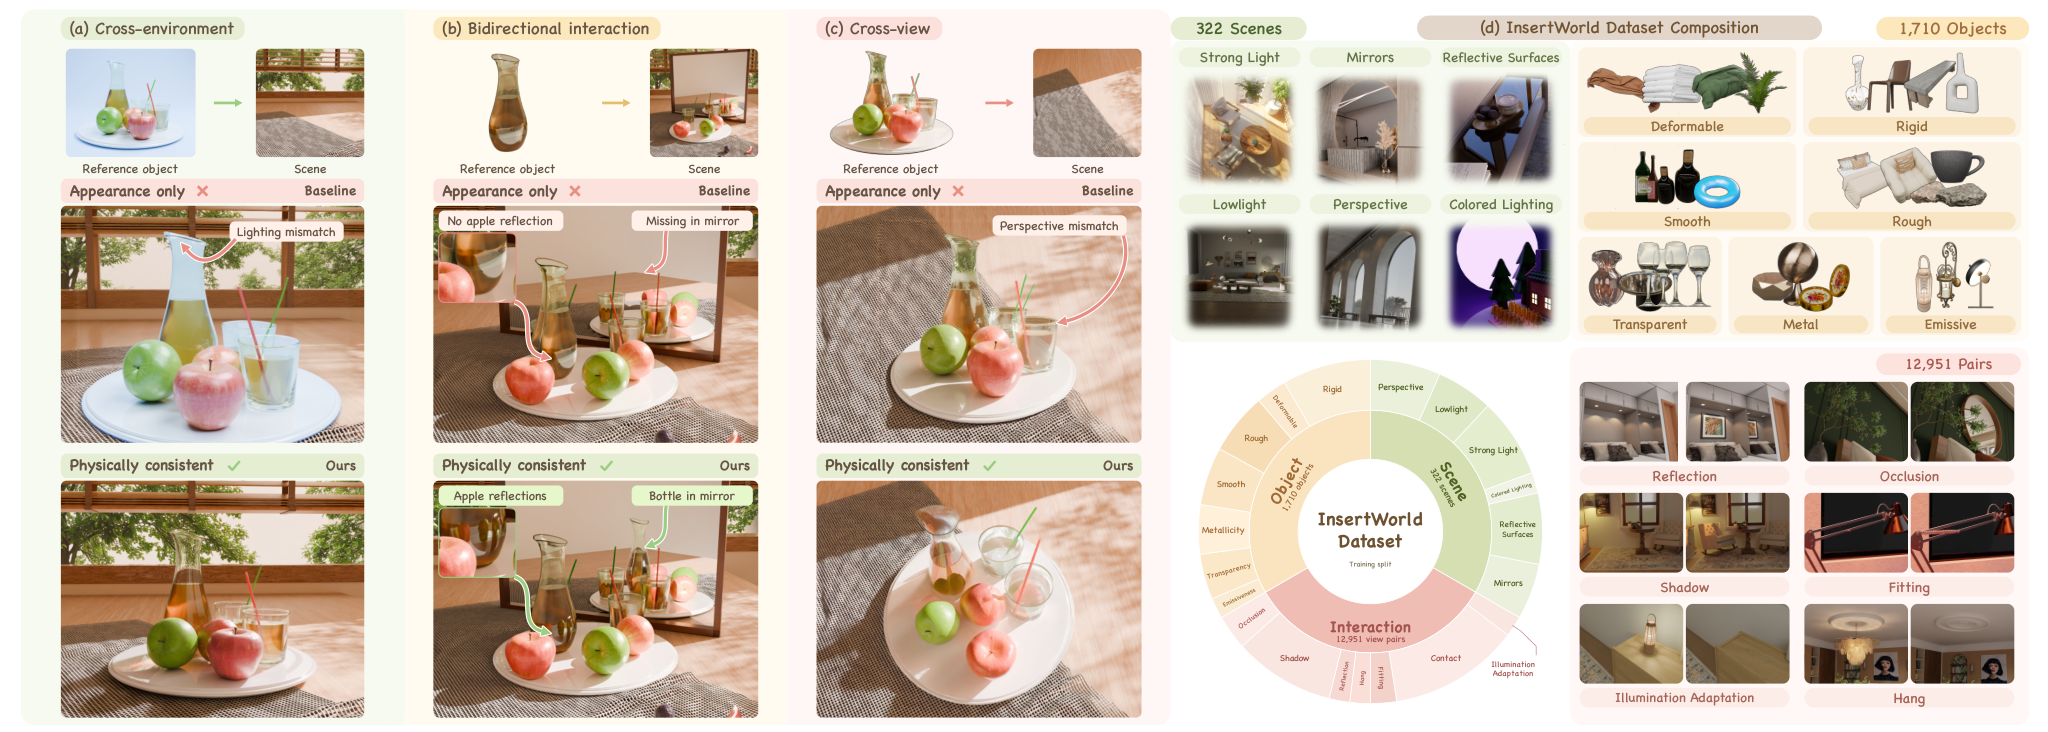
Figure 1 — 객체 삽입의 주요 과제
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 객체의 물리적 타당성을 확보하기 위해 Geometry-Guided Adaptation과 2D Object–Scene Spatial Supervision을 결합한 통합 프레임워크를 제안한다 [Figure 3]. Geometry-Guided Adaptation은 배경의 VGGT 기하학적 특징을 활용해 씬의 3D 구조를 생성하고, 이를 기반으로 객체의 자세를 적응시킨다. 동시에 2D-OSS는 객체의 마스크와 외부 환경 변화(그림자, 반사 등)를 직접 감독하여 시각적 정합성을 높인다 [Figure 3]. InsertWorld 데이터셋을 통해 학습된 본 모델은 PhysInsert-Bench에서 타 모델 대비 우수한 성능을 입증하였다 [Table 2, Table 3]. 정량적 지표인 DIoU와 Mask IoU에서 각각 62.99%, 56.08%를 기록하며 기존 SOTA 모델들을 압도적인 차이로 능가하였다 [Table 2]. 또한, FID 점수에서도 41.96을 달성하여 이미지 생성 품질과 씬 정합성 측면에서 최고 수준의 성능을 보였다 [Table 2].
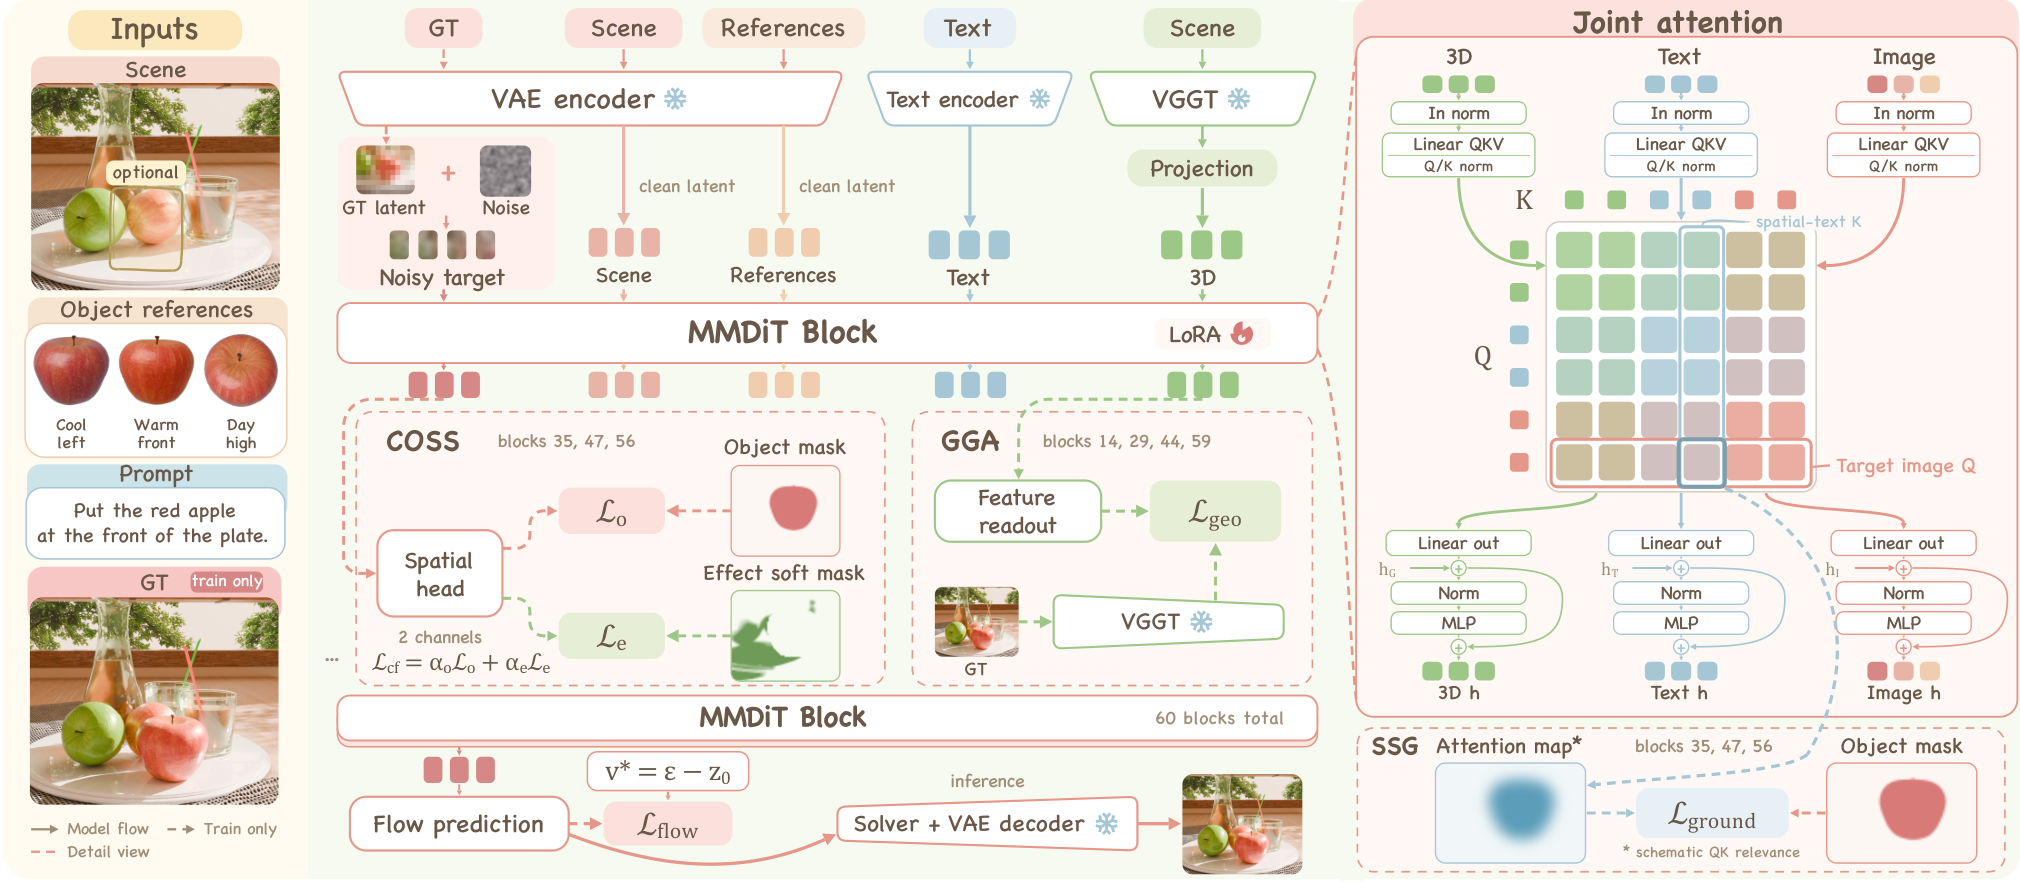
Figure 3 — PhysInsert 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 기하학적 Priors와 양방향 상호작용을 활용하여 물리적으로 타당한 객체 삽입을 가능케 하는 PhysInsert 프레임워크를 성공적으로 구축하였다. 대규모의 정렬된 InsertWorld 데이터셋과 새로운 벤치마크 PhysInsert-Bench는 향후 연구자들이 복잡한 조명 및 공간 제약이 있는 환경에서의 객체 삽입 문제를 해결하는 데 중요한 기준점이 될 것이다. 이 연구는 증강 현실(AR), 가상 씬 생성, 전문 콘텐츠 제작 등 시각적 일관성이 중요한 산업 분야에 즉각적인 기여를 할 것으로 기대된다.
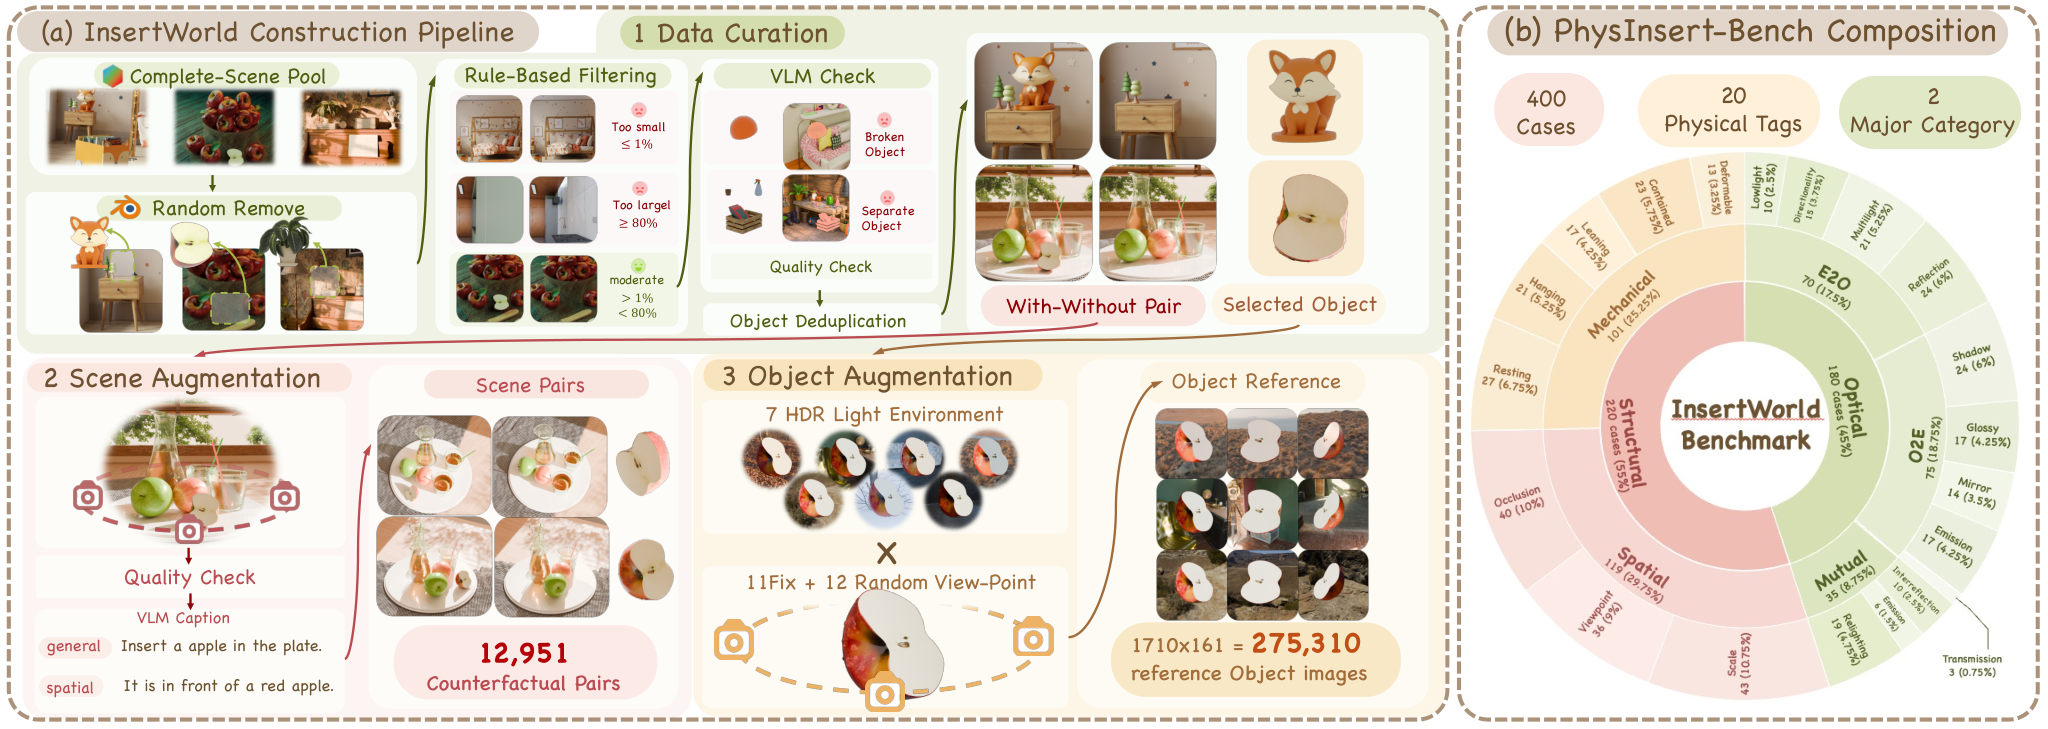
Figure 2 — 데이터셋 구축 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboHarness: A Simple Harness Outperforms VLA and World Action Models
- [논문리뷰] ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
- [논문리뷰] OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
- [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
- [논문리뷰] ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
Review 의 다른글
- 이전글 [논문리뷰] OpenFlyV2: An onboard vision-language-action model for aerial perception and navigation
- 현재글 : [논문리뷰] PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
- 다음글 [논문리뷰] Proving and Improving the Platonic Representation Hypothesis with JEPAs
댓글