[논문리뷰] Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
링크: 논문 PDF로 바로 열기
메타데이터
저자: GuangJian Team, Ant Group, Technical Committee on Digital Media Forensics and Security, CSIG et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Tide-Style Tuning:
LoRA와Full-parameter fine-tuning을 교차 적용하여 연산 효율성과 일반화 성능을 균형 있게 최적화하는 학습 전략입니다. - Modality Synergism: 비디오 포렌식에서 영상(Spatial)과 비디오(Temporal) 모달리티를 동시에 학습하고, 추론 시 Entropy를 기반으로 최적의 예측을 선택하는 프레임워크입니다.
- Anomaly Magnifier (AM):
MLLM의 부족한 픽셀 수준 감지 능력을 보완하기 위해 도입된 보조 인코더 모듈입니다. - RRVBench: 최신 AI 비디오 생성 모델들로 구성된 사실적 루머 비디오 벤치마크 데이터셋입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 복합적인 포렌식 위협을 포괄할 수 있는 단일 통합 Foundation Model의 부재 문제를 해결하고자 합니다. 기존 포렌식 연구는 디지털 조작, 물리적 스푸핑, 이미지, 비디오 등 각 분야가 파편화되어 있어 특정 도메인에만 최적화되어 있다는 한계가 있습니다 [Figure 1]. 또한, 대규모 데이터 학습 시 발생하는 과도한 연산 비용과 학습 난이도 불균형은 기존 모델이 새로운 위협에 효과적으로 대응하는 것을 방해합니다. 이러한 문제를 해결하기 위해 저자들은 {digital, physical} × {image, video}의 전 범위를 커버하는 다목적 모델인 Venus-DefakerOne2를 제안합니다 [Figure 3].
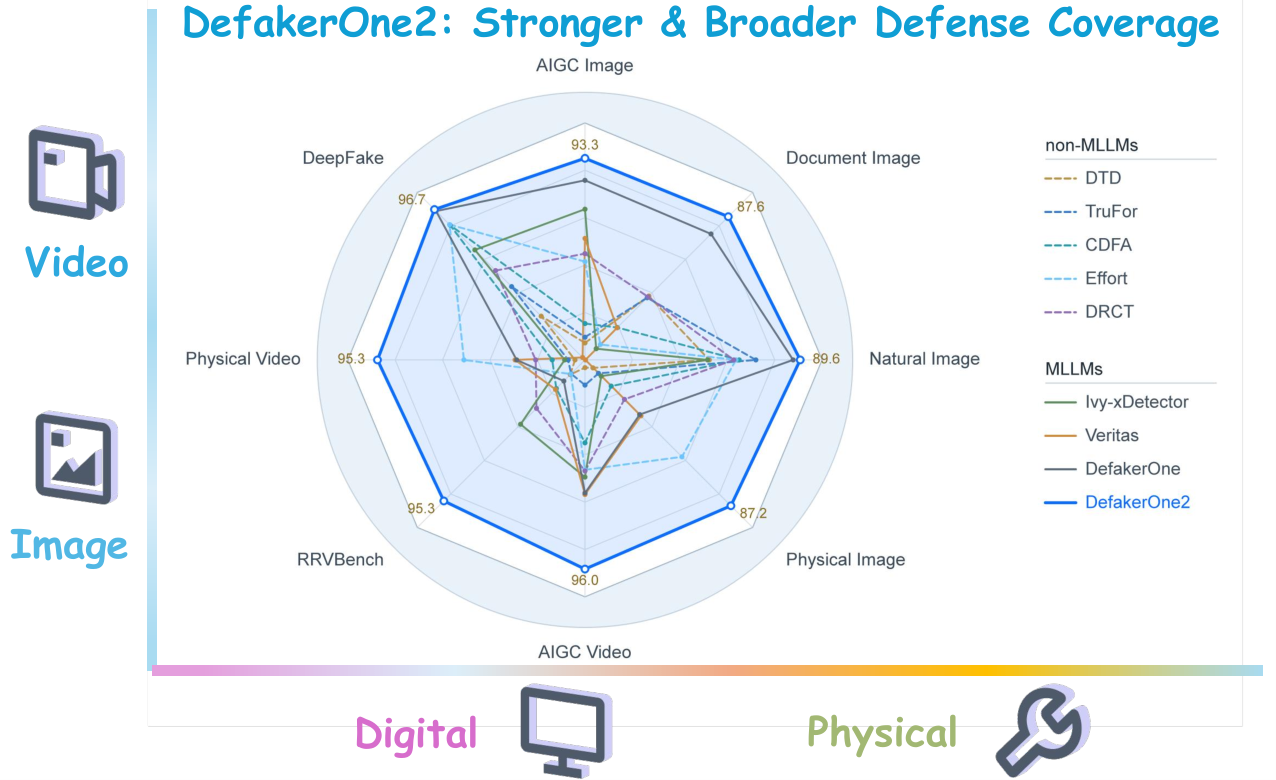
Figure 1 — 위협 커버리지 확장 개념도
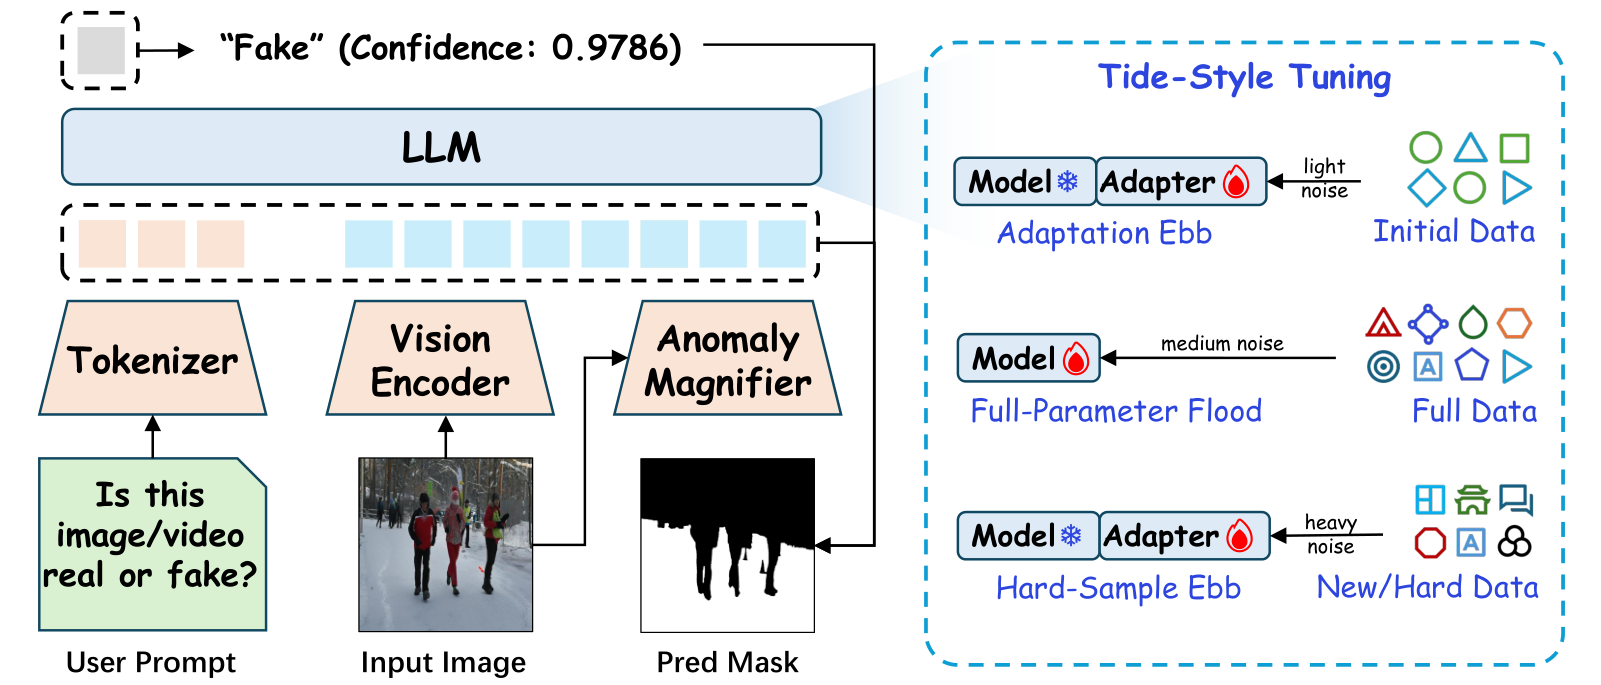
Figure 3 — DefakerOne2 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Tide-Style Tuning을 통해 Qwen3.5 기반의 MLLM을 학습시켜 연산 효율성과 성능을 극대화합니다 [Figure 3]. 이 방법론은 학습 과정을 Adaptation Ebb(warm-up), Full-Parameter Flood(주 학습), Hard-Sample Ebb(최적화) 단계로 구성하여 Catastrophic forgetting을 방지하고 hard sample에 대한 적응력을 높입니다. 또한, Modality Synergism을 통해 추론 시 Shannon entropy를 기반으로 가장 확실한 모달리티의 예측값을 선택하여 성능을 보장합니다 [Figure 4].
실험 결과, Venus-DefakerOne2는 53개의 포렌식 벤치마크에서 SOTA를 달성하며 압도적인 성능을 입증했습니다. 정량적 지표로 DeepFake 탐지율 96.7%, AI 생성 비디오 탐지율 96.0%를 기록하며 기존 모델 대비 비디오 포렌식 평균 점수를 57.6에서 95.7로 대폭 향상했습니다 [Figure 2]. 특히, 기존 7B-parameter 비디오 포렌식 모델들이 무작위 추측 수준(69.8%)에 머무는 RRVBench에서 95.3%라는 경이로운 성능을 기록했습니다.
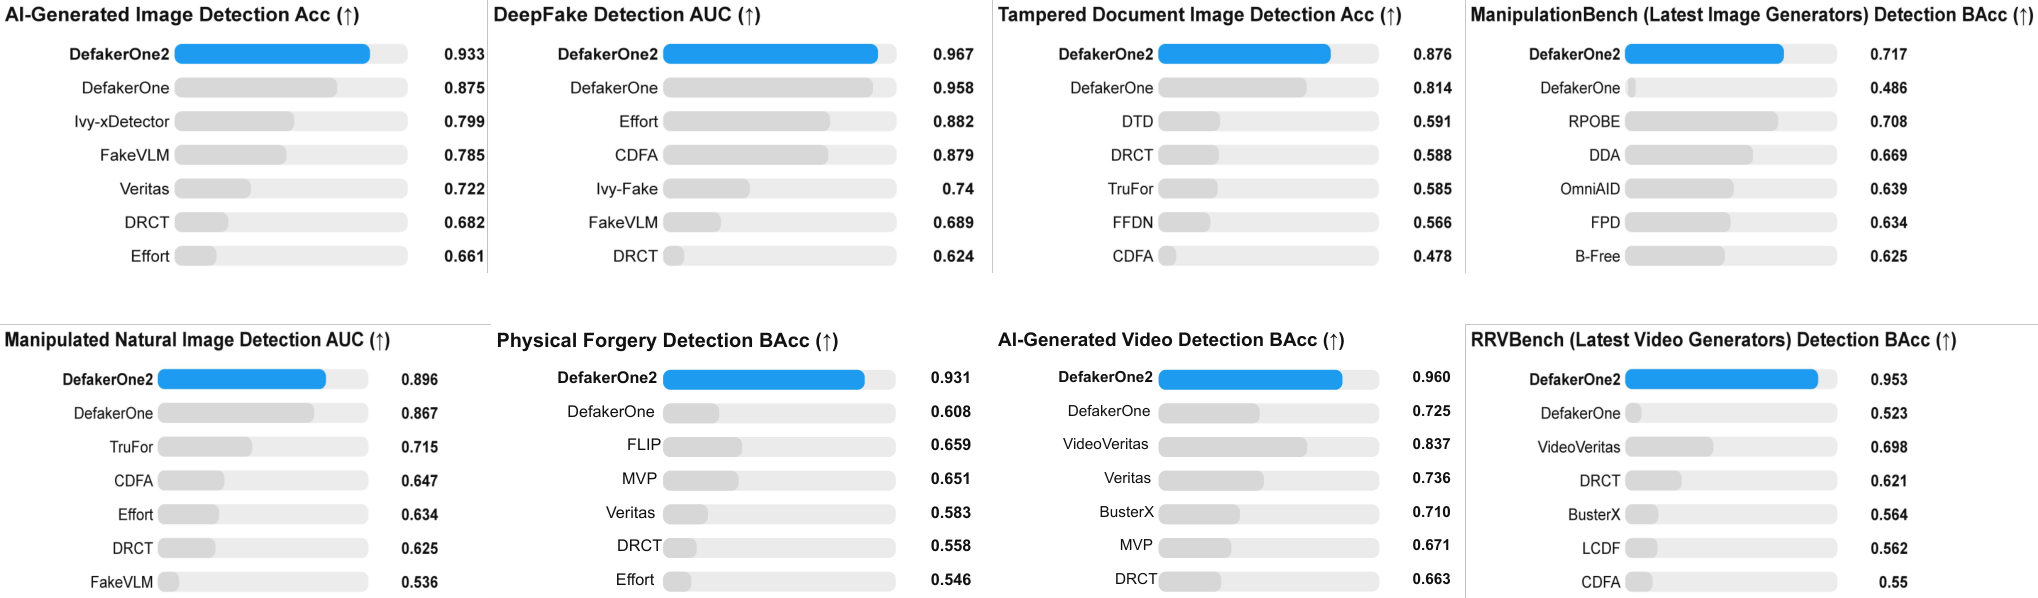
Figure 2 — 기존 모델 대비 성능 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 파편화된 비전 포렌식 분야를 통합하는 최초의 범용 Foundation Model인 Venus-DefakerOne2를 성공적으로 구축하였습니다. 제안된 Tide-Style Tuning과 Modality Synergism은 다양한 미디어 유형과 조작 형태를 통합 처리하는 효율적인 방법론을 제시합니다. 이 모델은 학계와 산업계 전반에 걸쳐 신뢰할 수 있는 디지털 환경을 구축하는 데 핵심적인 도구가 될 것이며, 지속적으로 진화하는 AIGC 위협에 대응할 수 있는 확장 가능한 모델링 프레임워크를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
- [논문리뷰] OmniSpectra: A Unified Foundation Model for Universal Spectra Representation Learning
- [논문리뷰] Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
- [논문리뷰] LensErase: A Foundation Model for Erase Anything
- [논문리뷰] GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Review 의 다른글
- 이전글 [논문리뷰] TurnTurk-GPT: Text-Based Turn-Taking Prediction for Turkish
- 현재글 : [논문리뷰] Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
- 다음글 [논문리뷰] VoxLock: Target-Speaker Extraction for Voice Agents Without an Enrollment Step
댓글