[논문리뷰] BEND 2.0: Benchmarking the Capabilities Needed to Design DNA
링크: 논문 PDF로 바로 열기
메타데이터
저자: Andreas Bjerregaard, Rachael DeVries, Dionysia Danai Brilli, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- BEND 2.0 (BENchmark for DNA language models): DNA 언어 모델의 기능과 DNA 설계 능력을 평가하기 위해 제안된 8개 태스크 및 5개 실험 데이터셋 기반의 종합 벤치마크 프레임워크입니다.
- Sequence Priors: 모델이 마스킹된 DNA 염기 서열을 주변 맥락을 통해 얼마나 정확하게 복원할 수 있는지를 측정하는 지표입니다.
- Linear Readouts: 사전 학습된 모델의 고정된(frozen) 임베딩 위에 학습시킨 선형 레이어(Linear head)를 지칭하며, 특정 downstream 태스크 수행 능력을 평가하는 핵심 도구입니다.
- Functional Post-training: 사전 학습된 모델에 기능적 주석 데이터(Functional genomic data)를 추가로 학습시켜 특정 biological outcome에 대한 예측 성능을 향상시키는 과정입니다.
- Genetic Interactions (Non-additivity): 두 개 이상의 돌연변이가 결합했을 때, 각 돌연변이의 개별 효과를 단순히 합친 것(additivity)과 실제 결과값 사이의 차이를 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 genomic foundation model 평가 방식이 실제 생물학적 DNA 설계(design)에 필요한 정밀한 기능 예측 능력을 충분히 측정하지 못한다는 문제의식에서 출발합니다. 현재 모델들은 단순한 서열 예측이나 전체적인 예측 정확도에는 강점을 보이지만, 특정 세포 유형이나 맥락에 따른 미세한 차이(context-specific effect), 돌연변이 간의 상호작용, 그리고 특정 목적을 위한 서열 최적화 능력에 대해서는 검증이 부족합니다. 이를 해결하기 위해 저자들은 단순한 예측 정확도를 넘어 실제 DNA 설계 과정에서 요구되는 실질적인 성능을 측정할 수 있는 통합 프레임워크를 제안합니다. [Table 1]
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Prior, Function, Context, Interaction, Design이라는 5가지 핵심 capability를 중심으로 모델을 평가합니다. 실험 결과, Linear Readouts를 활용한 frozen representation 방식이 모델의 native output과 대등하거나 더 뛰어난 성능을 보였으며, 이는 모델의 잠재적 정보가 적절한 인터페이스를 통해 효과적으로 추출될 수 있음을 시사합니다. 특히 Functional post-training을 거친 모델(예: NTv3 650M post)은 그렇지 않은 모델 대비 뚜렷한 성능 향상을 보였습니다. 예를 들어, AlphaGenome은 splicing 효과 예측에서 macro-gene Spearman 0.650을 기록하며 모델 중 최고 성능을 달성했습니다. [Figure 2] 정량적 지표 측면에서, 모델들은 평균적인 효과 예측에는 능숙하지만(Spearman correlation 0.5 이상), 상호작용 예측(Interaction)에서는 모델이combined effect를 잘 맞추더라도 정작 interaction 자체는 거의 예측하지 못하는(0.046 수준) 한계가 명확히 드러났습니다. [Figure 4]
4. Conclusion & Impact (결론 및 시사점)
본 연구는 genomic 모델이 범용적인 유용성을 갖추기 시작했으나, 문맥 의존적인(context-specific) 목적이나 다세포 목표 설계와 같은 과제에서는 여전히 성능 개선의 여지가 크다는 점을 입증했습니다. BEND 2.0 벤치마크는 향후 생명공학 분야에서 AI 모델을 활용한 DNA 설계 도구의 개발 방향성을 제시합니다. 본 연구는 학계 및 산업계 연구자들이 genomic 모델의 실질적인 설계 역량을 투명하게 평가하고, 데이터 효율성을 높이는 방향으로 모델을 고도화하도록 독려하는 데 중요한 기여를 할 것으로 기대됩니다.
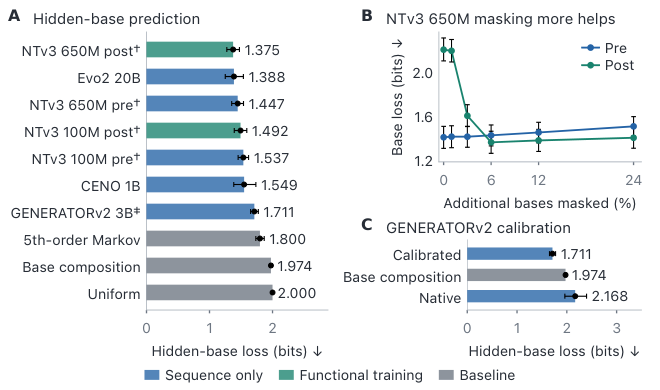
Figure 1 — 모델별 Sequence prior 성능 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] GENEB: Why Genomic Models Are Hard to Compare
- [논문리뷰] YANAMI: A Large-Scale Multimodal Dataset and Benchmark for Multiturn Stateful Interaction
- [논문리뷰] Switch-SWE: Do Coding Agents Hold Focus When Switching Between Unfinished Tasks?
- [논문리뷰] MoviEdit: Long-form Multi-Shot Video Editing Made Easy
- [논문리뷰] LOLPlay: Benchmarking Real-Time Visual Agents in League of Legends
Review 의 다른글
- 이전글 [논문리뷰] Axion 1.0: Open Agent Foundation Models, Simplified
- 현재글 : [논문리뷰] BEND 2.0: Benchmarking the Capabilities Needed to Design DNA
- 다음글 [논문리뷰] Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
댓글