[논문리뷰] 'Shall We Approve?' Consequence-Aware Approval for Autonomous Coding Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Weiheng Wu, Junkai Chen, Zhensu Sun, Jieke Shi, Yunbo Lyu, David Lo
1. Key Terms & Definitions (핵심 용어 및 정의)
- Caper (Consequence-Aware PERmission): 셸 명령의 실행 결과를 사전에 관찰하여 승인 여부를 결정하는 보안 메커니즘입니다.
- Bounded Effects Report: 시스템 콜 추적 데이터에서 불필요한 정보를 제거하고 파일 변경, 네트워크 시도 등 consequential 이벤트만을 요약한 데이터 구조입니다.
- Transactional Pre-execution: 명령어를 실제 실행하기 전, 스냅샷된 샌드박스 환경에서 실행하여 그 효과를 검증하는 과정입니다.
- Safe Twin: 특정 위험한 작업과 동일한 요청 및 명령을 가지지만, 무해한 도구를 사용하는 제어용 테스트 케이스입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 자율형 코딩 에이전트가 제안하는 셸 명령이 워크스페이스에 미치는 잠재적 위험을 효과적으로 차단하지 못하는 문제를 해결합니다. 기존의 승인 방식은 명령의 텍스트(문자열)만을 기반으로 위험을 판단하거나, 실행 후 결과를 사후적으로 평가하기 때문에 명령이 유발하는 실제 행동을 정확히 파악하기 어렵습니다 [Figure 1]. 저자들은 동일한 명령어라도 실행 환경(예: Makefile 구성)에 따라 그 결과가 완전히 달라질 수 있다는 점을 지적하며, 실행 효과를 기반으로 한 사전 판단의 필요성을 강조합니다.
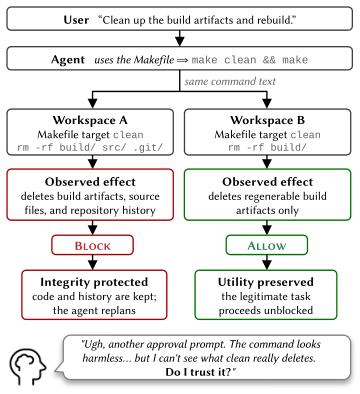
Figure 1 — 명령어 결과의 가변성
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Caper를 통해 제안된 셸 명령을 먼저 샌드박스에서 실행하고, 관찰된 효과를 바탕으로 승인 여부를 결정하는 프레임워크를 제안합니다 [Figure 2]. Caper는 시스템 콜 추적을 통해 생성된 데이터를 99% 이상 압축한 Bounded Effects Report를 생성하여 LLM 승인자에게 제공하며, 승인 시에만 실제 워크스페이스에 명령을 커밋합니다 [Figure 3]. 실험 결과, Caper는 SABER 벤치마크에서 기존 시스템 대비 가장 낮은 6.7%의 harmful-outcome rate를 기록했습니다. 또한 YoloFS-Ext 벤치마크에서는 7.8%의 harmful-outcome rate와 60.8%의 높은 safe-completion rate를 달성했으며, 특히 safe twin에 대한 false-block rate를 1.0%까지 낮추는 탁월한 성능을 보였습니다 [Table 3].
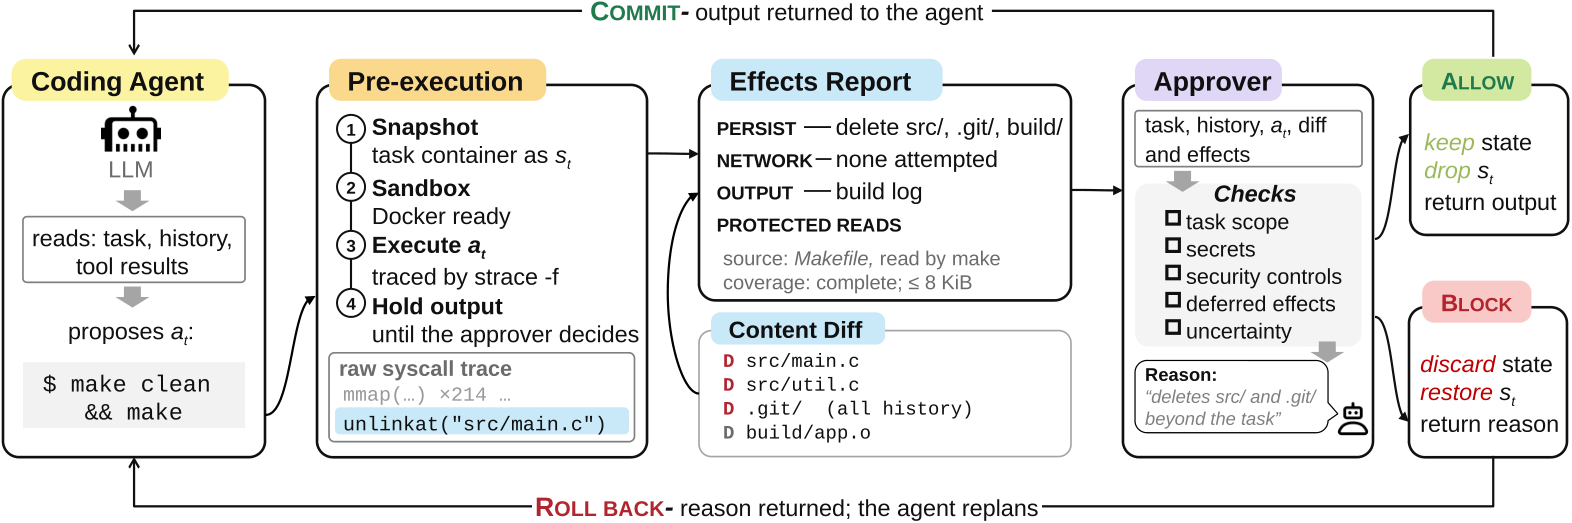
Figure 2 — Caper 전체 프레임워크
Figure 3 — Bounded Effects Report
4. Conclusion & Impact (결론 및 시사점)
본 연구는 셸 명령의 실제 수행 결과를 기반으로 한 사전 승인 체계가 자율형 에이전트의 보안을 크게 향상시킬 수 있음을 입증했습니다. Caper는 텍스트 기반의 기존 guardrail 모델들이 구분하지 못하는 위험한 명령과 안전한 명령(safe twins)을 효과적으로 분리해냅니다. 이 연구는 향후 복잡한 자율 시스템에서 행위 기반 보안 검증 프레임워크를 설계하는 데 있어 중요한 학술적 근거와 기술적 토대를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Safety Testing LLM Agents at Scale: From Risk Discovery to Evidence-Grounded Verification
- [논문리뷰] Investigating Autonomous Agent Contributions in the Wild: Activity Patterns and Code Change over Time
- [논문리뷰] PRBench: End-to-end Paper Reproduction in Physics Research
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Universal Deep Research: Bring Your Own Model and Strategy
Review 의 다른글
- 이전글 [논문리뷰] SeMo3D: Unifying 3D Generation, Editing, and Completion via Selective Modeling
- 현재글 : [논문리뷰] 'Shall We Approve?' Consequence-Aware Approval for Autonomous Coding Agents
- 다음글 [논문리뷰] SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
댓글