[논문리뷰] EarthRecord: From Pixels to Land Change with Multimodal Agents over Four Decades of Satellite Imagery
링크: 논문 PDF로 바로 열기
저자: Haoran Zhang, Huizhen Sun, Hanbin Wen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Raw Record: 각 site에 대해 데이터 제공 기관이 배포한 형태 그대로 주는 1984–2026년 multi-sensor archive입니다. Landsat (TM/ETM+/OLI), MODIS, VIIRS, Sentinel-2, ERA5-Land 등이 포함됩니다. Scale factor, offset, quality layer는 적용되지 않은 상태라서 agent가 cloud masking, scaling, cross-sensor harmonization을 직접 해야 합니다.
- pass3: 각 질문을 3회 실행해 conclusion field가 세 번 모두 맞을 때만 1점을 주는 주 평가 지표입니다.
- Closed Book: record 없이 질문과 site의 bounding box만 주는 control 조건입니다. Prior knowledge만으로 얼마나 답할 수 있는지 측정합니다.
- Instrument Pairs: 지상에서는 아무것도 변하지 않았는데 한 위성의 데이터만 인위적으로 바꾼 control입니다. 예를 들어 2018년 이후 값을 최대 20% scaling하거나 Landsat 8 scene을 Landsat 7로 교체합니다. 정답이었던 case는 결과에 따라 Moved(오답으로 바뀜), Held, Beyond로 분류합니다.
- Computable / Recognition / Insufficient-evidence: 질문의 세 가지 class입니다. Record의 변수로부터 공식으로 계산할 수 있는 질문(153), 지상에 무엇이 있는지·무슨 일이 일어났는지를 묻는 질문(73), 관측이 부족해 결론을 낼 수 없는 질문(12)으로 나뉩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 문제의식은 multimodal agent가 수십 년 분량의 raw 위성 archive를 신뢰할 수 있는 land-change analysis로 바꿀 수 있는지가 아직 측정된 적이 없다는 점입니다. 기존 vision-language benchmark와 remote sensing benchmark(MMStar, GeoMMBench 등)는 curated image를 기반으로 질문합니다. Earth observation agent benchmark(UnivEARTH, Earth-Bench, ThinkGeo 등)는 전처리된 입력이나 단기 task만 제공합니다. 그 결과 실제 분석이 시작되는 지점인 raw, multi-decadal, multi-sensor archive가 평가에서 빠져 있습니다.
또한 최종 답만 채점해서는 agent가 어떤 근거로 답을 냈는지 검증할 수 없습니다. 모델은 데이터를 쓰지 않고 regional prior knowledge만으로 답하는 경우가 많습니다. Pixel에서 계산했더라도 radiance는 지상 변화뿐 아니라 대기, viewing geometry, sensor 특성에도 좌우됩니다. 실제로 위성 기록의 역사에서는 orbital decay나 sensor degradation 때문에 "가짜 변화"가 여러 번 보고되었습니다. 따라서 답이 prior, pixel, 실제 ground change 중 무엇에 근거하는지 구분하는 control이 필요합니다 [Figure 1].
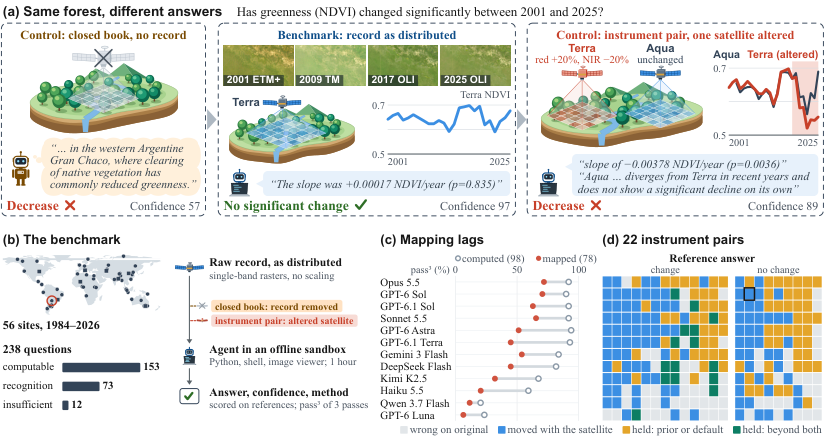
Figure 1 — EarthRecord 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 56개 site의 4가지 위성 raw record 위에 238개 land-change 질문을 얹은 benchmark인 EarthRecord를 제안합니다 [Figure 1].
구성과 평가 방식
- Site와 데이터: 48개 core area(8개 theme: forest, water, urban, fire, snow 등)와 8개 administrative region으로 구성됩니다. Core area당 Landsat scene은 중앙값 1,101개이며, 질문 중 109개는 Landsat sensor 2개 이상에 걸쳐 있습니다.
- Analysis task: Quantify, Trend, Date, Detect, Recovery 등 10개로 나뉩니다 [Figure 3].
- Reference answer: 출처가 세 종류입니다.
- 여러 method의 median 또는 75% 합의
- Record에서 withheld된 global product 4종: Hansen forest loss, JRC surface water, GHSL, MCD64A1
- AI가 초안을 쓰고 사람이 검토한 visual interpretation
- 실행 환경: offline, CPU 전용 sandbox(4 CPU, 24GB, Python/shell/image viewer)에서 run당 3,600초, 300 message로 제한됩니다. 채점은 pass3로 합니다.
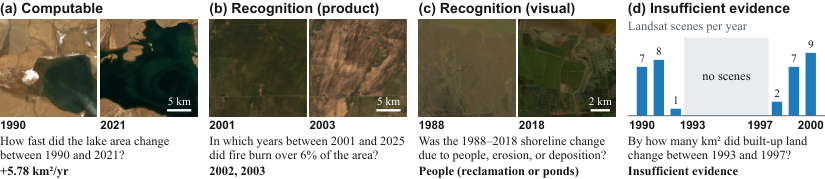
Figure 3 — 질문 class별 예시
주요 결과 (12개 모델 평가)
- 전반적 성능: Opus 5.5 (85.4%), GPT-6 Sol (84.1%), GPT-6.1 Sol (81.4%), Sonnet 5.5 (81.0%)가 computable·recognition 질문 226개 대부분을 end-to-end로 해결했습니다. 반면 GPT-6 Luna (18.6%)와 Qwen 3.7 Flash (19.5%)는 majority-class baseline(23.9%)보다 낮았습니다.
- Mapping이 핵심 bottleneck: 상위 6개 모델은 record 변수에서 계산하는 질문에서 92.0%를 맞혔지만, imagery에서 mapping이 필요한 질문에서는 61.1%에 그쳤습니다. 같은 모델·같은 task로 비교해도 mapping 질문의 정답 odds는 0.31배입니다.
- 일부 모델(GPT-6.1 Sol, GPT-6 Astra, GPT-6.1 Terra)은 mapping이 필요한 recognition 질문에서 run의 46–67%를 "insufficient evidence"로 포기했습니다. 이 run들은 대부분 이미지를 한 번도 보지 않았습니다.
- Confidence calibration은 모델마다 다름: 정답과 오답을 가르는 AUROC는 Sonnet 5.5가 0.84였고, Gemini 3 Flash, Qwen 3.7 Flash, GPT-6 Luna는 0.63–0.67이었습니다.
- Failure 양상: 상위 모델의 오류는 주로 analytic judgment 단계에서 생깁니다. 예를 들어 snow 질문에서 winter를 어떻게 정의하느냐에 따라 답이 갈렸습니다. 상위 6개 모델의 오답 run 347개 중 35%는 같은 모델이 다른 pass에서는 맞힌 질문이었습니다 [Figure 5].
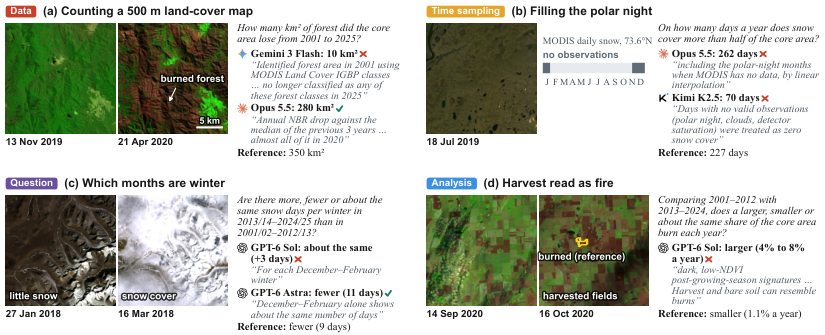
Figure 5 — 실패 분석 사례
두 control의 결과
- Closed Book: record를 주면 12개 모델 모두 computable 질문 점수가 +4.6~+60.8 points 올랐습니다. 반면 recognition 질문에서는 prior가 남아 있어 4개 모델이 오히려 점수가 떨어졌습니다.
- Instrument Pairs: 원래 맞혔던 case의 53.5%가 변조 후 오답으로 바뀌었고, 바뀐 답의 91%가 변조 방향을 그대로 따라갔습니다. 무작위로 scene을 제거한 placebo pair에서 답이 바뀐 비율은 12%에 불과했습니다. 변조를 실제로 넘어서서 정답을 유지한 Beyond case는 7.5%뿐이었고, 실패한 run 중 sensor를 원인으로 지목한 것은 3.5%에 그쳤습니다.
4. Conclusion & Impact (결론 및 시사점)
결론적으로 agent의 bottleneck은 archive 위에서 code를 실행하는 능력이 아닙니다. 막히는 지점은 두 가지 과학적 단계입니다.
- imagery에서 변화를 mapping하는 일
- pixel의 변화가 실제 ground 변화인지 검증하는 일
Record를 주면 답의 근거가 prior knowledge에서 pixel로 이동하지만, 아직 실제 ground change까지는 도달하지 못합니다. 저자들은 다음 단계로 mapping을 위한 pretrained vision model 제공과, 미세한 drift까지 잡는 routine cross-sensor check 도입을 제시합니다.
이 연구는 Earth observation 분야에서 agent를 "정답률"만으로 평가하던 방식에서 벗어나 답의 근거(provenance)를 검증하는 평가 framework를 제시했다는 의의가 있습니다. 과학 데이터 분석 전반의 agent benchmark 설계에도 적용할 수 있는 시사점입니다. Benchmark와 sandbox는 공개될 예정이며, 현재 GitHub과 Hugging Face dataset 링크가 함께 표기되어 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Zero-Shot Multi-Spectral Learning: Reimagining a Generalist Multimodal Gemini 2.5 Model for Remote Sensing Applications
- [논문리뷰] WGAST: Weakly-Supervised Generative Network for Daily 10 m Land Surface Temperature Estimation via Spatio-Temporal Fusion
- [논문리뷰] FINCOSMOS: An Open-World Evaluation Paradigm for Agents in Finance
Review 의 다른글
- 이전글 [논문리뷰] EVAThink: Evidence Sufficiency-Guided Training for Adaptive Thinking in Video Understanding
- 현재글 : [논문리뷰] EarthRecord: From Pixels to Land Change with Multimodal Agents over Four Decades of Satellite Imagery
- 다음글 [논문리뷰] Embodied First Exam
댓글