[논문리뷰] Evolving Infra: Agent-Adaptive LLM Serving at Scale
링크: 논문 PDF로 바로 열기
저자: Hao Kang, Weili Xu, Ziyang Li, Zheng Du, Hanchen Li, Tian Xia, Song Bian, Tushar Krishna, Huizi Mao, Ion Stoica, Song Han
1. Key Terms & Definitions (핵심 용어 및 정의)
- PD Split (xPyD): PD disaggregation 환경에서 노드를 prefill과 decode에 어떻게 나눴는지 나타낸다. 예를 들어 4P5D는 prefill 노드 4개와 decode 노드 5개를 뜻한다.
- Symmetric Engine: 하나의 scheduling loop로 prefill과 decode를 모두 처리하는 engine이다. SGLang을 확장해 만들었으며, 노드는 재시작 없이 in-place로 phase를 바꿀 수 있다. Mooncake RDMA transport 기반 protocol을 써서 어느 두 노드 사이에서든 양방향으로 KV를 전송할 수 있다.
- Branch / Agent Context Management: Branch는 agent harness가 fork하거나 sub-agent를 생성할 때 시작되는 독립된 context다. 각 branch는 자기만의 request sequence를 가진다. Compaction, fork, sub-agent 같은 context management에 따라 이후 request가 재사용할 prefix가 달라진다.
- Agent-aware Cluster-wide KV Directory: Router가 관리하는 prefix tree다. 각 노드의 GPU(L1)와 host memory(L2)에 어떤 KV가 있는지 기록하고, block마다 그것을 참조하는 active branch 수(count)를 함께 추적한다.
- Lost KV Reuse: 1 − h/h* 로 정의된다. 여기서 h는 실제 KV hit rate이고, h*는 모든 노드가 공유하는 무한 용량 KV cache에서 phase switch가 없을 때의 hit rate다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 PD disaggregated serving system은 compute allocation과 KV cache management가 노드의 phase에 묶여 있다. 그래서 agentic workload의 다양성과 동적 변화에 대응하지 못한다. Agent마다 prefill-heavy인지 decode-heavy인지가 다르고, 시간에 따라 workload composition도 바뀐다. 실제로 best static split은 일부 구간에서 10분 단위 최적 split보다 Throughput을 최대 24% 잃는다.
저자들은 기존 시스템의 문제를 세 가지로 정리한다.
- Costly phase switches: Dynamo는 phase를 바꿀 때마다 worker를 재시작하며, Claude Code trace 기준으로 switch 1회에 평균 681 s가 걸린다. Arrow는 in-place로 switch하지만, 34회 switch하는 동안 KV reuse의 55.5%를 잃는다.
- Misestimated compute demand: Planner가 queue depth, KV utilization, 전체 input 길이 같은 coarse signal로 split을 정한다. 그 결과 Dynamo와 Arrow의 Throughput은 best static split보다 각각 49%, 65% 낮다.
- Misjudged KV reuse: Cache-aware routing은 특정 노드에 부하를 몰아 P95 TTFT가 27–34 s에 이른다. HiCache의 LRU eviction은 compaction으로 이미 대체된 history는 남겨 두고, tool을 기다리는 branch의 KV는 지운다. 이런 eviction이 Dynamo가 잃는 KV reuse의 39%를 차지한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Evolving Infra는 compute allocation과 KV cache management를 분리(decouple)하고, 둘 다 agent에 맞춰 runtime에 적응시키는 serving framework다.
방법론 구성
- Infrastructure
- Symmetric engine: 노드가 재시작 없이 phase를 전환한다.
- Shared host-memory KV pool: 모든 노드의 L2를 하나의 pool로 묶는다. Request가 queue에서 기다리는 동안 RDMA로 KV fetch를 asynchronous하게 끝내 두어 prefill 지연을 숨긴다.
- Agent-aware KV directory: Harness가 넘겨주는 branch ID와 router가 관리하는 version을 이용해 fork, compaction, 종료, 노드 간 KV transfer가 일어날 때마다 block별 branch count를 갱신한다.
- Iteration-time model
- Roofline 가정을 바탕으로 prefill과 decode의 iteration time을 따로 모델링하며, 계수는 online으로 fitting한다.
- Prefill 모델은 uncached token(t_uc)과 cached token(t_c)을 분리하고, attention 비용은 query–key pair 수 A = t_uc·t_c + t_uc(t_uc+1)/2 로 계산한다.
- 학습에 쓰지 않은 setting에서 평균 오차는 단일 request 기준 4.2%, batch 기준 6.3%다 [Figure 5].
- Online phase-split adaptation
- Cluster Throughput을 Θ = min(Σμ_P, Σμ_D)로 예측한다.
- 10분 planning window를 m=10 개 slice로 나누고, 후보 split의 slice별 gain이 통계적으로 우위일 때만 switch한다. 이렇게 해서 sub-agent burst 같은 단기 변동에 반응하지 않는다.
- KV-reuse-aware eviction 및 routing
- Eviction은 (𝟙[R_b>0], T_b) 순서를 따른다. Count가 0인 block을 LRU 순서로 먼저 지우고, count가 양수인 block은 그다음에 지운다.
- Router는 노드별 predicted TTFT를 균형 있게 맞추도록 routing한다.
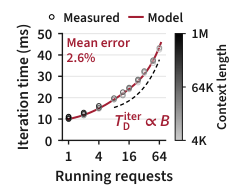
Figure 5 — Iteration-time 모델 검증
핵심 결과
실험 환경은 36 GB300 GPU(4×GB300 노드 9개, TP4)이며, GLM-5.2와 Kimi K2.6(NVFP4, FP8 KV cache, MTP)을 사용했다. Workload는 Putnam, Claude Code(CC), OSWorld다.
- Stationary workload, Dynamo 대비
- Throughput 1.10–2.73×
- Lost KV reuse 81–95% 감소
- Mean E2E latency 1.15–4.12× 감소(CC에서 3.80–4.12×, OSWorld에서 2.34–2.69×)
- P95 TTFT 최대 13.92× 감소
- Phase switch 시간: 평균 6.2 s로, Dynamo relaunch(평균 754 s)보다 100배 이상 짧다.
- Shifting workload composition(Putnam에서 OSWorld로 전환)
- Mean E2E latency: Dynamo 대비 2.15×, best static split 대비 1.33× 감소
- P95 TTFT: Dynamo 대비 3.58×, best static split 대비 1.88× 감소
- Throughput: Dynamo 대비 2.14×
- Ablation(CC, 126 agents)
- Initial split을 3P6D부터 6P3D까지 바꿔도 latency 차이는 최대 1.8%이며, 모든 경우 4P5D로 수렴한다.
- Online adaptation을 켜지 않고 infrastructure와 KV-aware eviction/routing만 써도 best static split 대비 Throughput이 **1.37×**다.
- Online adaptation을 켰을 때 Throughput 손실은 0.3%에 그친다.
- Iteration-time model은 1분 안에 수렴한다 [Figure 5].
4. Conclusion & Impact (결론 및 시사점)
Evolving Infra는 KV cache를 노드의 phase에서 떼어 내어, agentic workload에서 기존 PD disaggregated system보다 Latency와 Throughput을 크게 개선했다. Symmetric engine과 shared KV pool이 이 분리를 가능하게 한다. 그 위에서 online planner, TTFT-balancing router, branch-count 기반 eviction이 각각 compute allocation과 KV management를 agent의 동작에 맞춘다. 이 이득은 256 GB300 GPU 실험과 3,072 GPU simulation에서도 유지된다고 보고된다.
산업적으로는 offline profiling이 필요 없다는 점이 크다. 256 GPU에서 3시간 CC trace를 binary search로 profiling해도 10,752 GPU-hours가 드는데, 이 비용을 없앤다. 또한 harness가 branch 정보를 넘기는 식으로 agent harness와 serving infrastructure를 함께 설계하는 방향을 제시한다는 점에서도 의미가 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Ensemble Routing for Prompt-Adaptive Cost-Aware LLM Inference
- 현재글 : [논문리뷰] Evolving Infra: Agent-Adaptive LLM Serving at Scale
- 다음글 [논문리뷰] FAME-QP: A GPU-Accelerated Quadratic-Programming Solver for Real-Time Model Predictive Control
댓글