[논문리뷰] Calpha: Toward Native Biomolecular Intelligence in a General-Purpose Language Model
링크: 논문 PDF로 바로 열기
저자: Yong Liu, Zhanpeng Shi, Peicong Lin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Calpha: 하나의 general-purpose LLM이 protein folding, complex prediction, 구조 이해를 native ability로 갖추도록 하려는 프로젝트입니다. 본 보고서는 그 첫 단계로 Qwen3.5-9B가 single-chain 단백질 구조를 출력하는 시스템을 다룹니다.
<structure>token (Trigger): Qwen 어휘에 추가된 특수 토큰입니다. LLM이 이 토큰을 emit하면 structure head가 호출되고, 그렇지 않으면 text 생성을 계속합니다. 별도의 tool call 없이 동일한 forward pass 안에서 folding 여부가 결정됩니다.- Conditioning front-end: Qwen의 9개 layer(0, 4, …, 32)에서 residue hidden state를 읽어 (L, 9, 4096) tensor를 만들고, learned softmax mixture와 projection을 거쳐 frozen SimpleFold-3B head에 입력하는 8.4M parameter 모듈입니다.
- SimpleFold-3B head: flow matching으로 Gaussian noise를 all-atom coordinate로 transport하는 pretrained transformer(2.86B)입니다. 단백질에 대한 정보는 오직 LLM의 residue state를 통해서만 받습니다.
- Paired ΔTM: target별로 Calpha의 TM-score에서 reference system의 TM-score를 뺀 값입니다. 10,000회 paired bootstrap으로 95% CI를 산출합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 biomolecular foundation model의 구조 예측 능력이 general-purpose LLM의 일부가 아니라는 단절을 해소하기 위한 첫 단계로, LLM이 자신의 hidden state로부터 직접 단백질 구조를 출력하도록 만든다.
AlphaFold, ESMFold, SimpleFold 등은 고정된 입력을 고정된 출력으로 매핑할 뿐, natural language instruction을 받거나 답변을 설명하지 못한다. 반대로 frontier chat model들은 tool 없이 Cα 좌표를 출력하라는 요청에 mean TM-score 0.147–0.224에 그쳐, random walk(0.138–0.149)와 큰 차이가 없다. 두 영역을 잇는 기존 접근은 세 가지다. (1) LLM agent가 external folding tool을 호출하는 방식, (2) protein encoder를 붙여 text로만 답하는 방식, (3) discrete structure token 또는 continuous generator를 붙이는 방식이다. 그러나 어느 쪽에서도 LLM의 언어적 reasoning이 예측 구조를 개선한다는 것은 보여지지 않았다. 저자들의 장기 목표는 reasoning이 예측 좌표에 영향을 주는 모델이며, 이번 보고서의 질문은 "chat model을 경유할 때 folding accuracy가 얼마나 유지되는가"이다 [Figure 1].
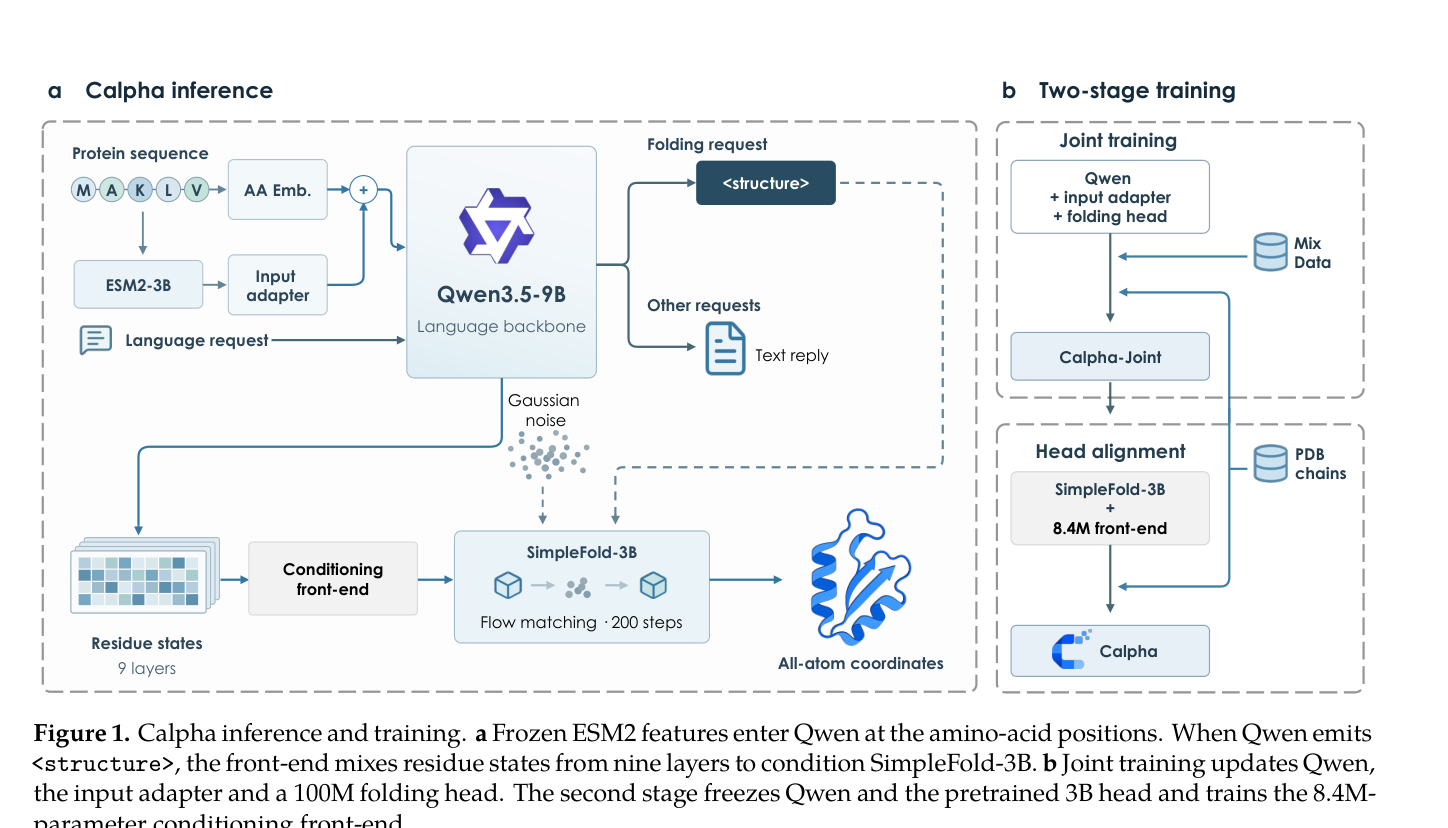
Figure 1 — 전체 아키텍처와 2-stage 학습 절차를 보여주는 핵심 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
Calpha는 ESM2 feature로 강화된 Qwen의 residue state를 frozen SimpleFold-3B head에 연결하는 2-stage 학습 구조를 사용한다 [Figure 1].
아키텍처와 학습 절차
- 입력 경로: frozen ESM2-3B의 per-residue feature가 adapter(layer mixture, MLP, zero-initialised gate)를 거쳐 amino-acid token embedding에 더해진다.
- Stage 1 (Calpha-Joint): Qwen3.5-9B 전체, adapter, SimpleFold-100M head를 2B token 동안 joint training한다. Loss는 language cross-entropy, trigger cross-entropy, flow-matching + smooth-lDDT loss(가중치 28.9)의 합이다. 데이터 구성은 다음과 같다.
- Language side: protein task 75%와 general text 25%.
- Structure side: 84,658 PDB chain을 crop 256으로 사용.
- Stage 2: Qwen과 SimpleFold-3B를 모두 freeze하고 8.4M front-end만 학습한다. Crop 256에서 20,000 step, 이어서 crop 512에서 10,000 step을 진행했으며, 8×H200에서 약 11시간이 걸렸다.
- 평가 방식: 200-step sampling, target당 single sample, Cα 기준 TM-score로 평가한다. 실패한 예측은 0점으로 처리한다.
주요 결과
- Folding accuracy: 고정된 folding request 하에서 mean TM-score는 FoldBench-334 0.808, CASP16 0.635, CAMEO-2025 0.900이다 [Table 4].
- Calpha-Joint(0.744 / 0.582 / 0.845)와 Calpha-Token(0.660 / 0.569 / 0.800)보다 모든 set에서 유의하게 높다.
- 그러나 public SimpleFold-3B(0.842 / 0.704 / 0.938)보다는 모든 set에서 낮다.
- ESMFold는 FoldBench와 CASP16에서 Calpha를 앞선다.
- ESM3-open과의 차이는 FoldBench와 CASP16에서 CI가 0을 포함하고, CAMEO-2025에서는 Calpha가 우세하다.
- ESM2 → SimpleFold-3B baseline 대비: baseline은 0.822 / 0.682 / 0.917을 기록했다. 다만 두 시스템은 trainable weight, schedule, crop이 서로 달라, 비교는 이 차이들의 combined effect를 측정한다.
- 100–299 residue 구간: 세 set 모두에서 paired CI가 0을 포함한다.
- 300–600 residue 구간: ΔTM이 −0.044 / −0.160 / −0.025로, 세 set 모두에서 CI가 0 미만이다. CASP16에서는 34개 중 1개 entry에서만 Calpha가 우세했다.
- Frontier chat model과의 비교: 180-target subset에서 Calpha는 0.821 / 0.667 / 0.909를 기록했고, GPT·Claude·Gemini·DeepSeek는 ≤0.224에 머물렀다.
- Trigger 정확도: 5개 folding request type 중 4개가 평가된 모든 예시에서 trigger를 유도했고, 나머지 하나는 95.5–98.2%였다. 구조를 요구하지 않는 질문에서의 false trigger는 0–1.4%였다.
- General ability 손실: 350-item MMLU-Pro subset에서 정확도가 77.4% → 70.3%로 7.1%p 하락했다. General data 비율을 15%로 줄이면 5%p가 추가로 떨어졌고, folding은 개선되지 않았다.
- Development ablation:
- Frozen head(0.801)가 unfrozen head(최고 0.792, 최종 0.771)보다 우수했다.
- Random init head는 0.270에 그쳤다.
- Crop을 256에서 512로 늘린 것만 유의한 개선(+0.006)을 보였다.
- Training step 2배, front-end capacity 2배, LLM unfreeze는 모두 효과가 <0.003이었다.
- Sample selection (16 samples): consensus pick이 CASP16에서 0.642, oracle은 0.679를 기록했다. Sample agreement와 true TM 간 Spearman은 0.853–0.893이었다.
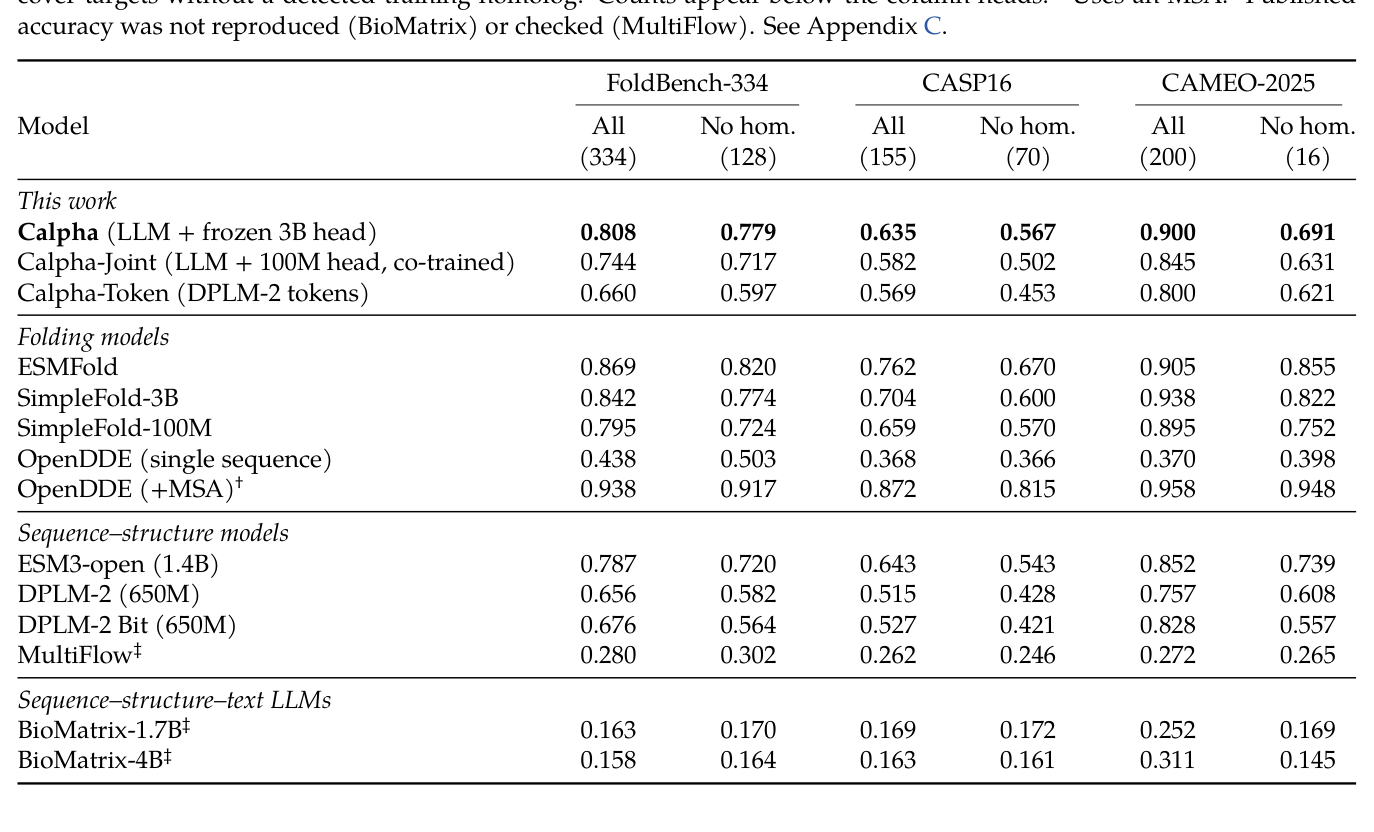
Table 4 — 세 벤치마크에서 Calpha와 specialist/LLM baseline을 비교한 핵심 결과 테이블
4. Conclusion & Impact (결론 및 시사점)
본 연구는 LLM이 tool call 없이 자신의 residue state만으로 single-chain 단백질 구조를 생성할 수 있음을 보였다. 다만 long-chain 구간에서는 direct baseline보다 낮고, 일반 능력도 일부 손실되었다. Qwen은 여러 English 표현에 걸쳐 folding 시점을 스스로 판단하며, 고정된 request 하에서 specialist model에 근접한 TM-score를 달성한다. 그러나 LLM을 경유하는 것이 folding을 더 정확하게 만든 비교는 없었다. 또한 instruction이나 reasoning이 예측 좌표를 바꾸는지라는 핵심 질문, 그리고 complex prediction, structure-as-input, side-chain 평가는 아직 다루지 않았다. 이 연구는 multimodal LLM에 continuous generative head를 붙여 과학적 구조 생성을 "native" 능력으로 통합하는 실증적 출발점이다. 동시에 frozen pretrained head 활용의 중요성, matched training recipe의 필요성, general ability trade-off를 명확히 정량화해 후속 연구의 기준선을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] BitDecoding-FP4: Native FP4 KV Cache Decoding via Algorithm-System Co-Design
- 현재글 : [논문리뷰] Calpha: Toward Native Biomolecular Intelligence in a General-Purpose Language Model
- 다음글 [논문리뷰] Centered Ablation: Why Last-Layer Directional Ablation Under-Fires or Collapses, and a Closed-Form Fix
댓글