[논문리뷰] InclusionMed: Benchmarking AI for Inclusive Healthcare
링크: 논문 PDF로 바로 열기
저자: The InclusionMed Collaboration (개별 저자명은 논문 본문에서 명시되지 않음)
1. Key Terms & Definitions (핵심 용어 및 정의)
- InclusionMed Atlas: Benchmark를 분류하는 9칸짜리 matrix입니다. 한 축은 Healthcare role(Patients and the public / Healthcare professionals / Healthcare administration professionals), 다른 축은 AI capability(Knowledge / Reasoning / Agency)입니다. 각 benchmark는 그 안의 task들에서 가장 많이 나타나는 role–capability 조합에 해당하는 cell 하나에 배치됩니다.
- InclusionMed Index: Atlas에 포함된 5개 benchmark 점수(0–100 scale)를 각각 20%씩 같은 비중으로 평균한 종합 지표입니다. 종합 점수와 함께 role별, capability별 점수도 보고합니다.
- Six Audit Criteria: Benchmark 포함 여부를 정하는 6가지 기준입니다. Healthcare relevance, Trustworthiness, Availability and permitted use, Complementary coverage, Timeliness and data independence, Discriminative capacity로 구성됩니다.
- InclusionMed-DxFiles: 저자들이 직접 만든 비공개 diagnostic reasoning benchmark입니다. NEJM의 Case Records of the Massachusetts General Hospital에서 가져온 312개 case로 구성됩니다. 점수는 primary diagnosis가 정확하고 근거 없는 diagnostic claim이 없는 perfect 판정 비율입니다.
- Pass@1 / Pareto Frontier: Pass@1은 한 번 시도했을 때의 평균 성공률입니다. Pareto frontier는 같거나 더 낮은 cost로 더 높은 score를 내는 대안이 없는 모델들의 집합입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 핵심 문제는, 기존 medical AI benchmark와 aggregate index가 어떤 healthcare 수요를 대표하는지 불분명하고 coverage도 고르지 않다는 점입니다. 그래서 inclusive healthcare 관점에서 모델 발전을 측정하기에는 부족하다는 것이 저자들의 주장입니다. 기존 평가 수단은 다음과 같습니다.
- MedQA·MedMCQA: 시험형 문항
- HealthBench: 개방형 대화
- MedAgentBench·CHI-Bench: workflow simulation
- HELM·MedHELM, Artificial Analysis Healthcare & Medical Index: 여러 benchmark를 묶어 하나의 종합 점수로 제시
저자들은 종합 점수의 의미가 "포함된 benchmark가 무엇을 평가하고 누구의 needs를 대표하는가"에 달려 있다고 지적합니다. 또한 기존 benchmark 중 상당수는 Score saturation(점수 포화)이나 Limited discrimination(모델 간 변별력 부족) 때문에 frontier model을 구분하지 못합니다. 따라서 benchmark를 체계적으로 audit하고, 직접 reproduction으로 검증하고, role·capability 축에 따라 구조화하는 새로운 평가 체계가 필요하다는 것이 이 논문의 출발점입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Collection → Auditing → Independent reproduction → Index aggregation으로 이어지는 4단계 pipeline을 제안합니다 [Figure 2].
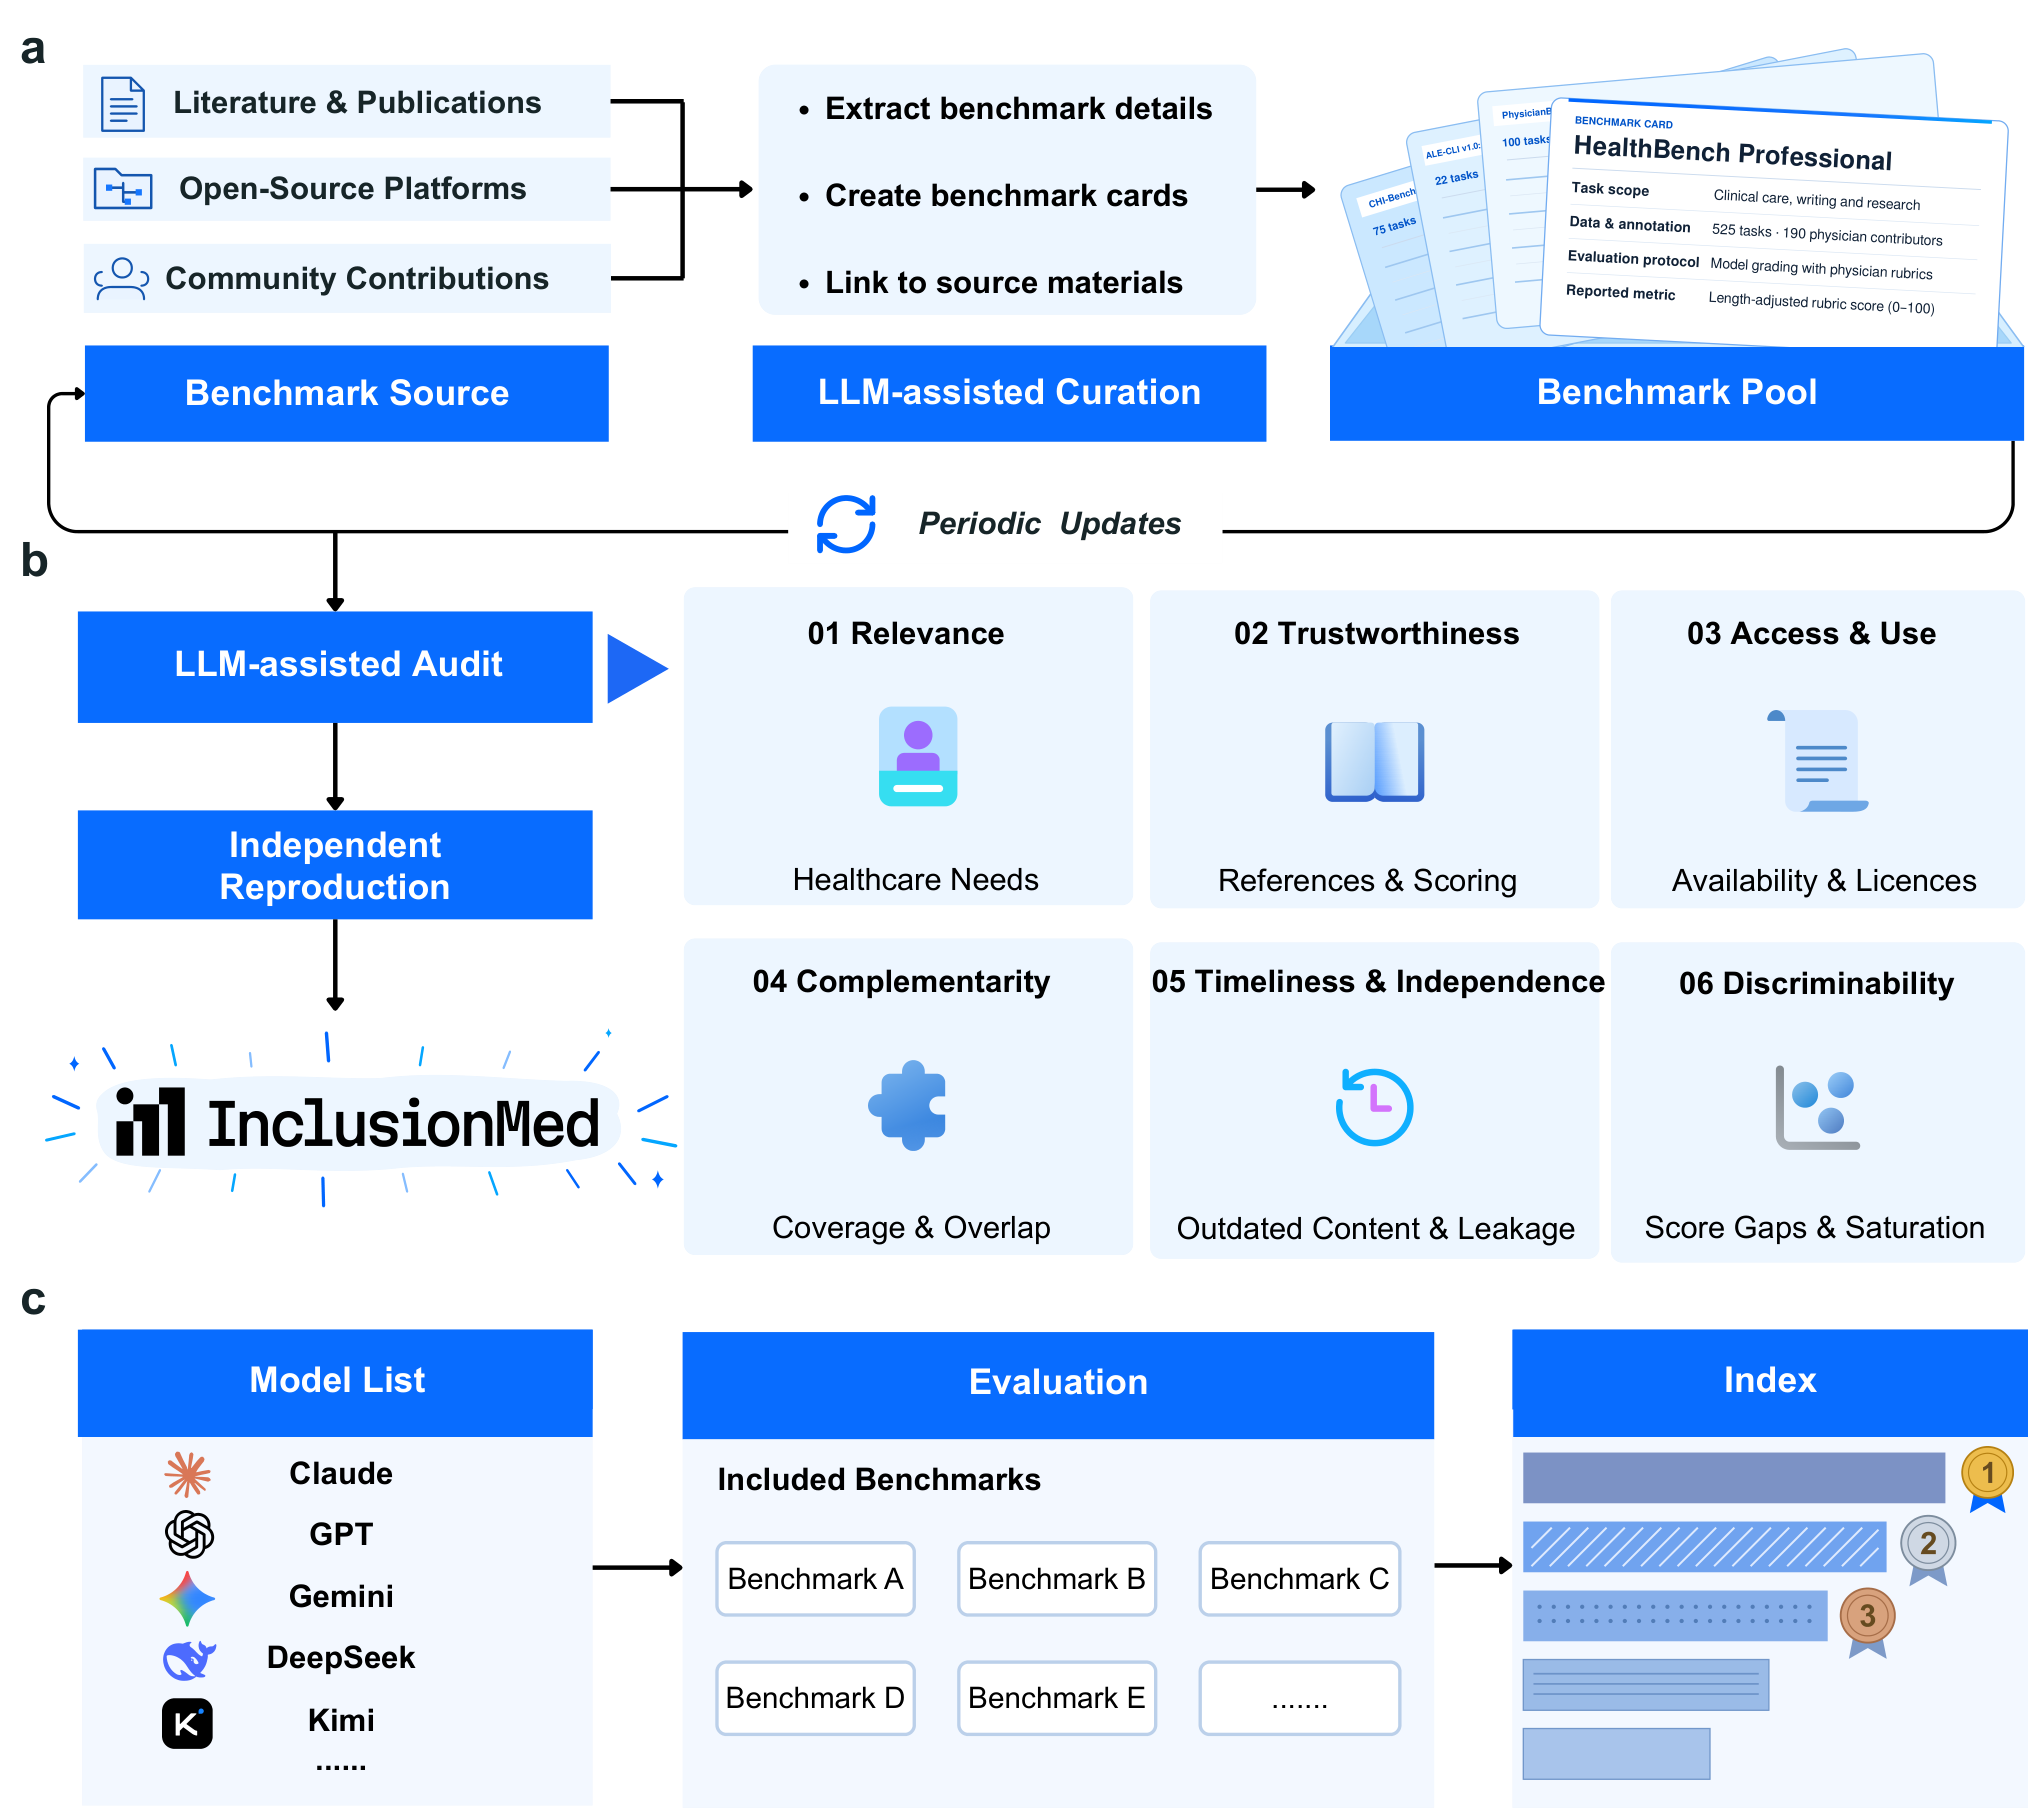
Figure 2 — InclusionMed 전체 workflow
Benchmark 선정 과정
- Collection: 문헌, 공개 플랫폼, 커뮤니티 기여를 통해 388개 후보 benchmark를 모으고, LLM-assisted curation으로 benchmark card를 만들었습니다.
- Auditing: Agent skill 기반 LLM audit과 human review를 함께 거쳐 6가지 기준을 순서대로 적용했고, 후보를 8개로 좁혔습니다.
- Independent reproduction: 8개 후보를 동일한 8개 모델로 직접 재현한 결과는 다음과 같습니다.
- Score saturation으로 제외: XLingHealth, NEJMQA-Exams, PubHealthBench
- Limited discrimination으로 제외: HealthBench
- 최종 채택(공개 benchmark 4개): HealthBench Professional(525 tasks), PhysicianBench(100 cases, FHIR 기반 EHR agent), ALE-CLI v1.0: Health and Medicine(22 tasks), CHI-Bench(75 cases)
- 여기에 InclusionMed-DxFiles를 더해 총 5개 benchmark가 9개 cell 중 3개만 채웠습니다.
평가 설정
- 11개 family, 22개 모델을 평가했습니다.
- 평가 방식은 benchmark에 따라 direct API call, FHIR agent, CLI agent를 사용했습니다.
- Task-level tag(clinical specialty, medical expertise, healthcare workflow 등)로 benchmark 내부를 세부 분석했습니다.
주요 정량 결과
- 종합 Index 점수: 17.5 ~ 49.1 범위입니다. 상위권은 다음과 같습니다.
- Gemini 4 Argon: 49.1로 1위
- Claude Opus 5.5, Claude Fable 5.1: 각각 48.9
- GPT-6 Astra: 45.1
- Role·capability별 순위 변동:
- Healthcare professionals 1위: Claude Opus 5.5(55.6)
- Reasoning 1위: GPT-6 Astra(58.7)
- Agency 1위: Claude Fable 5.1(46.1)
- GPT-6 Luna는 Reasoning에서 8위였지만 Agency에서는 20위였습니다.
- GLM-5.3은 Healthcare professionals에서 14위였지만 Administration에서는 4위였습니다.
- Administration role 점수는 모든 모델에서 Healthcare professionals 점수보다 낮았습니다(최고 25.3).
- Task attribute 분석(상위 10개 모델, HealthBench Professional):
- Medical expertise: 10개 모델 모두 Patient communication(median 69.1)이 Clinical decision-making(55.5)보다 높았습니다. Medical calculation(47.0)과 Safety and ethics(48.8)가 가장 낮았습니다.
- Clinical specialty: Psychiatry의 median이 49.4로 가장 낮았습니다.
- Healthcare workflow: Treatment planning and implementation의 median이 53.0으로 가장 낮았습니다.
- PhysicianBench failure 분석: 실패한 checkpoint 912개 중 51.4%가 clinical reasoning이었습니다. Category 내부 failure rate의 median은 Action execution(17.4%)과 Documentation(14.6%)이 가장 높았습니다.
- Performance–cost trade-off:
- Kimi K3(37.9, task run당 $1.51)와 GPT-5.6 Luna(36.9, $0.064)는 점수가 비슷하지만 cost 차이가 약 24배입니다.
- Claude Fable 5.1과 Claude Opus 5.5는 점수가 같지만 cost는 $4.12 vs $1.68로 약 2.5배 차이입니다.
- Pareto frontier에 오른 모델은 GPT-6 Luna, GPT-5.6 Luna, DeepSeek V4.1 Flash, GPT-6.1 Sol, Gemini 4 Argon 5개입니다.
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은, 단일 종합 순위만으로는 medical AI 모델을 고를 수 없으며 role·capability·task·cost를 함께 고려하는 context-specific model selection이 필요하다는 것입니다. 현재 portfolio의 coverage 한계도 분명히 드러났습니다.
- 후보 benchmark의 88%가 영어를 포함합니다.
- 지리적 setting을 확인할 수 있는 task 338개 중 318개가 미국과 연관됩니다.
- Patients and the public을 주 대상으로 하는 benchmark는 하나도 없습니다.
저자들은 이 때문에 현재 Index가 향상되더라도, 이런 집단과 환경에서 성능이 좋아졌다는 뜻은 아니라고 명시합니다.
학계에 주는 시사점은, benchmark를 단순히 늘리는 것보다 audit과 reproduction 기반의 큐레이션, 그리고 coverage gap을 명시적으로 드러내는 것이 더 중요하다는 점입니다. 산업계에서는 점수가 비슷한 모델 사이에 최대 24배의 cost 차이가 있다는 결과가 실제 배포 시 모델 선택 기준으로 바로 쓰일 수 있습니다. 다만 특정 임상 배포에 적합한지는 의도한 환경에서 별도로 검증해야 한다고 저자들은 강조합니다.
향후 과제로는 네 가지를 제시합니다.
- 다양한 healthcare needs 반영 확대
- Benchmark weight sensitivity analysis
- 자원 제약 하의 평가
- 시간에 따라 비교 가능한 evidence 축적
이를 open collaboration과 community contribution을 통해 진행할 계획입니다.
참고: 웹 페이지에서 이미지 URL을 확인할 수 있었던 것은 Figure 2뿐이어서, Part 2에는 Figure 2 하나만 포함했습니다. Figure 1·3·4·5는 이미지 경로를 찾지 못했고, Table 2 등은 HTML 테이블이라 제외했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] GlyphAtlas: Disentangling Stroke Detail from Layout for Scene Text Synthesis
- 현재글 : [논문리뷰] InclusionMed: Benchmarking AI for Inclusive Healthcare
- 다음글 [논문리뷰] Invariant-Aware Harness Enforcement to Protect LLM Agents from Silent API Failures
댓글