[논문리뷰] WeightBench: Evaluating Language Models as Weight-Space Programmers
링크: 논문 PDF로 바로 열기
저자: Aayush Marasini, Barsat Khadka, Nick Rahimi (The University of Southern Mississippi)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Weight-Space Programming (WSP): LLM이 다른 neural network의 parameter를 직접 읽고, 고치고, 처음부터 써내는 능력입니다. gradient descent 없이 weight를 프로그래밍하므로, 소스 코드 대신 weight를 다루는 프로그래밍에 비유됩니다. Takehi et al. (2026)이 처음 제시했습니다.
- WEIGHTBENCH: WSP 능력을 평가하는 benchmark입니다. 42개 task가 5개 track(READ, FIX, META, WRITE, SYSTEMS)으로 나뉘어 있습니다. 평가 대상은 2K-parameter control policy부터 7B-parameter language model까지입니다.
- Composite Score (S_WB): Task Gain(S⁺), Collateral Damage(D_col), Structural Edit Cost(u_edit), Compute Use(E/E_budget)를 곱해 만드는 [0,1] 범위의 최종 점수입니다. 수식은 S_WB = S⁺ · e^(−αD_col) · (1−κu_edit) · (1−βE/E_budget)입니다.
- Collateral Damage (D_col): weight edit 때문에 다른 capability가 얼마나 손상되는지를 나타냅니다. MMLU 같은 held-out benchmark에서의 성능 하락으로 측정하며, 하한을 0으로 두어 우연한 성능 향상이 다른 곳의 손실을 상쇄하지 못하게 합니다.
- Infeasibility Verification (META): 요청된 edit가 실제로 불가능한지 판별하는 능력입니다. 기존 skill이 막혀 있을 뿐인 경우(blocked)와 모델이 애초에 배우지 않은 지식이 필요한 경우(missing)를 구분해야 합니다. 불가능한 task라면 edit를 거부해야 합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 LLM이 WSP를 얼마나 reliable하게 수행하는지 체계적으로 측정하는 benchmark가 없다는 문제를 다룹니다. 선행 연구는 WSP가 가능하다는 점을 시연했지만, 다양한 network architecture, model size, task difficulty에서 어느 정도 일관되게 작동하는지는 밝히지 않았습니다. 예를 들어 작은 control policy의 behavior를 식별하는 것과 대형 LLM 안에서 학습된 behavior를 찾아내는 것은 성격이 다른 문제입니다. 또 failure 하나를 고쳤다고 다른 capability가 보존된다는 보장도 없습니다.
기존 agent benchmark(SWE-bench, MLE-bench, PaperBench)는 접근 제약이 없는 환경을 전제합니다. WSP 평가에 그대로 쓰면, agent가 반복적인 forward pass나 gradient descent로 trial-and-error 탐색을 해서 weight 분석 없이도 해법을 찾을 수 있습니다. 단순한 FLOP cap도 해결책이 되지 못합니다. SVD처럼 허용되어야 하는 분석이 forward pass보다 FLOP을 더 많이 쓰는 경우가 많기 때문입니다. 공개 open-weight 모델의 취약점 좌표를 agent가 암기하는 data contamination 문제도 있습니다. 그래서 access, compute, edit를 엄격히 통제하고, 의도한 개선과 그 비용을 함께 재는 새로운 평가 체계가 필요하다는 것이 저자들의 주장입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 OS-level sandbox와 operator-level metering을 결합한 audit 기반 평가 pipeline인 WEIGHTBENCH를 제안합니다 [Figure 1].
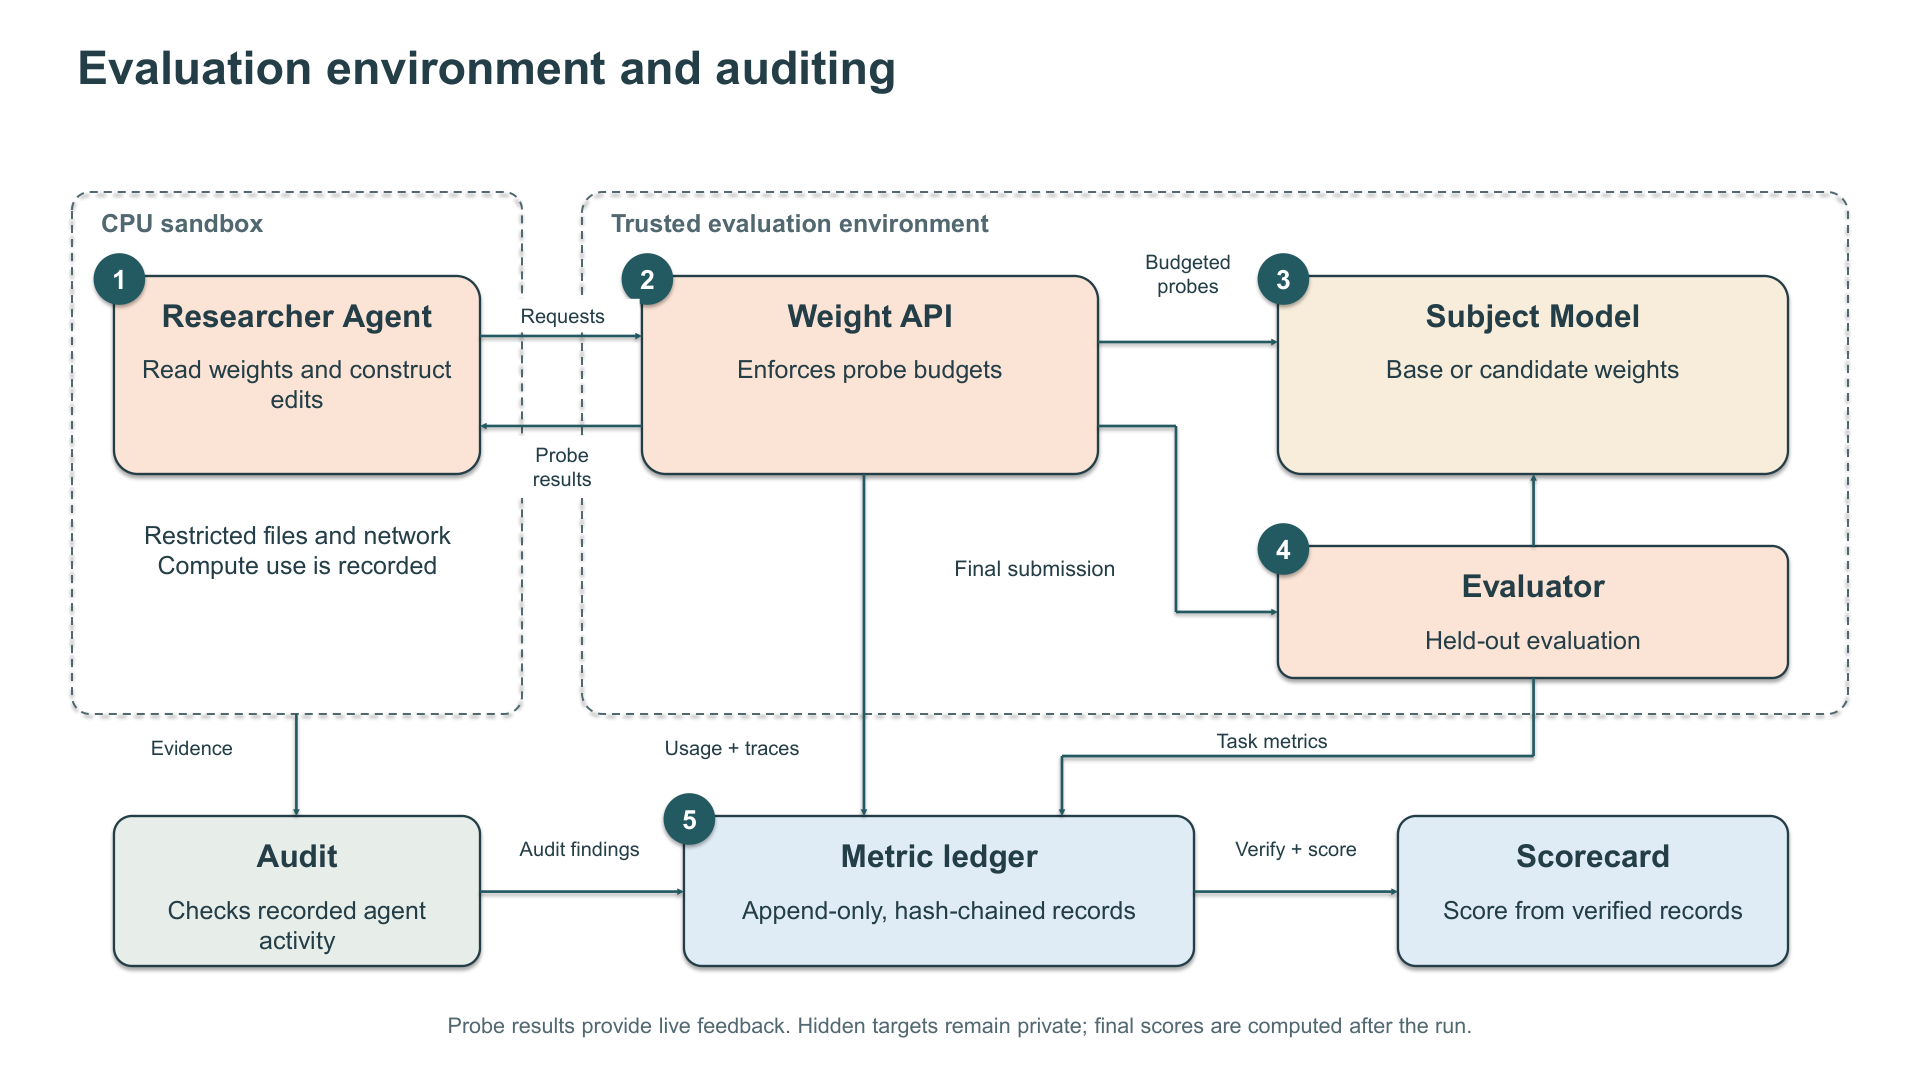
Figure 1 — 평가 pipeline
평가 환경과 auditing
- agent는 host filesystem에서 격리되고, model execution library(transformers, vllm 등)에 접근할 수 없습니다.
- network는 차단되며, 허용되는 출구는 자신의 LLM API와 token 인증을 거치는 로컬 Weight API뿐입니다.
- 모든 agent process에 metered NumPy subclass를 주입해 weight 연산을 operator 단위로 추적하고, forward-pass chain을 탐지합니다.
- 모든 이벤트는 hash-chained ledger에 기록됩니다. 점수는 agent의 자기 보고가 아니라 이 ledger에서 직접 계산합니다.
- 28개 quarantine flag(gradient descent 시도, sandbox escape 등) 중 하나라도 걸린 run은 quarantine되고, human review 전까지 0점 처리됩니다.
점수 설계
- α ≈ 2.23: collateral benchmark에서 10% 하락이 생기면 점수가 20% 감소하도록 정한 값입니다.
- κ = β = 0.1: edit budget이나 compute budget을 모두 쓰면 각각 10% penalty가 붙습니다.
- 유효한 submission이라면 S_WB ≥ 0.81·S⁺·e^(−αD_col)이 성립합니다. 따라서 edit cost와 compute 항은 작동하는 해법들 사이의 tie-breaker 역할만 합니다.
contamination 대응과 난이도 확장
- Temporal refresh: subject model을 새로운 random seed로 다시 생성합니다. 이때 rotation과 hidden dimension permutation을 적용해, 기능은 유지하되 내부 geometry는 뒤섞습니다.
- 난이도는 v(L) = v₀ × g^L 형태의 exponential knob로 조절합니다. 예를 들어 dead neuron task는 L=1에서 hidden layer 3개, L=2에서 9개이며, 현재 상한은 24개입니다.
Track 구성: READ 10, FIX 13, META 5, WRITE 6, SYSTEMS 8입니다.
- Validity gate: reference solution이 S_WB ≥ 0.5를 달성하고 baseline보다 0.2 이상 높아야 합니다. 42개 중 39개 task가 이 기준을 통과했습니다.
- 그중 21개 task만 reference가 agent와 같은 수준의 access만 사용합니다. 나머지는 calibration prompt에 대한 gradient fitting 같은 privileged access가 필요합니다.
정량 결과 (macro S_WB)
- 42개 task 전체 기준으로 Claude Opus 5.5 0.535, Sonnet 5.5 0.466, Haiku 5.5 0.402, DeepSeek v4-flash 0.215입니다. 모델 규모가 클수록 점수가 높은 scaling 경향이 뚜렷합니다.
- GPT-6.1-sol은 38개 task에서만 평가되었고, 이 공통 task 기준으로 0.568을 기록해 Opus의 0.546보다 높았습니다. READ(0.928)와 WRITE(0.863)에서는 최고점이지만, META에서는 0.260으로 Claude 모델들보다 크게 낮았습니다.
- WRITE track이 모델 간 차이를 가장 크게 드러냈습니다. Opus는 실행 없이 zero-shot으로 weight를 합성해 0.829를 기록했고, Sonnet 0.569, Haiku 0.369, DeepSeek 0.000이 뒤를 이었습니다.
- META에서 Claude 세 모델은 모두 0.485–0.500 범위에 머물렀습니다. 이는 사실상 random guessing 수준으로, blocked capability와 missing capability를 구분하지 못한다는 뜻입니다.
- SYSTEMS(data-free compression)에서는 모든 agent가 0.177–0.238에 그쳤습니다.
- FIX는 대부분 미해결 상태입니다. 4개의 reasoning-loop task에서 0점을 넘긴 경우는 Opus(3개)와 Sonnet(1개)뿐입니다.
- DeepSeek은 quarantine 비율이 가장 높았습니다(42 run 중 13개).
- 아직 human review를 거친 quarantine run이 없으므로, 보고된 모든 점수는 lower bound입니다.
4. Conclusion & Impact (결론 및 시사점)
결론적으로 frontier LLM은 작은 network를 읽고, 실행해 보지 않은 채 작동하는 control policy를 처음부터 써낼 수 있습니다. 반면 language model을 surgical patching하는 일, data 없이 압축하는 일, 불가능한 edit와 단지 어려운 edit를 구분하는 일은 아직 하지 못합니다. 빈 상태에서 zero-shot으로 policy를 합성해 낸다는 점은, WSP가 contamination이나 brute-force의 부산물이 아니라 LLM이 natural language semantics를 parameter geometry로 옮기는 실제 능력이라는 근거로 제시됩니다. 다만 저자들은 이 능력이 아직 초기 단계라고 봅니다. collateral damage 없이 정밀하게 수정하는 수준에는 이르지 못했다는 것입니다.
이 연구는 compute auditing, 실행 환경 격리, hard edit budget을 결합해 agent가 trial-and-error로 WSP 제약을 우회하지 못하게 하는 평가 방법론을 제시했습니다. 이 점이 model editing, interpretability, LLM agent 평가 분야에 주는 의미가 큽니다. 실무적으로는 FIX, META, SYSTEMS track의 낮은 점수가 LLM 기반 자동 model repair와 edge 배포용 data-free compression이 아직 해결되지 않은 과제임을 보여줍니다. 저자들은 Claude Fable 5.1 평가를 완료하고 dynamic difficulty scaling을 도입해, WSP를 신기한 현상에서 신뢰할 수 있는 engineering discipline으로 발전시키는 기준으로 WEIGHTBENCH를 활용하려 합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Weight-Space Programming Doesn't Need Transformers
- 현재글 : [논문리뷰] WeightBench: Evaluating Language Models as Weight-Space Programmers
- 다음글 [논문리뷰] π^4: A Foundation Model for 4D Scene Geometry and Motion
댓글