[논문리뷰] MaxKernel: Agentic Kernel Generation for TPUs
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shangkun Wang, Nina Cai, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MaxKernel: TPU용 고성능 커널을 자동으로 생성, 최적화 및 디버깅하기 위해 설계된 다중 에이전트 프레임워크입니다.
- JaxBench: TPU 환경에서 50개의 다양한 커널 태스크를 포함하여 최적화 성능을 평가하는 벤치마크 스위트입니다.
- Pallas: JAX 내에서 커널 수준의 최적화를 수행하기 위해 사용하는 프로그래밍 인터페이스입니다.
- XProf: 커널의 실시간 하드웨어 지표(latency, memory bandwidth 등)를 추출하여 피드백을 제공하는 프로파일링 도구입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 딥러닝 아키텍처의 가속화를 위해 필수적인 수동 커널 엔지니어링의 복잡성과 전문 지식 의존도를 해결하고자 합니다. 기존 방식은 하드웨어의 메모리 계층(HBM, SRAM/VMEM)을 수동으로 관리하고 복잡한 DMA pipelining을 최적화해야 하므로 진입 장벽이 매우 높습니다. 또한, 기존 LLM 기반 커널 생성 연구들은 하드웨어 제약 조건과 불투명한 컴파일러 오류로 인해 실제 성능 최적화에 한계를 보입니다 [Figure 1]. 따라서 하드웨어 실시간 피드백을 활용하여 반복적인 최적화 루프를 자동화할 수 있는 새로운 접근 방식이 요구됩니다.
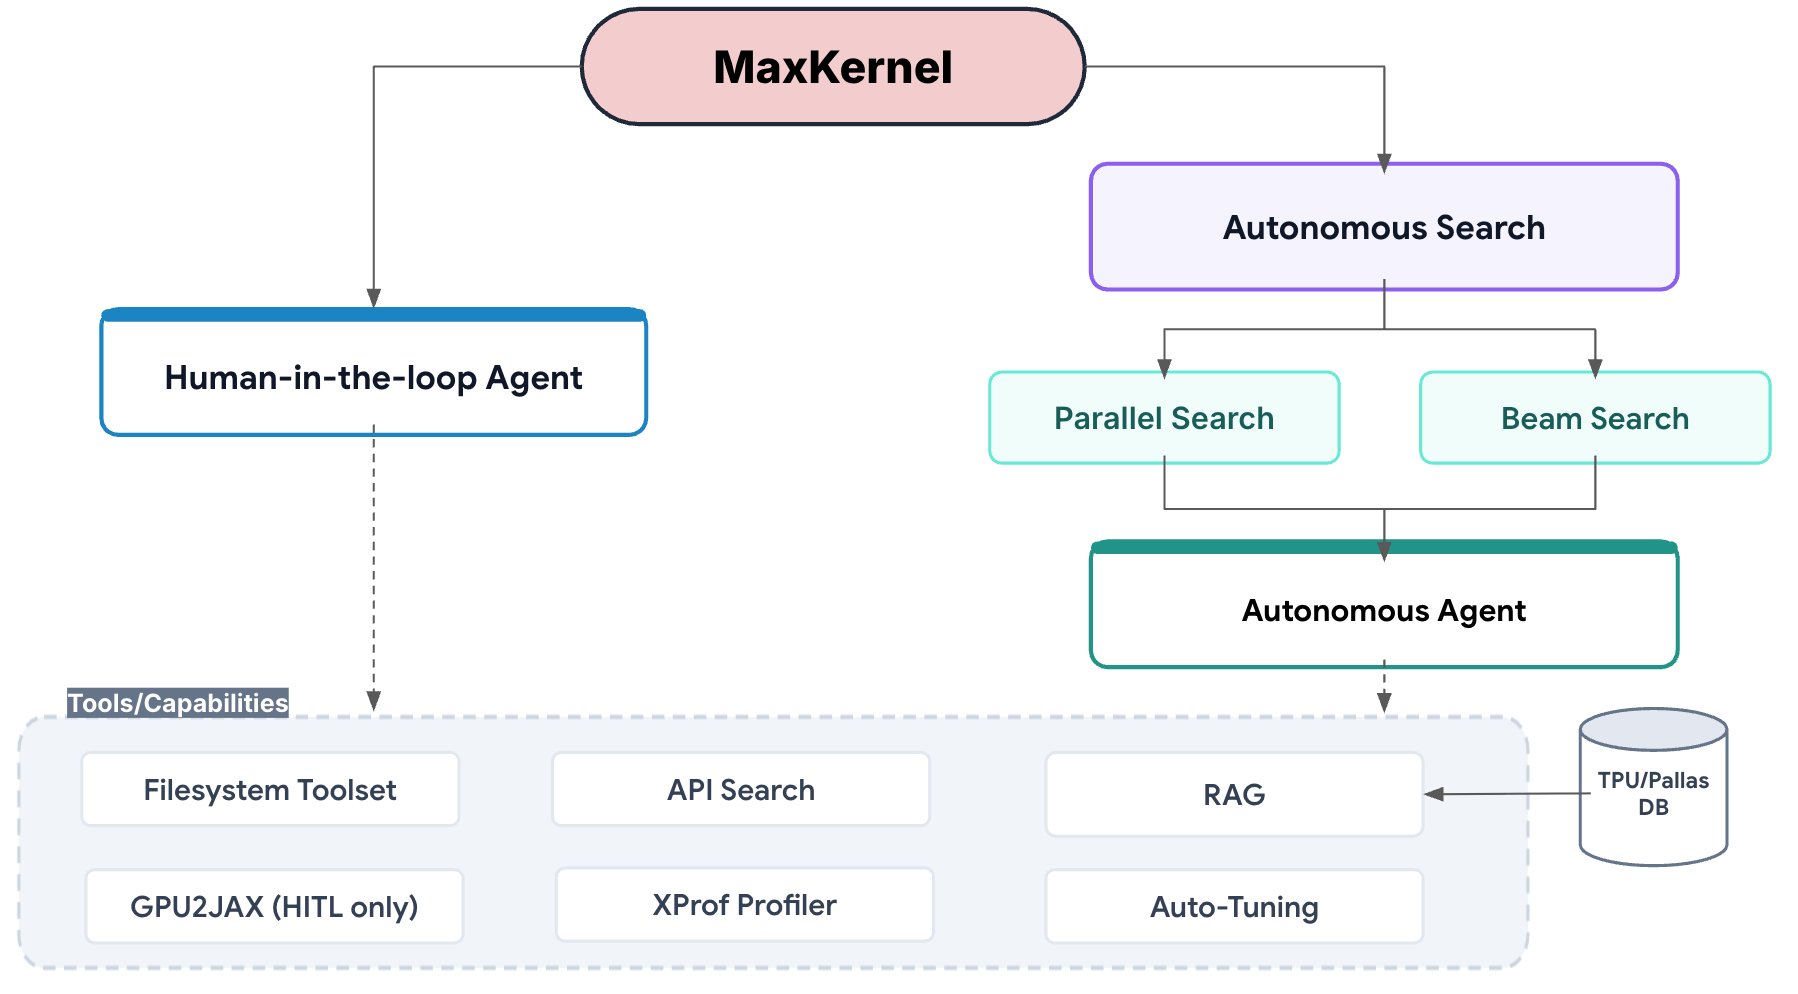
Figure 1 — MaxKernel 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 모듈화된 다중 에이전트 구조를 기반으로 하는 MaxKernel 프레임워크를 제안합니다. 이 시스템은 계획, 구현, 테스트, 프로파일링 및 튜닝을 담당하는 specialized sub-agents로 구성되며, Human-in-the-Loop(HITL), Autonomous Loop(Auto), Graph-Based Autonomous Search의 3가지 운용 모드를 지원합니다 [Figure 1, 2, 3]. Graph-Based Autonomous Search는 커널 설계 공간을 그래프로 모델링하여 더 넓은 범위의 최적화를 수행하며, Parallel Search와 Beam Search 알고리즘을 통해 지역 최적점(local optima)을 효과적으로 회피합니다 [Figure 4]. 실험 결과, MaxKernel은 JAXBench에서 baseline 대비 1.58×의 geometric mean speedup을 달성하였으며, 8개의 실제 프로덕션 커널에서는 human-authored baseline(2.02×)을 상회하는 2.32×의 속도 향상을 기록했습니다 [Table 1, 2]. 또한, MaxKernel을 통해 생성된 코드는 SOTA OSS 모델의 forward/backward pass에서 최대 4.70× 이상의 유의미한 Latency 개선을 보여주었습니다 [Table 3].
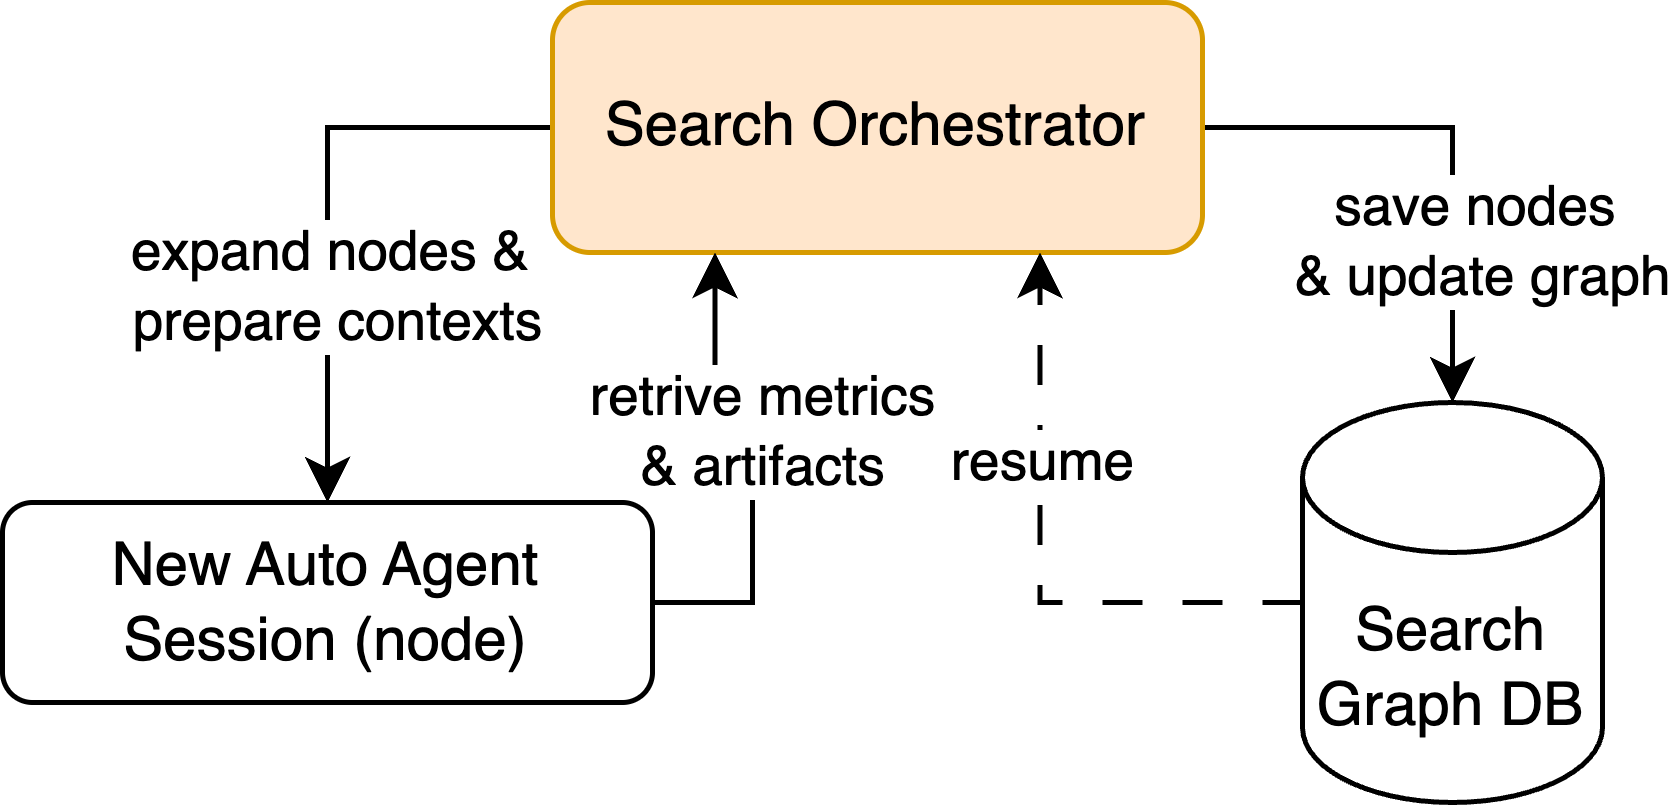
Figure 4 — 그래프 기반 자율 탐색 구조
4. Conclusion & Impact (결론 및 시사점)
본 연구는 에이전트 시스템이 하드웨어 수준의 복잡한 커널 엔지니어링을 효과적으로 자동화할 수 있음을 입증했습니다. 제안된 프레임워크는 프로파일링 기반의 피드백 루프와 체계적인 설계 공간 탐색을 통해 하드웨어 가속기 프로그래밍의 개발 생산성을 획기적으로 개선합니다. 이러한 성과는 학계뿐만 아니라 산업계의 대규모 가속기 컴퓨팅 환경에서 커널 최적화 비용을 대폭 절감하고, 차세대 가속기 하드웨어 도입을 가속화하는 중요한 시사점을 제공합니다.
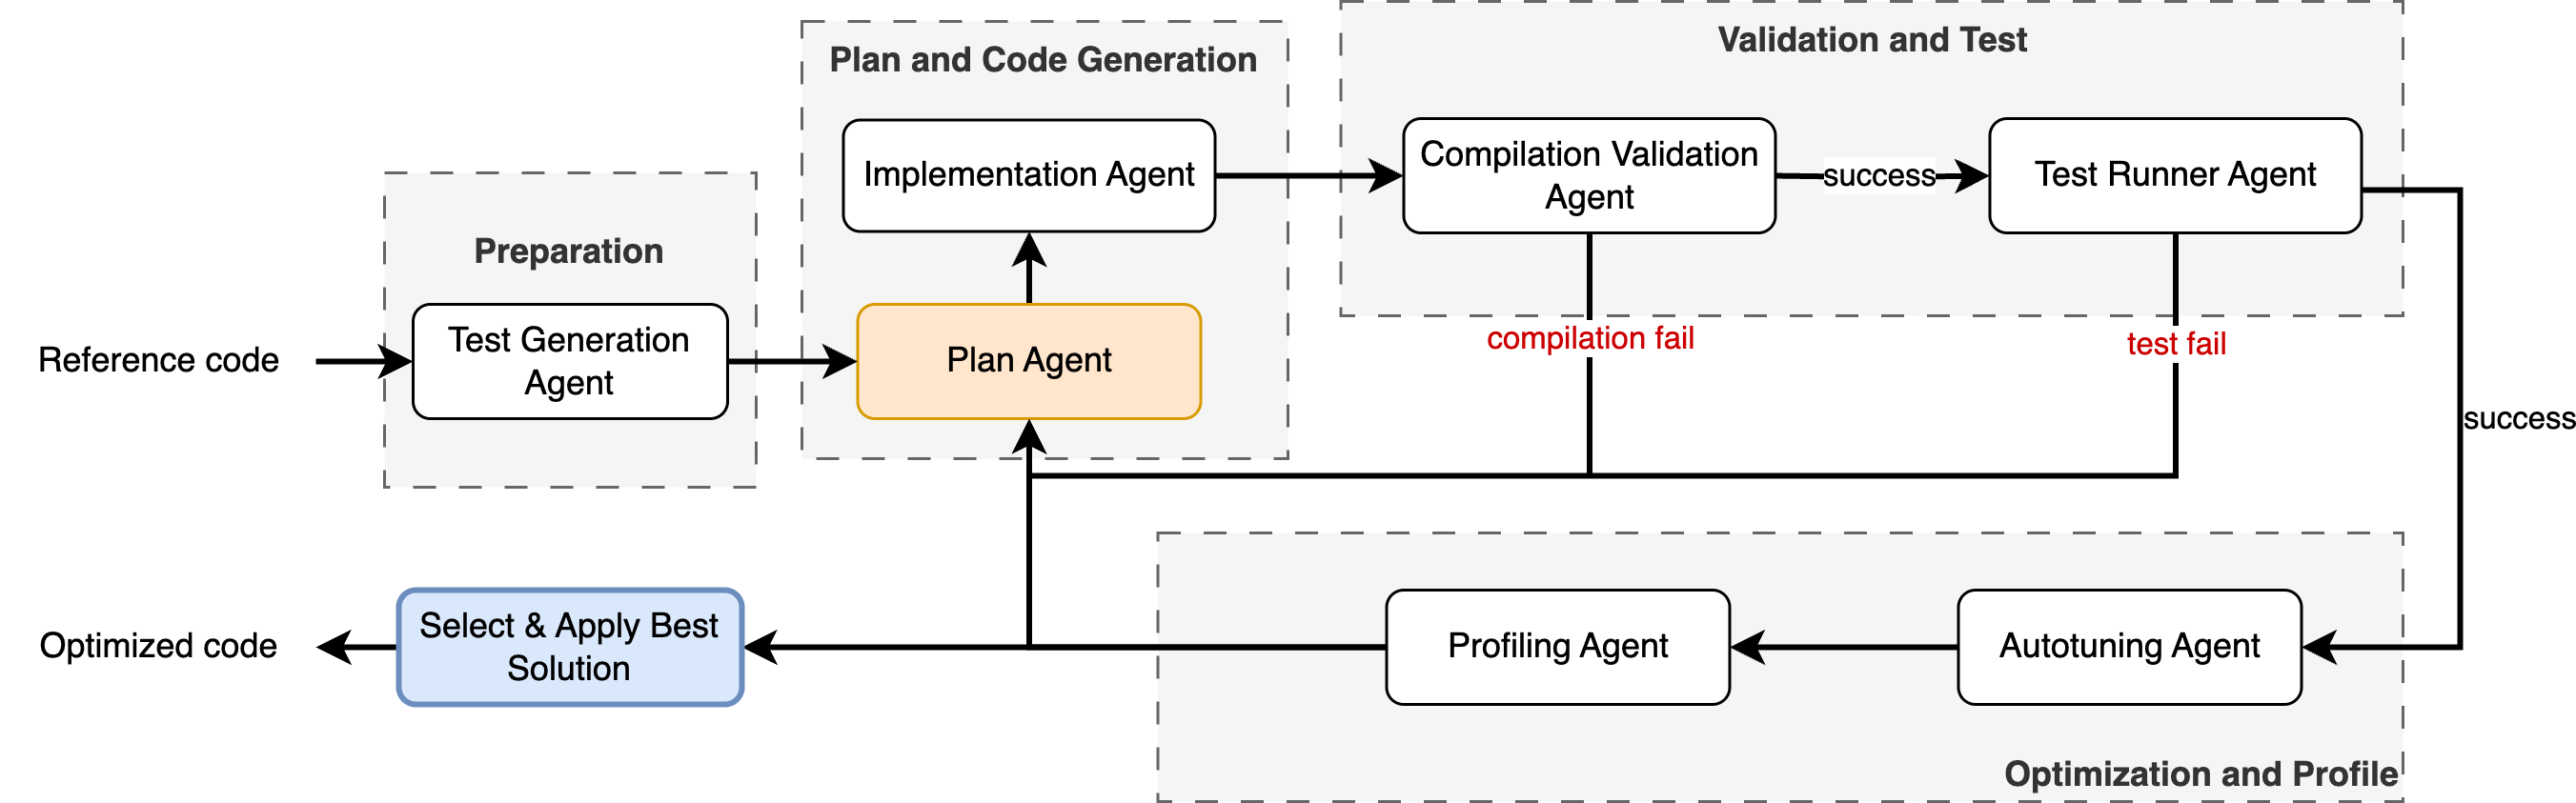
Figure 3 — Auto Agent 최적화 루프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agent Against Agent: An Agentic System for Automatic Prompt Injection Red Teaming
- [논문리뷰] Model or Harness? An Interaction-Centric Taxonomy for Localizing Agent Failures
- [논문리뷰] Adaptive Auto-Harness: Sustained Self-Improvement for Agentic System Deployment on Open-Ended Task Streams
- [논문리뷰] Vectorizing the Trie: Efficient Constrained Decoding for LLM-based Generative Retrieval on Accelerators
- [논문리뷰] veScale-FSDP: Flexible and High-Performance FSDP at Scale
Review 의 다른글
- 이전글 [논문리뷰] Knowing What Not to Answer: Selective Non-Compliance in Vision-Language Models
- 현재글 : [논문리뷰] MaxKernel: Agentic Kernel Generation for TPUs
- 다음글 [논문리뷰] Motion-Omni: End-to-End Joint Speech and Full-Body Motion for Spoken Dialogue
댓글