[논문리뷰] Training-Free Speech-Centric Omni Understanding with Frozen VLMs
링크: 논문 PDF로 바로 열기
메타데이터
저자: Ankan Deria, Hanoona Rasheed, Xilin He, Fahad Shahbaz Khan, Salman Khan
1. Key Terms & Definitions (핵심 용어 및 정의)
- Training-Free Omni (TFO): 별도의 학습이나 아키텍처 수정 없이, 고정된(Frozen) VLM을 사용하여 음성 중심의 Omni 이해 능력을 구현하는 프레임워크입니다.
- Audio-to-Language Routing: 오디오 입력을 Whisper를 통해 타임스탬프가 포함된 텍스트로 변환하고, 이를 VLM의 언어 인터페이스로 전달하여 처리하는 핵심 기법입니다.
- Frozen VLM: 사전 학습된 모델의 파라미터와 아키텍처를 그대로 유지하면서, 추가적인 Multimodal Alignment 학습 없이 활용하는 베이스 모델을 지칭합니다.
- Native Omni Models: 오디오 인코더를 추가하고 대규모의 오디오-비디오-텍스트 정렬(Alignment) 학습을 통해 Omni 능력을 획득한 기존의 모델군을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Native Omni 모델들이 VLM 백본에 특정 오디오 인코더를 결합하고 대규모 학습을 수행함에 따라 발생하는 효율성 및 성능 저하 문제를 해결하고자 합니다. 기존 방식은 새로운 VLM이 나올 때마다 복잡하고 비용이 많이 드는 재학습(Re-alignment)을 수행해야 하며, 이 과정에서 VLM의 기존 시각적·추론적 능력이 훼손되는 현상이 발생합니다. 저자들은 학습 없는 대안이 Native Omni 모델을 대체할 수 있는지, 그리고 VLM 백본의 원래 능력을 유지하면서도 효과적인 음성 이해가 가능한지 검증하는 것을 목표로 합니다 [Figure 1].
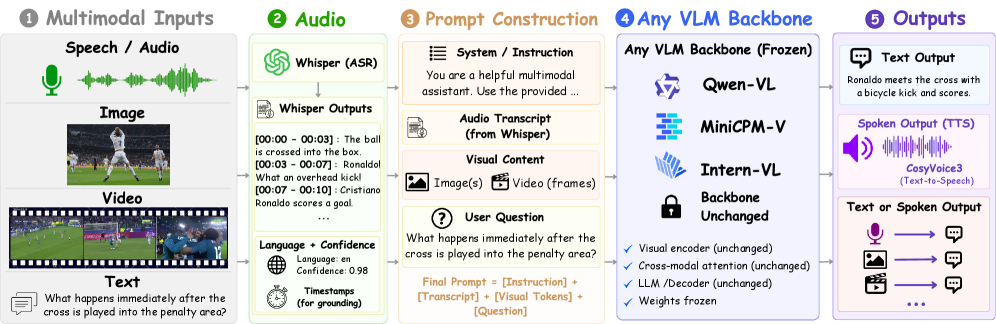
Figure 1 — TFO 프레임워크 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 TFO 프레임워크를 통해 Whisper를 외부 모듈로 활용하여 오디오를 언어 컨텍스트로 라우팅하는 방식을 제안합니다. 이 방식은 Confidence thresholding을 통해 신뢰도가 높은 전사(transcript)만을 선별하고, 타임스탬프 정보를 보존하여 VLM의 기존 인터페이스를 그대로 활용하는 방식을 취합니다 [Figure 1].
주요 실험 결과는 다음과 같습니다:
- Audio-Visual Understanding: 9개의 관련 벤치마크에서 TFO는 Native Omni 모델과 경쟁 가능한 성능을 보였으며, 특히 Qwen2.5-VL-3B 모델에서 평균 성능 향상을 기록했습니다 [Table 1].
- Audio-Only & Multilingual: 9개의 오디오 전용 벤치마크 및 21개 언어에 대한 다국어 음성 평가에서 Native 모델보다 우수한 성능을 입증했으며, 이는 TFO가 음성 중심 작업에서 강력함을 보여줍니다 [Table 2, Table 3].
- Capability Preservation: 이미지/비디오 이해, 코딩, 수학적 추론, 의학적 질의응답 및 시각적 접지(Visual Grounding) 등 오디오 라우팅과 직접적인 관련이 없는 분야에서도 Native Omni 모델 대비 강력한 성능을 유지함을 확인했습니다 [Table 4, Table 5, Table 6].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 강력한 음성 중심 Omni 이해 능력이 고가의 백본 학습 없이도 모듈형 오디오-언어 라우팅을 통해 획득 가능함을 입증했습니다. 이 연구는 VLM 아키텍처를 고정한 채 성능을 극대화할 수 있는 효율적인 전략을 제시하며, 향후 다양한 VLM으로의 확장이 용이하다는 점에서 큰 학계 및 산업적 가치를 지닙니다. 다만, 음악이나 비언어적 음향 신호 이해에는 한계가 있음을 명시하며, 향후 더 풍부한 음향적 표현을 통합하기 위한 추가적인 보완책이 필요함을 시사합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes
- [논문리뷰] OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models
- [논문리뷰] CAPEval: A Decoupled Caption Evaluation across Understanding and Generation
- [논문리뷰] UniClawBench: A Universal Benchmark for Proactive Agents on Real-World Tasks
- [논문리뷰] UniDDT: Unifying Multimodal Understanding and Generation with Decoupled Diffusion Transformer
Review 의 다른글
- 이전글 [논문리뷰] To See a World in a Living Context: Unified Indoor-Outdoor Urban World Generation
- 현재글 : [논문리뷰] Training-Free Speech-Centric Omni Understanding with Frozen VLMs
- 다음글 [논문리뷰] UniMate: One Unified Model to Animate Diverse Skeletons
댓글