[논문리뷰] UniMate: One Unified Model to Animate Diverse Skeletons
링크: 논문 PDF로 바로 열기
저자: Linzhan Mou, Jiahui Lei, Zhiyang Dou, Chenyue Cai, Chaoyue Song, Adam Finkelstein, Szymon Rusinkiewicz
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- TADiT (Topology-Aware Diffusion Transformer): 서로 다른 골격 구조(Skeletal Topology)를 가진 캐릭터들의 움직임을 단일 모델에서 생성하기 위해 설계된 핵심 프레임워크입니다.
- Spec-RoPE (Spectral Rotary Position Embedding): 그래프 라플라시안(Graph Laplacian) 스펙트럼을 활용하여 골격 구조에 불변하는(invariant) 위치 정보를 인코딩함으로써, 다양한 관절 수와 계층 구조에 대응하는 위치 임베딩 기법입니다.
- UniML3D (UniMate 3D Motion Dataset): 13,006개의 모션 시퀀스를 포함하며, bipedal, quadrupedal, insectoid 등 다양한 골격 유형을 통합하여 학습에 사용하는 대규모 데이터셋입니다.
- Graph-Aware Attention Bias: 관절 간의 관계와 지질학적 거리(Geodesic Distance)를 기반으로 하여 Attention 메커니즘이 골격 구조를 명시적으로 인지하게 하는 편향(bias) 설계입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존 모션 생성 모델들이 특정 골격 템플릿(예: SMPL, SMAL)에 종속되어 있어 다양한 캐릭터 구조를 처리하지 못하는 문제를 해결하고자 합니다 [Figure 1]. 기존 연구들은 Topology-agnostic한 모델을 시도하더라도 테스트 시점에 특정 골격에 맞춘 Fine-tuning이나 별도의 Reference Motion을 필요로 하는 한계를 가집니다. 저자들은 이러한 제약을 극복하고, 단일 모델이 Rigged 3D Asset과 Text Prompt만으로 임의의 골격 구조에 적합한 움직임을 Zero-shot으로 생성하는 것을 목표로 합니다. 이는 학습 효율성을 높이고 서로 다른 Topology 간의 모션 Priors를 공유함으로써 일반화 성능을 극대화하기 위함입니다 [Figure 2].
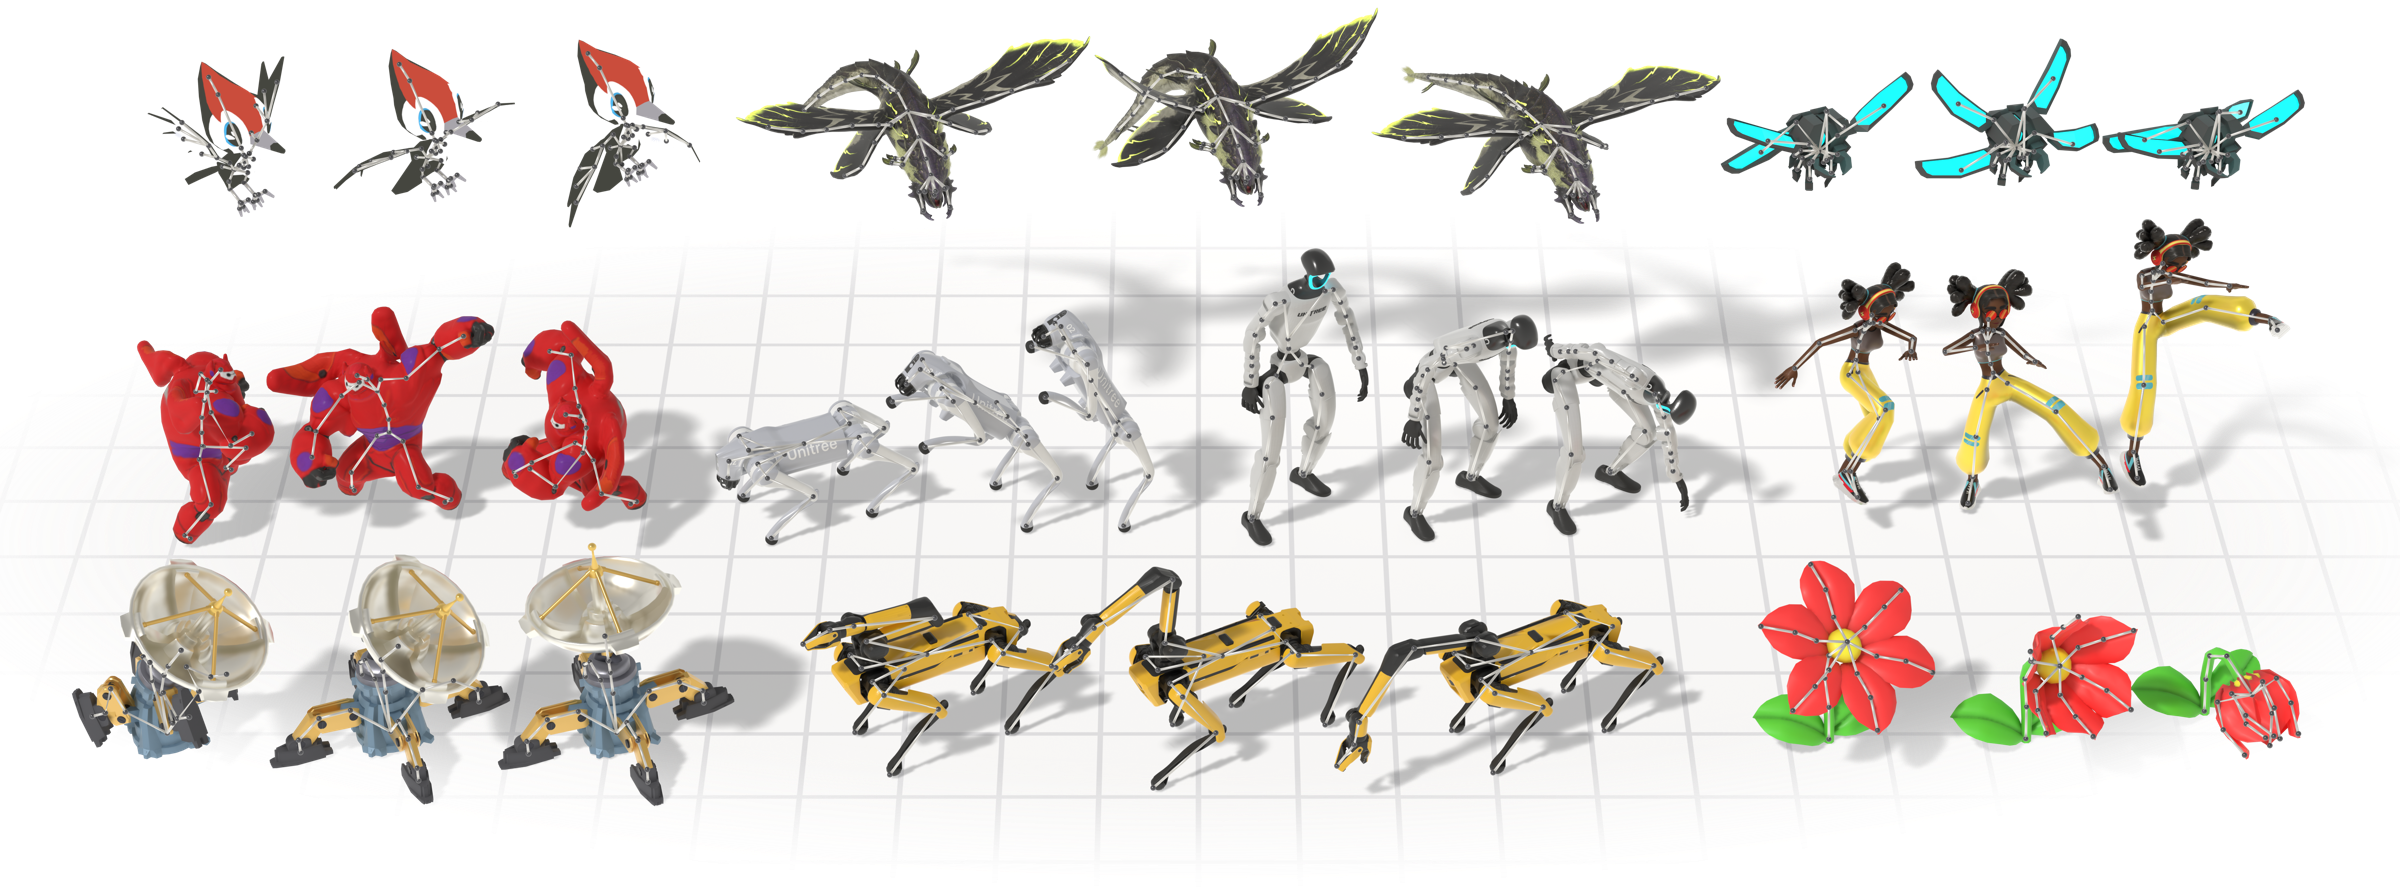
Figure 1 — UniMate의 모델 개념도
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 TADiT 아키텍처를 도입하여 골격 구조 정보와 모션 데이터를 하나의 Transformer 스트림 내에서 결합합니다 [Figure 3]. TADiT는 그래프 구조를 인지하는 Attention Bias, 유연한 위치 정보를 제공하는 Spec-RoPE, 그리고 골격의 전체적인 문맥을 보존하는 Global Topological Conditioner를 사용하여 복잡한 Kinematic Tree를 효과적으로 처리합니다 [Figure 3]. 실험 결과, UniMate는 기존의 SOTA 모델들 대비 더 넓은 범위의 골격 유형(bipedal, quadrupedal, marine, articulated objects 등)을 지원하며, 테스트 시 별도의 Optimization 없이도 높은 퀄리티의 결과를 생성합니다 [Figure 4]. 특히 정량적 성능 지표에서 기존 모델들보다 모션의 자연스러움과 프롬프트 일치도 면에서 우위를 점하며, Long-horizon 모션 생성 시에도 안정적인Temporal Coherence를 유지함을 입증했습니다 [Figure 8].
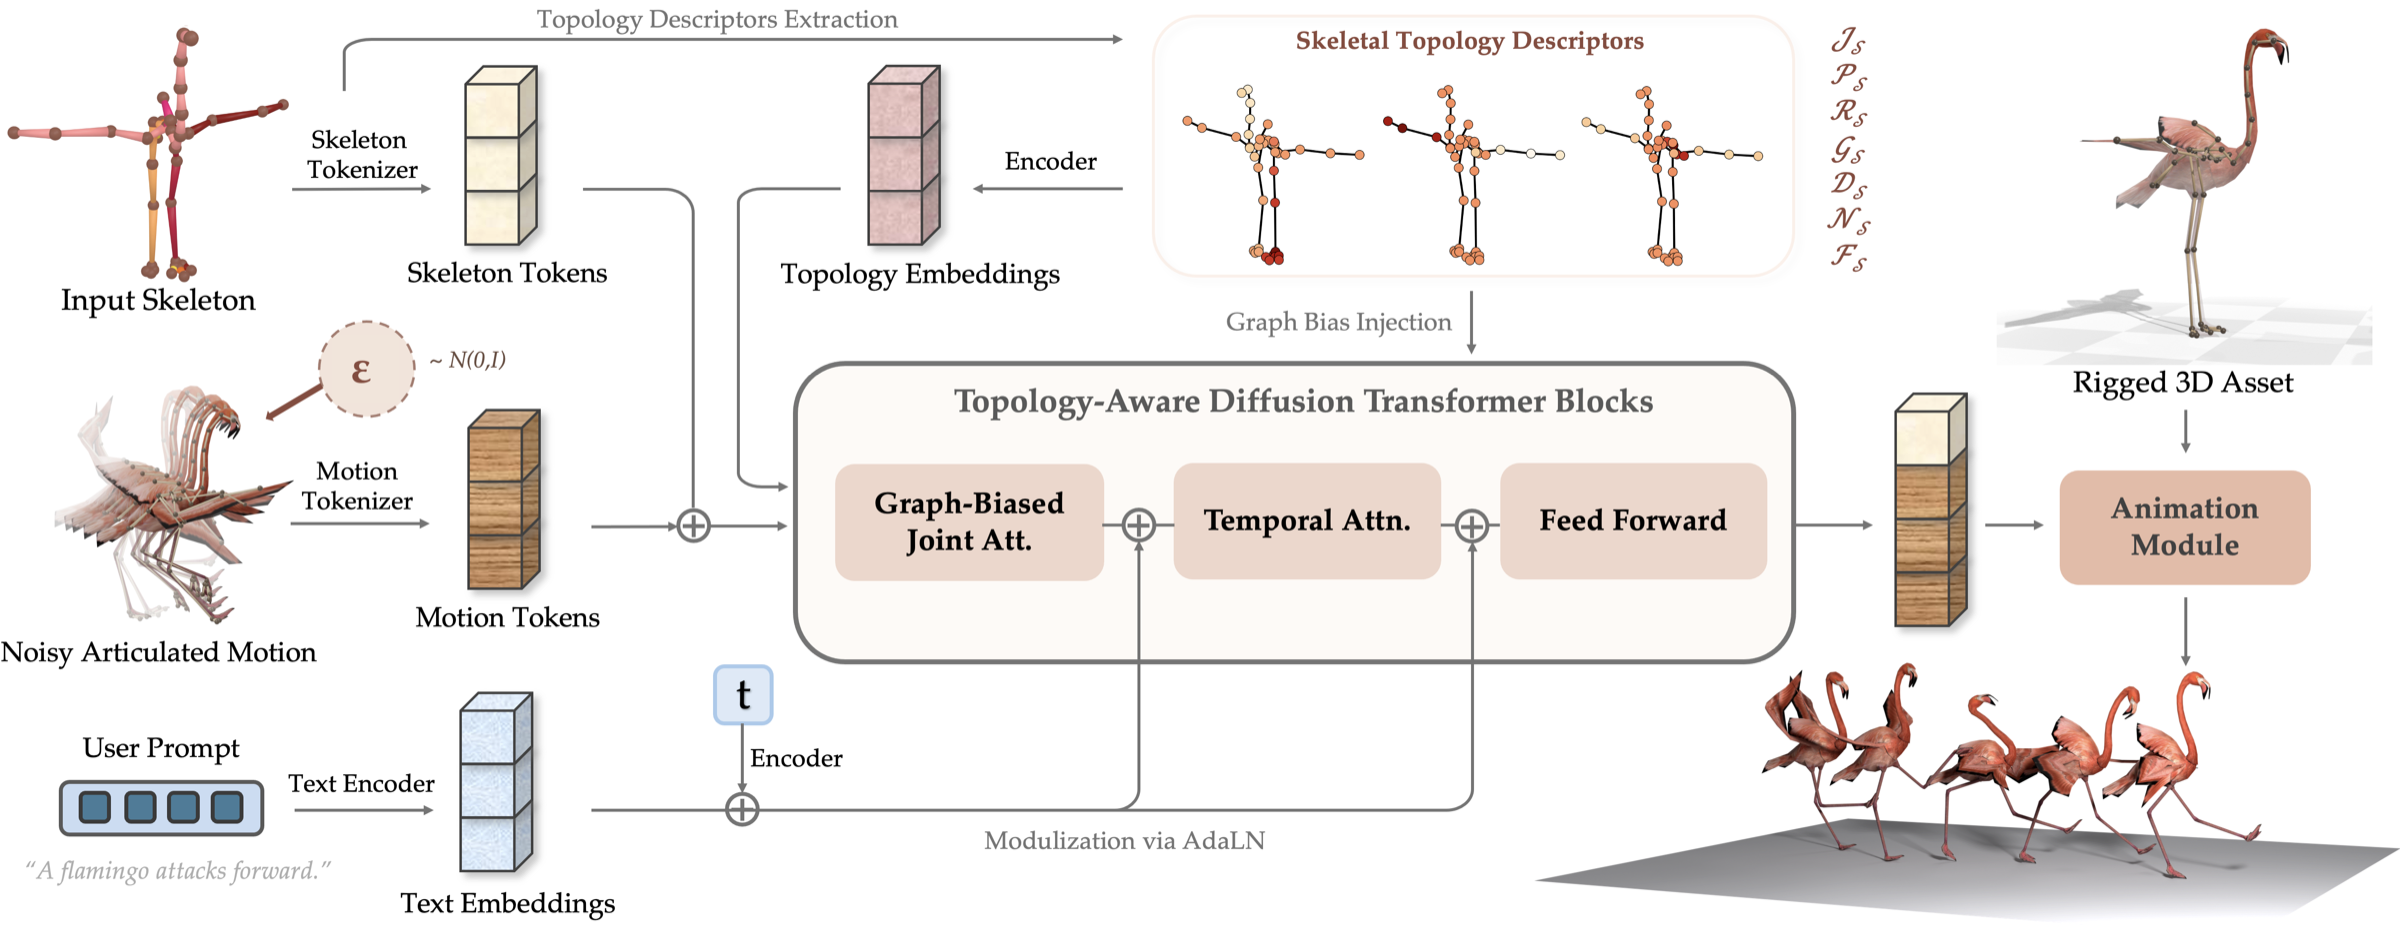
Figure 3 — TADiT 파이프라인
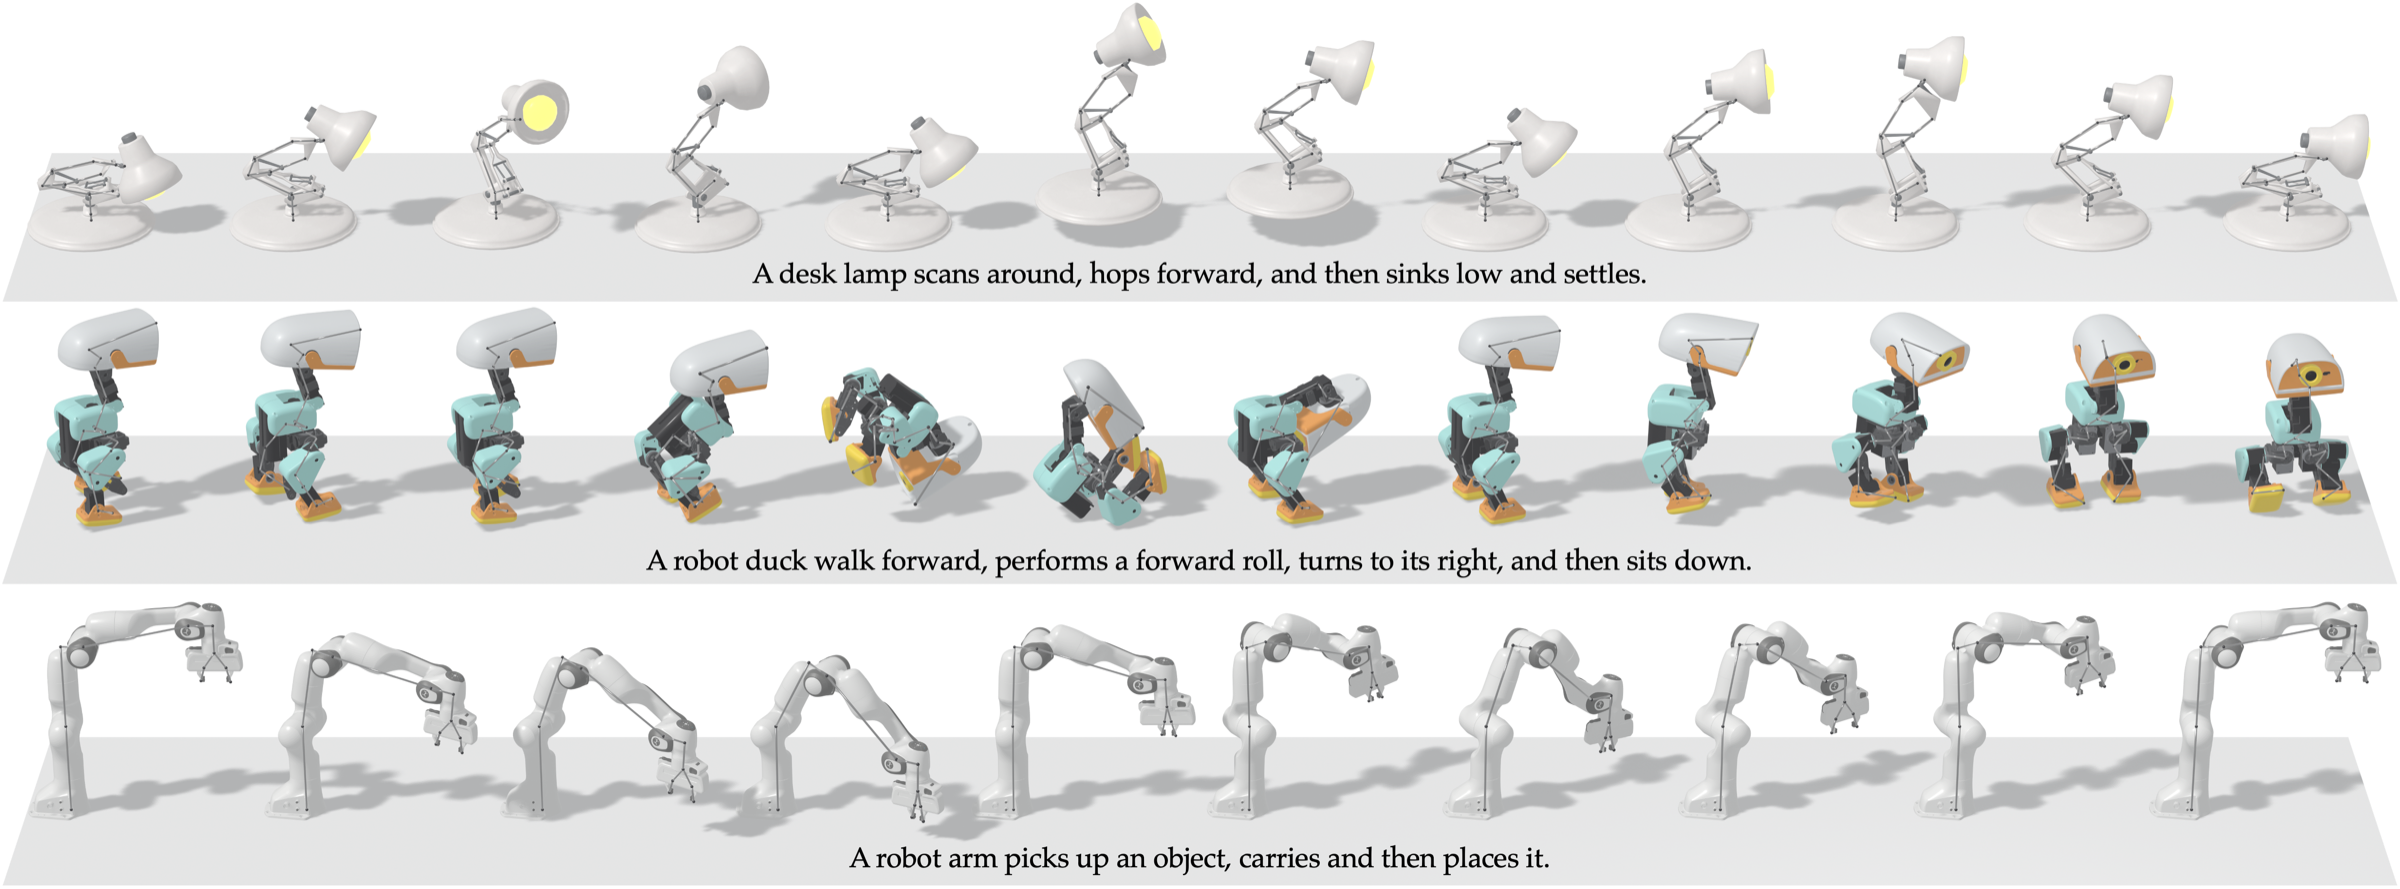
Figure 8 — 장시간 모션 생성 결과
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 다양한 골격 구조를 통합적으로 다룰 수 있는 최초의 범용 모션 생성 파운데이션 모델인 UniMate를 제안했습니다. 이 연구는 3D 캐릭터 애니메이션 생성을 수동 작업이나 개별 최적화 작업에서 해방시켜, 자동화된 콘텐츠 생성 파이프라인의 중요한 병목 현상을 해결합니다. 특히, Spec-RoPE와 같은 기술적 혁신은 Graph Neural Networks와 Diffusion Models의 결합 방식을 개선하여, 향후 다양한 도메인의 복잡한 구조적 데이터를 생성 모델링하는 데 중요한 기반을 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VideoMDM: Towards 3D Human Motion Generation From 2D Supervision
- [논문리뷰] Seed3D 1.0: From Images to High-Fidelity Simulation-Ready 3D Assets
- [논문리뷰] Ponimator: Unfolding Interactive Pose for Versatile Human-human Interaction Animation
- [논문리뷰] NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
- [논문리뷰] RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting
Review 의 다른글
- 이전글 [논문리뷰] Training-Free Speech-Centric Omni Understanding with Frozen VLMs
- 현재글 : [논문리뷰] UniMate: One Unified Model to Animate Diverse Skeletons
- 다음글 [논문리뷰] When Models Edit Too Much: On the Fidelity of Minimal Code Edits
댓글