[논문리뷰] NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
링크: 논문 PDF로 바로 열기
저자: Jiaqi Cao, Chiyu Chen, Shuang Cheng, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- NCP (Next Concept Prediction): 표준적인 토큰 단위의 Next-Token Prediction(NTP)을 넘어, 여러 토큰에 걸친 의미적 단위를 discrete한 latent concept으로 예측하는 사전 학습 목표입니다.
- Concept Module: 토큰화된 hidden states로부터 product-quantized concept vocabulary를 구축하고, 이를 통해 다음 개념을 예측하여 토큰 스트림에 주입하는 핵심 모듈입니다.
- IRC (Intra-Module Residual Connections): 단일 모듈 내에서 서로 다른 계층(Layer)의 표현을 결합하여, 이전 계층의 정보를 선택적으로 재사용하게 하는 hierarchical residual routing 기법입니다.
- CRC (Cross-Module Residual Connections): 서로 다른 모듈(Token Encoder, Concept Module, Token Decoder) 간의 표현을 전송하고 정렬하는 residual 연결 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 표준적인 NTP가 semantic structure를 학습하는 데 있어 간접적인 supervision에 의존한다는 점을 극복하기 위해 latent-space 기반의 모델을 제안합니다. 기존 대규모 언어 모델은 매개변수 규모를 확장하는 데 집중해 왔으나, 모델이 학습하는 representation space의 구조적 효율성은 상대적으로 underexplored 상태였습니다. 기존 아키텍처는 고차원적 의미를 직접 예측하지 못하고 granular token 수준의 손실 함수에만 의존하여 정보 압축 및 추론 효율성에서 한계를 보입니다. 이를 해결하기 위해 저자들은 [Figure 2]와 같이 토큰 간의 의존성을 직접 모델링하는 NCP 기반의 아키텍처를 도입하였습니다.
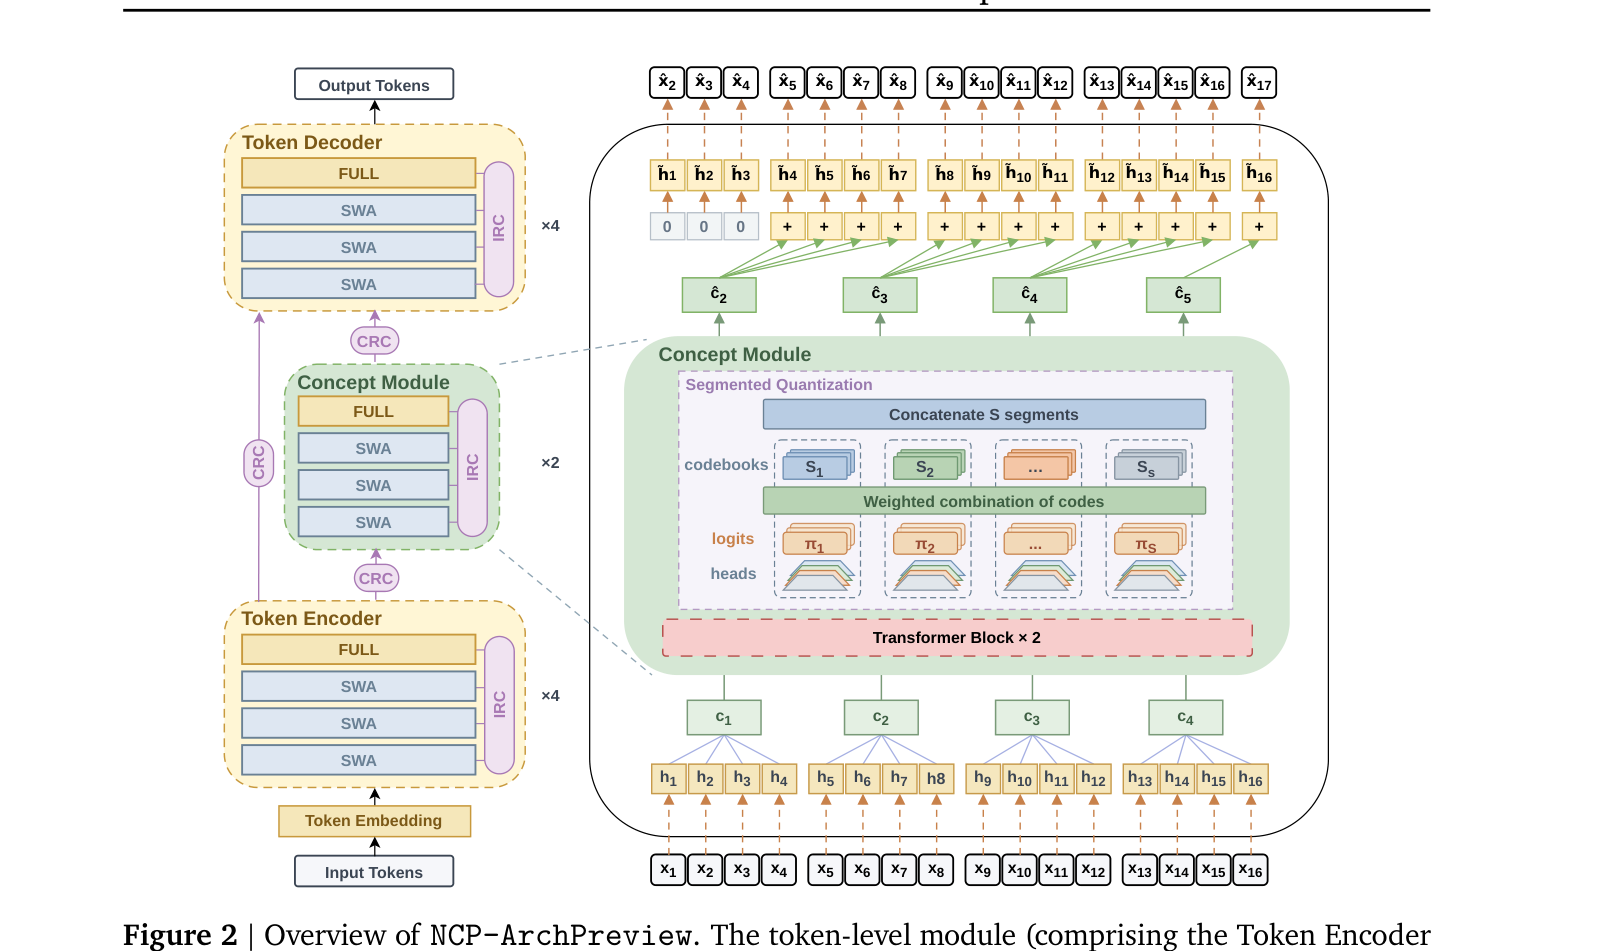
Figure 2 — NCP-ArchPreview의 아키텍처 및 정보 흐름을 보여주는 핵심 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 OLMo-3-7B를 백본으로 하여 8.9B 파라미터 규모의 NCP-ArchPreview를 구축하고 5.73T 토큰으로 학습하였습니다. 제안하는 방법론은 토큰 hidden states를 mean pooling 후 product quantization을 통해 discrete한 concept vocabulary에 매핑하고, 이를 기반으로 Next Concept Prediction을 수행하여 모델의 학습 효율을 극대화합니다. [Table 1]에 따르면, NCP-ArchPreview는 기존 OLMo-3-7B 대비 GSM8K에서 5.99점, 전체 macro-average에서 2.45점의 성능 향상을 보였습니다. 또한, 동일한 사전 학습 손실에 도달하기까지 OLMo-3-7B 대비 51.3%의 토큰만 소비하여 약 1.95배 빠른 수렴 속도를 기록하였습니다. 17M 파라미터의 VQ 모듈만을 업데이트하는 도메인 적응 방식을 통해 효율적인 경량화 적응이 가능하며, speculative decoding 과정에서 Mean Accepted Length(MAL)를 4.17% 향상시키는 성과를 거두었습니다.
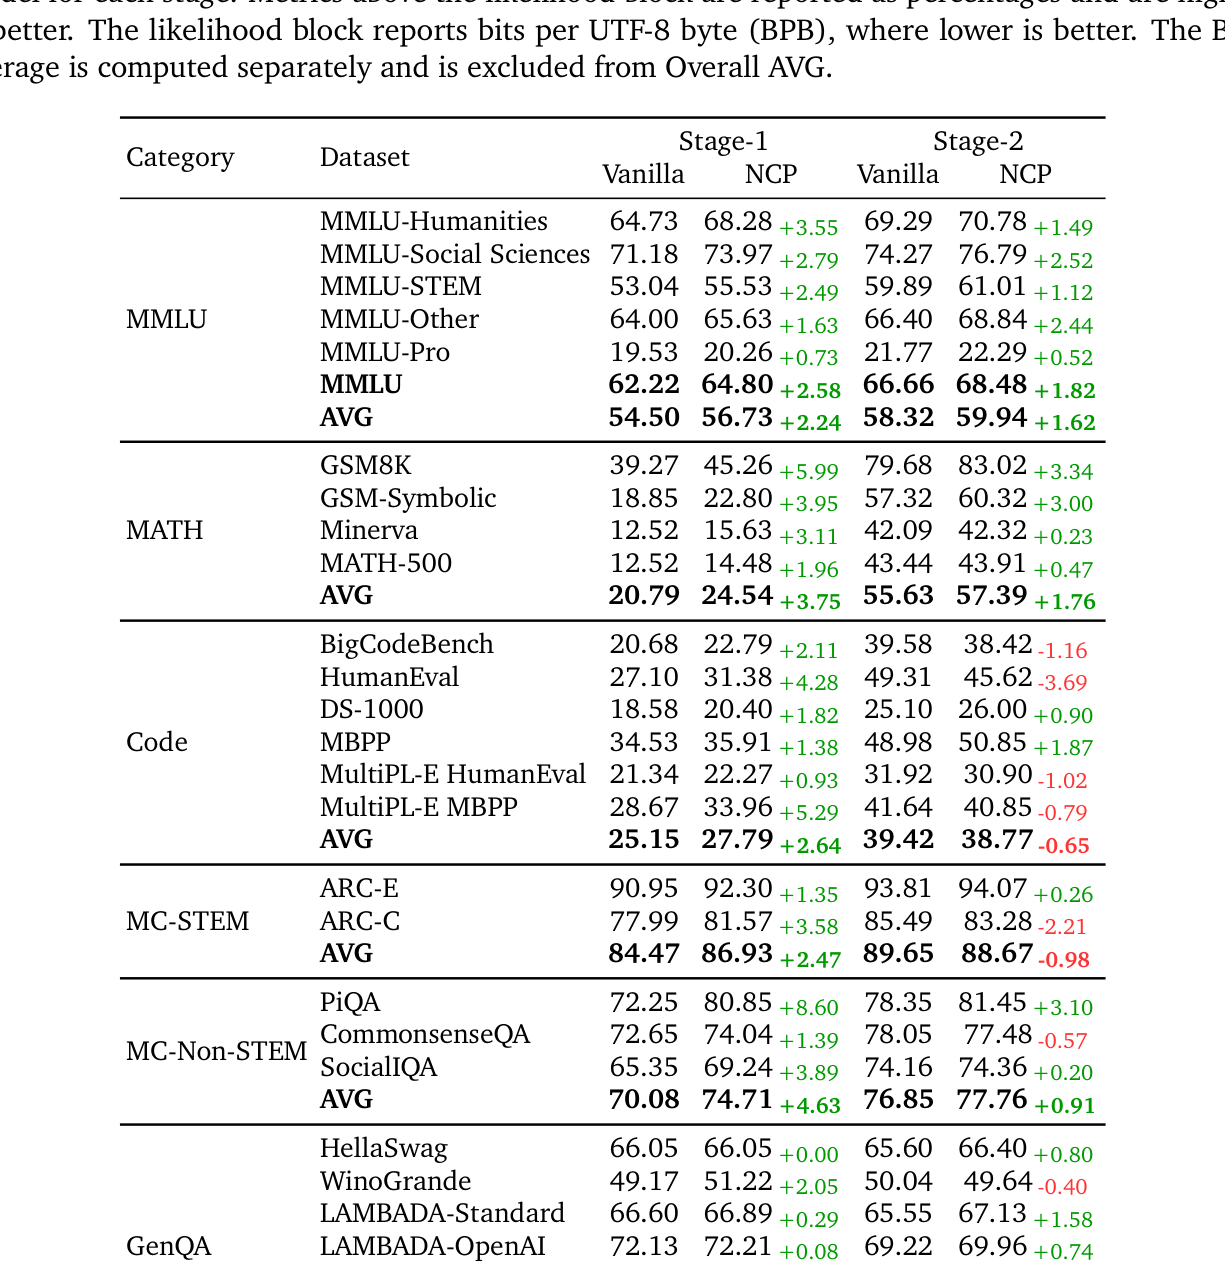
Table 1 — Vanilla 모델 대비 NCP-ArchPreview의 성능 우위를 보여주는 주요 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 latent-space prediction이 단순한 보조 목표가 아닌, 차세대 기초 모델을 위한 확장 가능하고 효율적인 아키텍처임을 입증하였습니다. 제안된 NCP 기반 아키텍처는 모델의 학습 수렴 속도를 획기적으로 개선하고 downstream 벤치마크 성능을 높이는 데 성공했습니다. 이는 언어 모델의 표현 능력을 고차원적 개념 단위로 끌어올림으로써, 파라미터 및 컴퓨팅 리소스 효율성을 동시에 확보할 수 있음을 보여줍니다. 이러한 결과는 향후 더 거대한 문맥과 복잡한 추론 능력을 요구하는 foundation model 연구의 새로운 이정표가 될 것으로 기대됩니다.
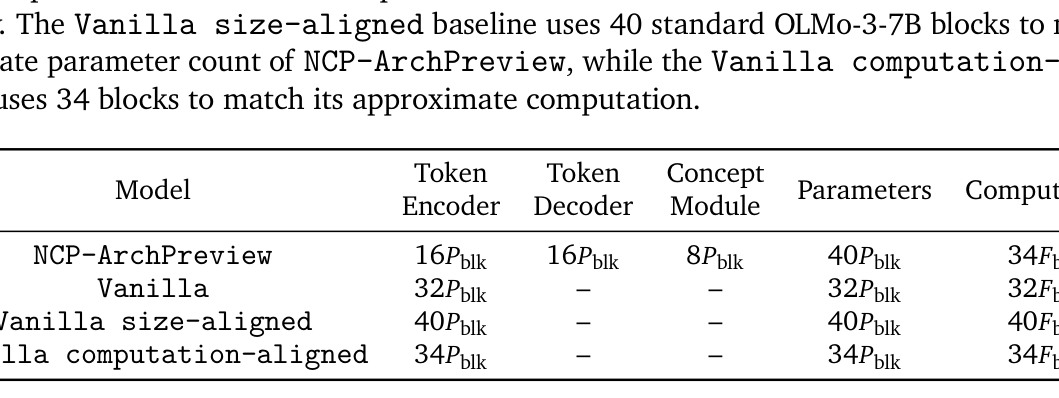
Table 2 — 파라미터 및 연산량 일치를 위한 모델 설계 전략을 설명하는 표
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting
- [논문리뷰] UniMate: One Unified Model to Animate Diverse Skeletons
- [논문리뷰] Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts
- [논문리뷰] V-RAE: Rethinking Video Latent Spaces for Generation
- [논문리뷰] Massive Activations in Hybrid Linear Attention Large Language Models: Pre-Attention Spikes and Inter-Spike Plateaus
Review 의 다른글
- 이전글 [논문리뷰] Mi-Ripple: Restoring Images Degraded by Iterative AI Editing
- 현재글 : [논문리뷰] NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
- 다음글 [논문리뷰] Negative Self-Distillation: Learning to Reason by Avoiding Flaws
댓글