[논문리뷰] Negative Self-Distillation: Learning to Reason by Avoiding Flaws
링크: 논문 PDF로 바로 열기
I have browsed the paper. Now I will extract the information and summarize it according to the specified format and constraints.
Authors: Rongcan Pei, Zhepei Wei, Shuyao Xu, Xinyu Zhu, Wei-Lin Chen, Yu Meng
Keywords: Negative Self-Distillation, LLM Reasoning, Unlikelihood Training, Self-Bootstrapped Learning, Mathematical Reasoning, Adaptive Gating, Reflection
Part 1: 요약 본문
메타데이터
저자: Rongcan Pei, Zhepei Wei, Shuyao Xu, Xinyu Zhu, Wei-Lin Chen, Yu Meng
1. Key Terms & Definitions (핵심 용어 및 정의)
- Negative Self-Distillation (NSD): LLM이 스스로 생성한 "결함 있는 추론(flawed reasoning)" 패턴으로부터 멀어지도록 학습함으로써 추론 능력을 향상시키는 label-free, fully self-bootstrapped 프레임워크입니다.
- On-Policy Self-Distillation (OPSD): 모델이 Ground-truth 해답과 같은 privileged information을 활용하여 자체적으로 teacher 역할을 수행하는 LLM self-improvement 패러다임입니다.
- Gated Unlikelihood (GU) Penalty: NSD의 핵심 구성 요소로, 동적 gating mechanism을 통해 reasoning-critical token을 식별하고, Sigmoid 함수로 unlikelihood penalty를 bounding하여 gradient explosion을 방지하며 모델의 linguistic prior를 보존하는 목적 함수입니다.
- Adaptive Gating Mechanism: Negative teacher와 reference model의 token probability를 비교하여, negative condition에 의해 비정상적으로 likelihood가 증가한 token을 식별하고 penalization을 활성화하는 메커니즘입니다.
- Reflection Tokens: "Wait", "actually", "reconsider" 등 모델이 추론 과정에서 자기 수정(self-correction) 행동을 나타내는 어휘를 지칭합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 On-Policy Self-Distillation (OPSD) 패러다임이 Large Language Models (LLMs)의 복잡한 추론 task 성능을 저하시키는 문제를 해결하고자 Negative Self-Distillation (NSD)를 제안합니다. 기존 OPSD는 Ground-truth solution과 같은 privileged information에 기반하여 인위적으로 confident하고 선형적인 추론 궤적을 모방하도록 학생 모델을 강제합니다. 이로 인해 모델의 탐색적이고 자기 수정적인 행동이 억제되며, 이는 도전적인 문제 해결에 필수적인 요소입니다. 또한, Reinforcement Learning with Verifiable Rewards (RLVR)는 계산 비효율성과 training signal sparsity 문제에 직면하며, dense token-level supervision을 제공하는 On-Policy Distillation (OPD)는 강력한 외부 teacher model에 대한 실용적인 제약이 있습니다. 이러한 배경에서, 저자들은 외부 supervised data나 ground-truth solution 없이, 모델 스스로 결함 있는 추론 패턴을 회피하도록 학습시키는 새로운 접근 방식의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 flawed reasoning을 명시적으로 피하도록 LLM을 최적화하는 Negative Self-Distillation (NSD) 프레임워크를 제안합니다. NSD는 모델 자체를 사용하여 질문별 negative condition을 생성하고, 학생 모델의 분포가 이 self-generated negative teacher로부터 diverge하도록 학습시킵니다. 핵심적으로, NSD는 Negative Condition Prompt Generation, Adaptive Gating Mechanism, 그리고 Gated Unlikelihood (GU) Penalty와 KL-based Regularization을 포함하는 NSD Training Objective로 구성됩니다. Negative condition은 학생 모델의 초기 solution (y_init)을 기반으로 online으로 생성되며, 이는 가장 안정적이고 효과적인 supervision signal을 제공합니다.
Adaptive Gating Mechanism은 reference model (π_ref)과 negative teacher (π_neg) 간의 probability 차이를 비교하여 reasoning error를 나타내는 token (G_t = max(0, π_neg - π_ref))을 식별합니다. 이 게이트 값은 penalization의 강도를 조절하여, 일반적인 linguistic token의 degradation을 방지합니다. 이어서, Sigmoid-bounded unlikelihood penalty (ℒ_GU = G_t * (1 / (2 - π_θ)))는 high-probability token에 대한 gradient explosion을 방지하고, low-to-mid confidence token에 가장 강한 unlearning signal을 할당합니다. 최종 NSD Loss는 ℒ_NSD = ℒ_GU + α⋅ℒ_KL로 구성되며, 여기서 ℒ_KL은 student model의 linguistic priors를 보존하는 regularization 역할을 합니다.
실험 결과, NSD는 다양한 모델 크기(1.7B, 4B, 8B)와 7가지 수학적 추론 벤치마크(AIME 24/25/26, HMMT, AMC, OlympiadBench, MATH)에서 기존 OPSD, Intuitor, TTRL과 같은 baselines 대비 일관되게 우수한 성능을 달성했습니다. 특히, 1.7B, 4B, 8B 모델에서 평균적으로 각각 2.3%, 7.5%, 6.0%의 Delta Avg@8 성능 향상을 보였습니다. 더 큰 모델에서 self-generated negative condition의 품질 향상 덕분에 NSD의 성능 이득이 더욱 두드러졌습니다. 또한, NSD는 OPSD 및 Intuitor와 달리 모델의 Reflection Token Frequency를 대폭 향상시켜(Qwen3-4B에서 평균 7.5회/응답), 과도한 자신감을 방지하고 탐색적 자기 수정 행동을 보존함을 입증했습니다. [Figure 1]은 NSD 프레임워크의 개요를, [Figure 2]는 Negative Self-Distillation의 전반적인 프로세스를 보여줍니다. [Table 1]은 수학적 추론 벤치마크에서의 주요 평가 결과를 요약하고 있습니다.
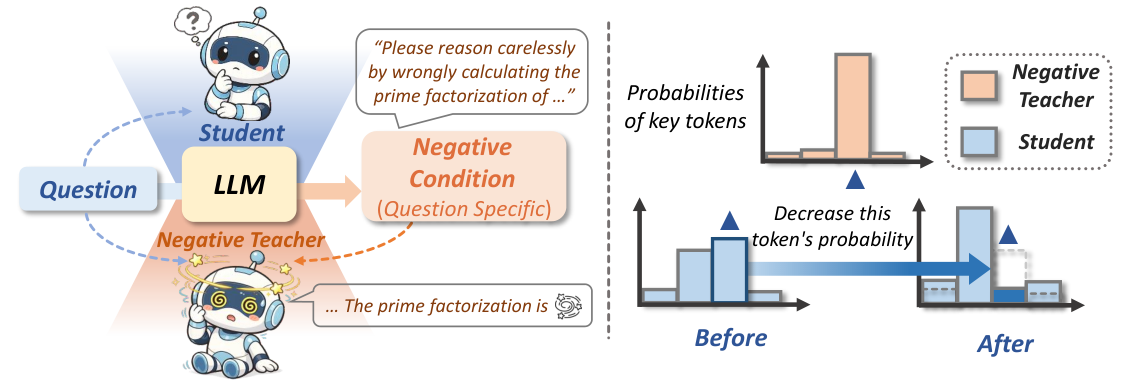
Figure 1 — NSD 프레임워크 개요
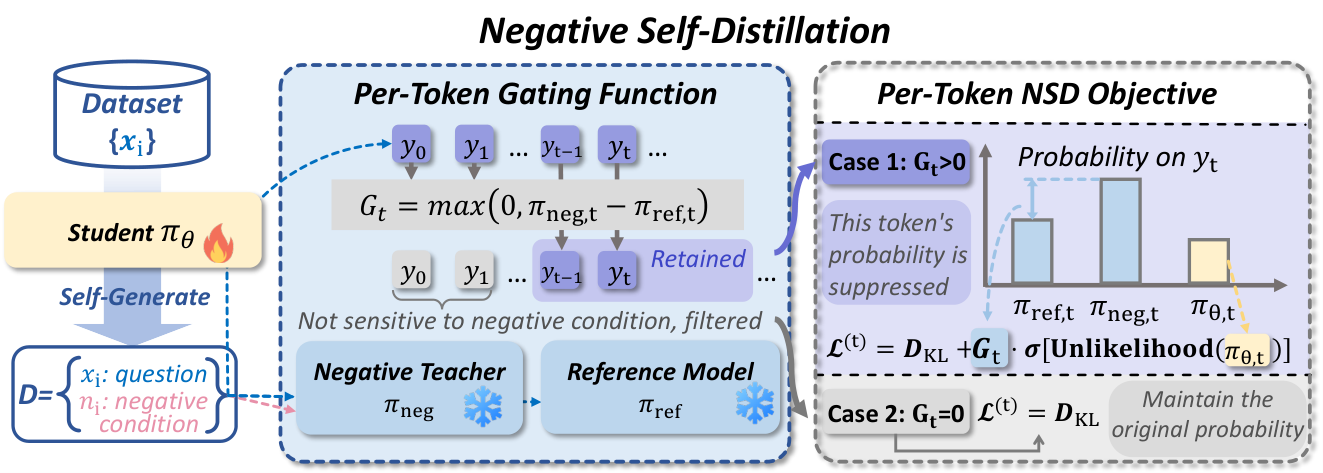
Figure 2 — NSD 프로세스 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 negative conditioning과 gated unlikelihood training을 결합한 label-free 학습 프레임워크인 Negative Self-Distillation (NSD)를 제안합니다. NSD는 LLM이 스스로 생성한 flawed reasoning 패턴을 회피하도록 학습함으로써 추론 능력을 효과적으로 향상시킵니다. 실험적으로 NSD는 다양한 모델 규모와 수학적 추론 벤치마크에서 기존 baselines 대비 지속적으로 우수한 성능을 입증했습니다. 특히, adaptive gating mechanism은 genuine한 reasoning flaw token을 효과적으로 분리하고, sigmoid unlikelihood objective는 안정적인 gradient update를 보장하며, model의 linguistic priors를 보존합니다. 이 연구는 LLM의 post-training method로서 중요한 시사점을 가지며, 특히 ground-truth solution이나 외부 supervision 없이 모델 스스로 학습하여 복잡한 추론 task에서 성능을 극대화할 수 있는 잠재력을 제시합니다. 또한, NSD는 model의 self-reflection 능력을 강화하여 과도한 자신감을 방지하고 탐색적 추론 행동을 촉진함으로써, 더욱 robust하고 지능적인 LLM 개발에 기여할 것으로 기대됩니다.
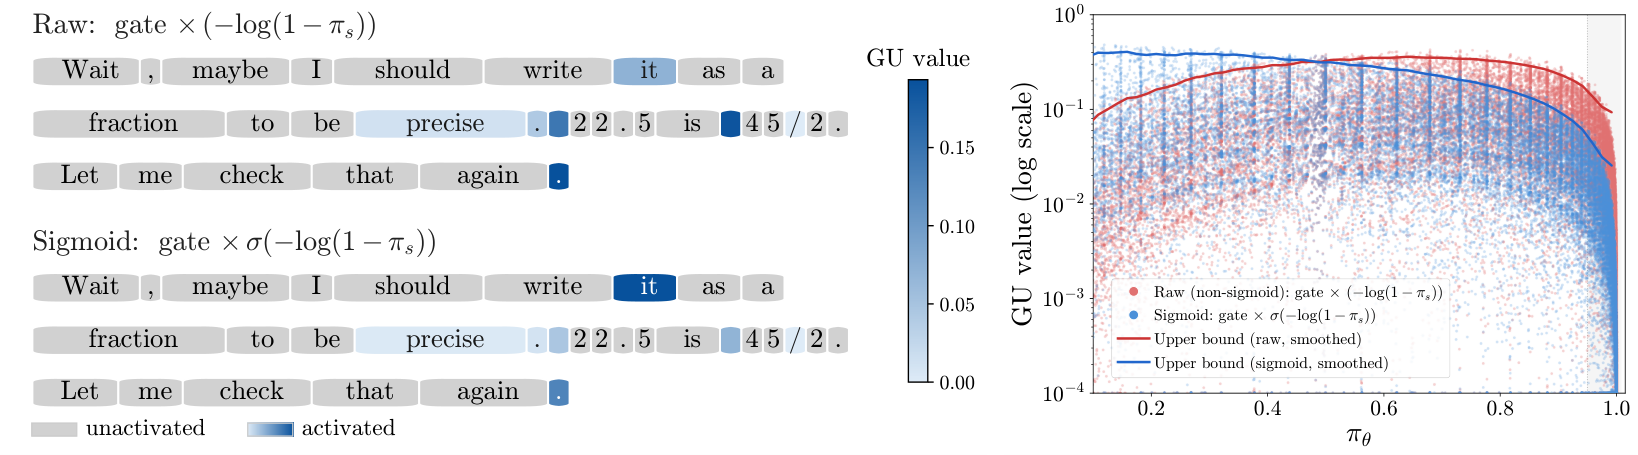
Figure 3 — Gated Unlikelihood(GU) 페널티 분석
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Pushing the Boundaries of Natural Reasoning: Interleaved Bonus from Formal-Logic Verification
- [논문리뷰] SCALE: Selective Resource Allocation for Overcoming Performance Bottlenecks in Mathematical Test-time Scaling
- [논문리뷰] First Try Matters: Revisiting the Role of Reflection in Reasoning Models
- [논문리뷰] Revisiting the Uniform Information Density Hypothesis in LLM Reasoning Traces
- [논문리뷰] SHAPE of Chain-of-Thought in Math Reasoning
Review 의 다른글
- 이전글 [논문리뷰] NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
- 현재글 : [논문리뷰] Negative Self-Distillation: Learning to Reason by Avoiding Flaws
- 다음글 [논문리뷰] Recursive Code World Models: Building Complex Worlds through Recursive Scene Programs
댓글