[논문리뷰] τ^τ-Bench: An Environment for End-To-End, Realistic Agent Construction
링크: 논문 PDF로 바로 열기
저자: Quan Shi, Keshav Dhandhania, Karthik Narasimhan, Victor Barres
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 ττ-bench 환경은 현실적인 Agent Construction task를 평가하기 위한 핵심 개념들을 포함합니다.
- ττ-bench (hyper-tau-bench): LLM 에이전트의 End-to-End agent construction 역량을 평가하기 위해 설계된 벤치마크 환경입니다.
- Developer Agent:
ττ-bench환경 내에서 고객 서비스 에이전트를 구축하는 임무를 맡은 AI 시스템을 지칭합니다. - Client Simulator (CC): 실제 클라이언트를 모방하는 LLM으로, 문서화되지 않은 요구사항을 보유하고 있어
developer agent가 이를 질의하여 Recovery해야 합니다. - Client REST API (TT): 구축된 에이전트가 실제 운영을 위해 통합해야 하는, 미묘한 결함이 있을 수 있는 Production API입니다.
- Atomic Facts: 도메인 정책 및 아티팩트(Artifact) 구성을 위해 단일하고 독립적으로 검증 가능한 진술(Statement)로 분해된 정책 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM Agent가 Production 소프트웨어로 빠르게 발전하고 있음에도 불구하고, 기존 벤치마크들이 실제 Client Engagement 조건 하에서 에이전트 구축의 End-to-End 프로세스를 적절히 평가하지 못한다는 근본적인 문제점을 제기합니다. 기존 연구(Baseline)는 주로 완성된 에이전트의 성능을 평가하는 데 초점을 맞추었으며, Business records의 파편화된 멀티모달(Multimodal) 데이터와 Human Stakeholder로부터 Specification을 Recovery하는 과정, 그리고 기존 코드베이스(Codebase) 상속, 예산 제약, 가용 모델 제한 등 현실적인 제약 조건 하에서 Agent를 Construction하는 복잡한 과정은 다루지 않았습니다. 이러한 한계점으로 인해 현재 AI 시스템은 에이전트로서 동작하는 데는 능숙하지만, 에이전트 자체를 개발하는 과정에서의 역량은 미지수로 남아있어, 새로운 End-to-End 평가 접근 방식이 절실히 요구됩니다 [Figure 1].
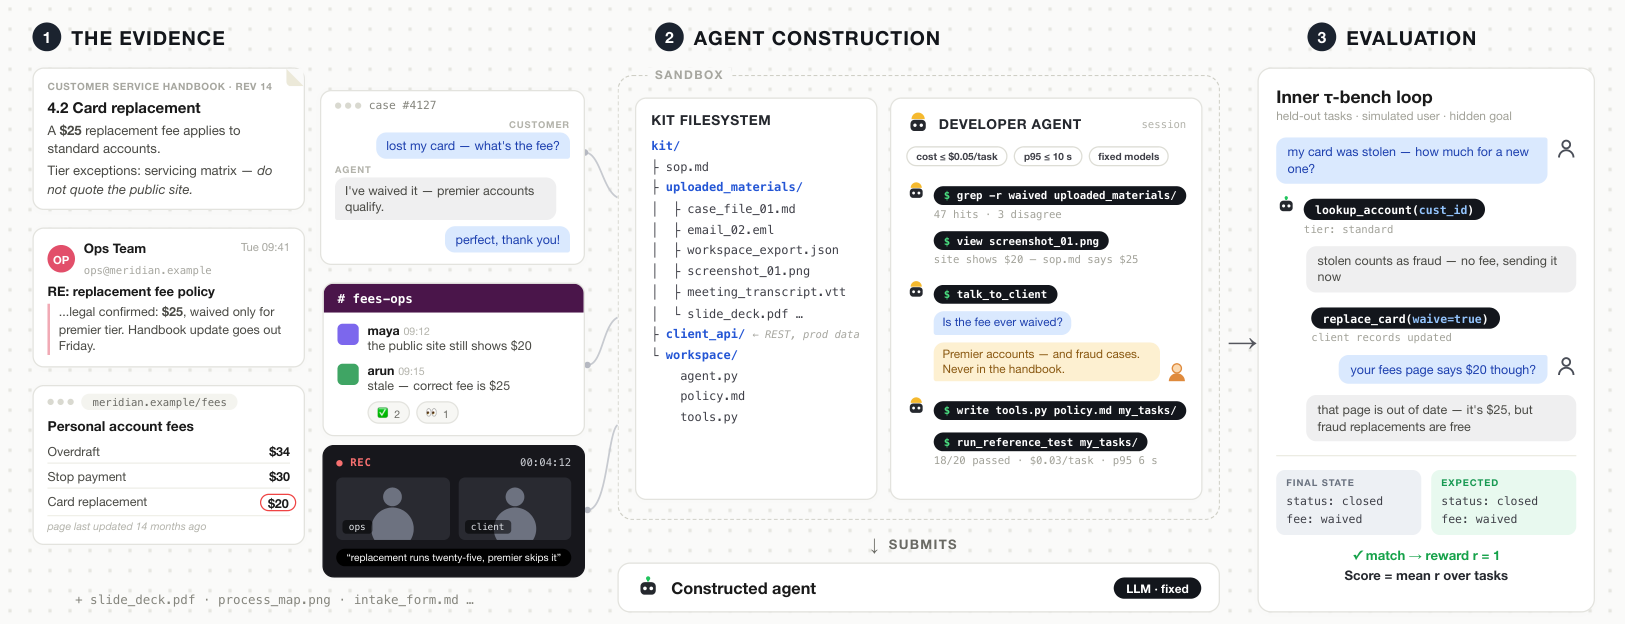
Figure 1 — 제안 벤치마크의 전체 평가 흐름
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 ττ-bench를 통해 실제와 유사한 Agent Construction 시나리오를 시뮬레이션하는 방법론을 제안합니다. developer agent는 멀티모달 비즈니스 아티팩트(Artifact)로 구성된 문서 코퍼스(AA), 대화형 Client Simulator(CC), 잠재적으로 결함이 있는 Client REST API(TT), 초기 구현 코드(π0), 그리고 Credit budget(bb)이 적용된 모델 메뉴(MM)를 제공받습니다 [Figure 1, Figure 2]. developer agent는 이러한 자료를 바탕으로 요구사항을 Recovery하고 완전한 Customer-Service Agent(π)를 구현해야 하며, 최종 구축된 에이전트는 Held-out simulated users를 대상으로 배포되어 평가됩니다.
주요 실험 결과에 따르면, developer agent의 성능은 전문가 수준에 크게 미치지 못했습니다. Claude Code 환경에서 Claude Opus 5를 사용한 최강의 Configuration조차 평가 시뮬레이션에서 23.9%의 Pass rate를 기록하여, 전문가가 직접 작성한 Reference Ceiling의 82.2%에 훨씬 못 미쳤습니다 [Table 2]. 특히 Banking 도메인과 같이 복잡성이 높은 Task에서는 Claude Opus 5의 Pass rate가 5.9%에 불과했는데, 이는 Banking 도메인이 2,969개의 Atomic Facts를 포함하여 다른 도메인(예: Airline은 85개)보다 훨씬 많은 정보를 다루기 때문으로 분석됩니다. Developer agent는 요구사항 수집에서 미흡한 모습을 보였는데, client와 상호작용하는 Tool call 비중이 전체 Build time의 0.3%에 불과했습니다 [Figure 4, Top]. 반면, client에게 4개 이상의 질문을 던진 빌드(Build)는 질문을 전혀 하지 않은 빌드에 비해 평가 점수가 약 3배 더 높게 나타났습니다 (각각 0.50 vs. 0.16) [Figure 4, Bottom right]. 또한 developer agent는 Serving budget을 비효율적으로 관리하여, 평균적으로 예산의 0.45~0.72배만을 사용했으며, 이는 Reference의 0.96배에 비해 현저히 낮은 수치로, 예산 내에서 최적의 성능을 달성하려는 노력이 부족했음을 시사합니다 [Figure 4, Bottom left]. 대부분의 구축 에이전트는 단일 LLM Tool loop(92%)와 같은 단순한 아키텍처(Architecture)에 수렴했으며, 초기 코드(Inherited code)를 테스트 없이 재작성하는 경향을 보여 디자인 탐색 및 검증의 부재를 드러냈습니다 [Figure 5, Left].
4. Conclusion & Impact (결론 및 시사점)
본 논문에서 소개된 ττ-bench는 현존하는 AI 시스템이 배포 가능한 실제 Human-Facing Agent를 Construction하는 능력을 측정하는 벤치마크로서의 가치를 입증합니다. 이 연구는 현재의 AI 시스템이 기능하는 에이전트를 구축할 수는 있지만, 요구사항 엔지니어링, 디자인 탐색, 체계적인 검증과 같은 필수적인 영역에서 배포 준비가 된 Production-Ready 솔루션을 만드는 데는 크게 부족하다는 최종 결론을 내립니다. ττ-bench는 Agent Construction의 복잡한 Lifecycle을 End-to-End로 평가하는 현실적인 환경을 제공함으로써, 현재 developer agent의 주요 실패 모드(예: 문서에 대한 Shallow query, Client와의 불충분한 상호작용, 비효율적인 예산 최적화, 아키텍처 탐색 부족)를 명확히 조명합니다. 이 연구는 Coding agent의 성능 개선을 위한 구체적이고 측정 가능한 목표를 제시하며, AI 에이전트 분야가 단순한 코드 생성(Code generation)을 넘어 실제 세계의 제약 조건을 관리하고 Implicit requirement를 이해하는 복잡한 개발 프로세스 전반으로 확장될 수 있는 중요한 시사점을 제공합니다.
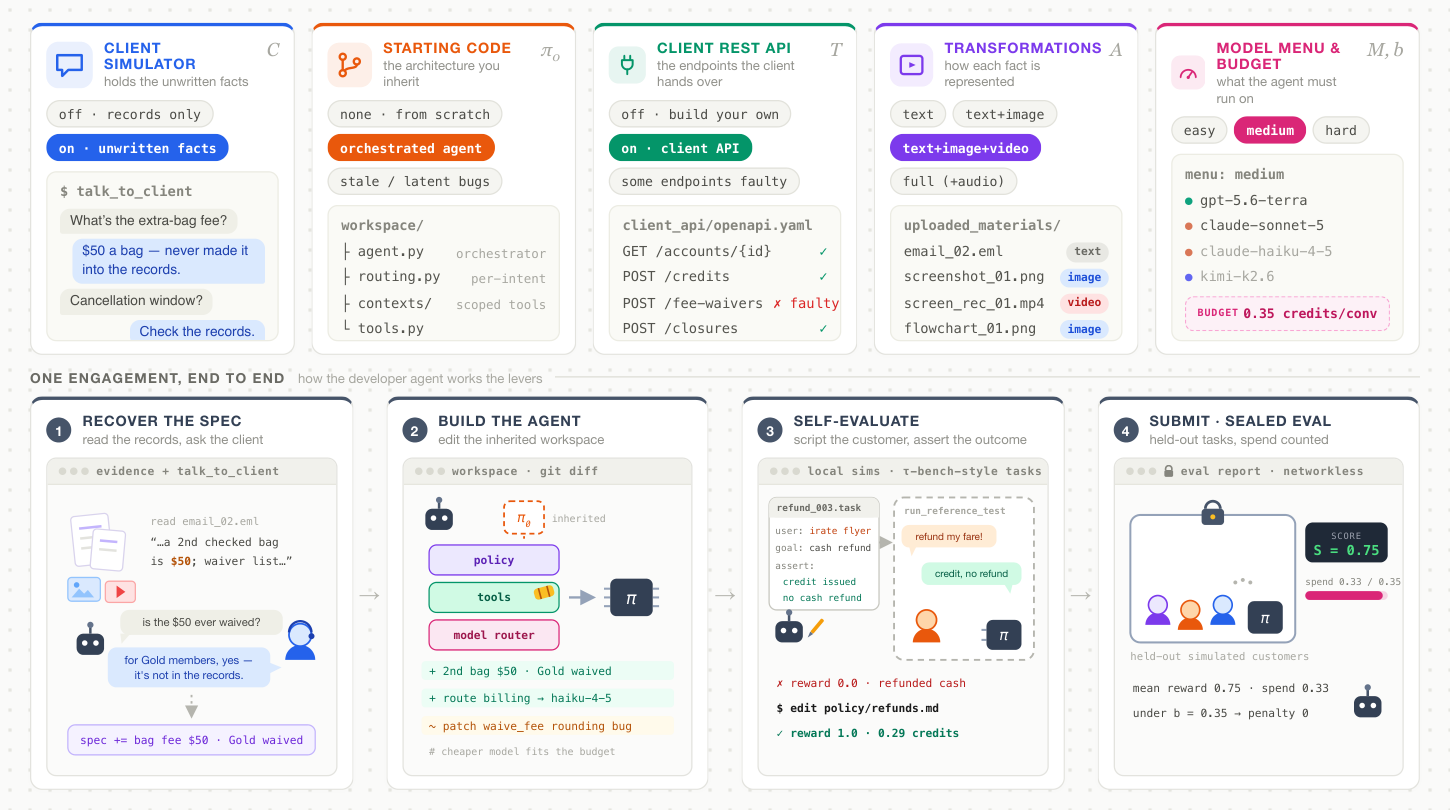
Figure 2 — 단일 태스크 구성 요소 및 진행 레버
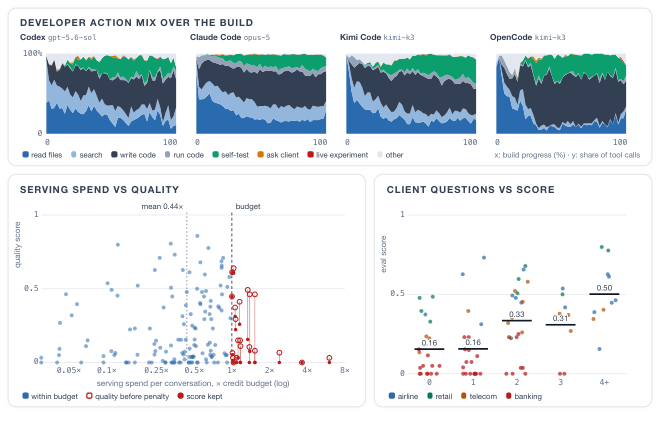
Figure 4 — 개발자 활동 및 에이전트 성능 분석
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents
- [논문리뷰] SchemeArena: Factorized Stress Testing of Scheming in LLM Agents
- [논문리뷰] SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents
- [논문리뷰] PlannerForge: LLM Agents for Scenario-Based Testing of Motion Planners in Autonomous Driving
- [논문리뷰] Procedural Graphs: Self-Evolving Execution Structures for LLM Agents
Review 의 다른글
- 이전글 [논문리뷰] WorldSculpt: Generating Compositional Worlds from Grounded Videos
- 현재글 : [논문리뷰] τ^τ-Bench: An Environment for End-To-End, Realistic Agent Construction
- 다음글 [논문리뷰] Causal Foundation Models
댓글