[논문리뷰] WorldSculpt: Generating Compositional Worlds from Grounded Videos
링크: 논문 PDF로 바로 열기
메타데이터
저자: Muyao Niu, Jixuan He, Ruihan Yu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Compositional World: 개별 객체가 독립적인 Mesh로 표현되어 편집, 이동 및 시뮬레이션이 가능한 3D 장면 환경을 의미합니다.
- Anchor-aligned Canonicalization: 다양한 입력 뷰(view)에서 관찰된 객체를 표준화된 3D 정규 공간(Canonical Frame)으로 매핑하여 일관된 생성을 가능하게 하는 기법입니다.
- Multi-view Conditioning: 단일 이미지 기반의 생성 모델을 확장하여, 여러 시점의 입력 데이터를 결합하고 이를 통해 객체의 가려진 영역(Occlusion)을 추론하는 프레임워크입니다.
- UE-MeshyScene: 복잡한 폐쇄(Occlusion) 환경에서 수백 개의 객체가 포함된 사진 같은 3D 장면을 평가하기 위해 저자들이 제안한 대규모 벤치마크 데이터셋입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 복잡하고 폐쇄가 심한 장면(Cluttered Scene)에서 수백 개의 개별 객체를 독립적인 Mesh 형태로 구성하는 문제에 집중합니다. 기존 연구들은 장면 전체를 단일 표현(Unified representation)으로 재구성하여 개별 객체의 조작이 어렵거나, 생성적 사전 지식(Generative prior)을 활용한 기법들이 단순한 장면 위주로 설계되어 확장성에 한계가 있었습니다 [Figure 1]. 따라서 저자들은 강한 단일 객체 생성 모델을 활용하면서도, 다중 뷰의 시각적 증거를 통합하여 대규모 복잡 장면을 생성할 수 있는 새로운 접근 방식을 제안합니다.
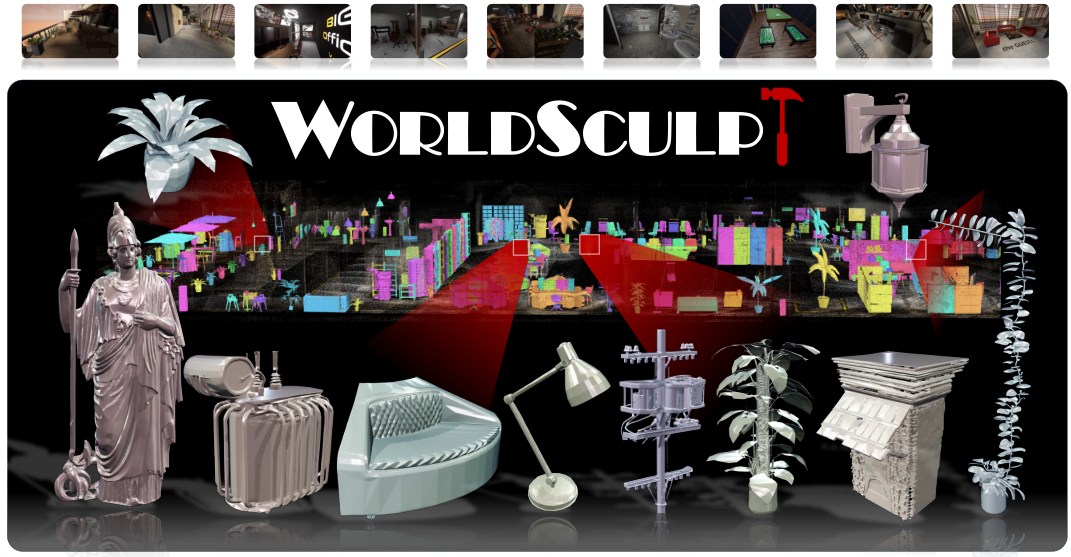
Figure 1 — WorldSculpt 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 강력한 단일 객체 생성 모델인 Pixal3D를 멀티 뷰 조건부 생성으로 확장한 WorldSculpt 프레임워크를 제안합니다 [Figure 2]. WorldSculpt는 각 객체의 뷰를 앵커(Anchor) 기반의 정규 공간으로 투영한 뒤, DINOv3 feature를 사용하여 이를 3D 공간에 리프팅(Lifting)합니다. 다양한 뷰에서 추출된 정보는 치환 불변(Permutation-invariant) aggregator를 통해 융합되며, LoRA 기반의 적응형 파라미터를 사용하여 Frozen된 사전 모델에 정보를 주입합니다 [Figure 2]. 정량적 결과로서, Toys4k-Scene 및 HouseCat6D 데이터셋과 새롭게 구축한 UE-MeshyScene에서 기존 기법들을 일관되게 상회하는 성능을 보였습니다 [Figure 3]. 특히 객체 간 폐쇄(Occlusion)가 심화될수록 본 방법론의 생성 품질 유지 능력이 타 모델 대비 우수함을 입증하였습니다.
Figure 2 — WorldSculpt 전체 아키텍처
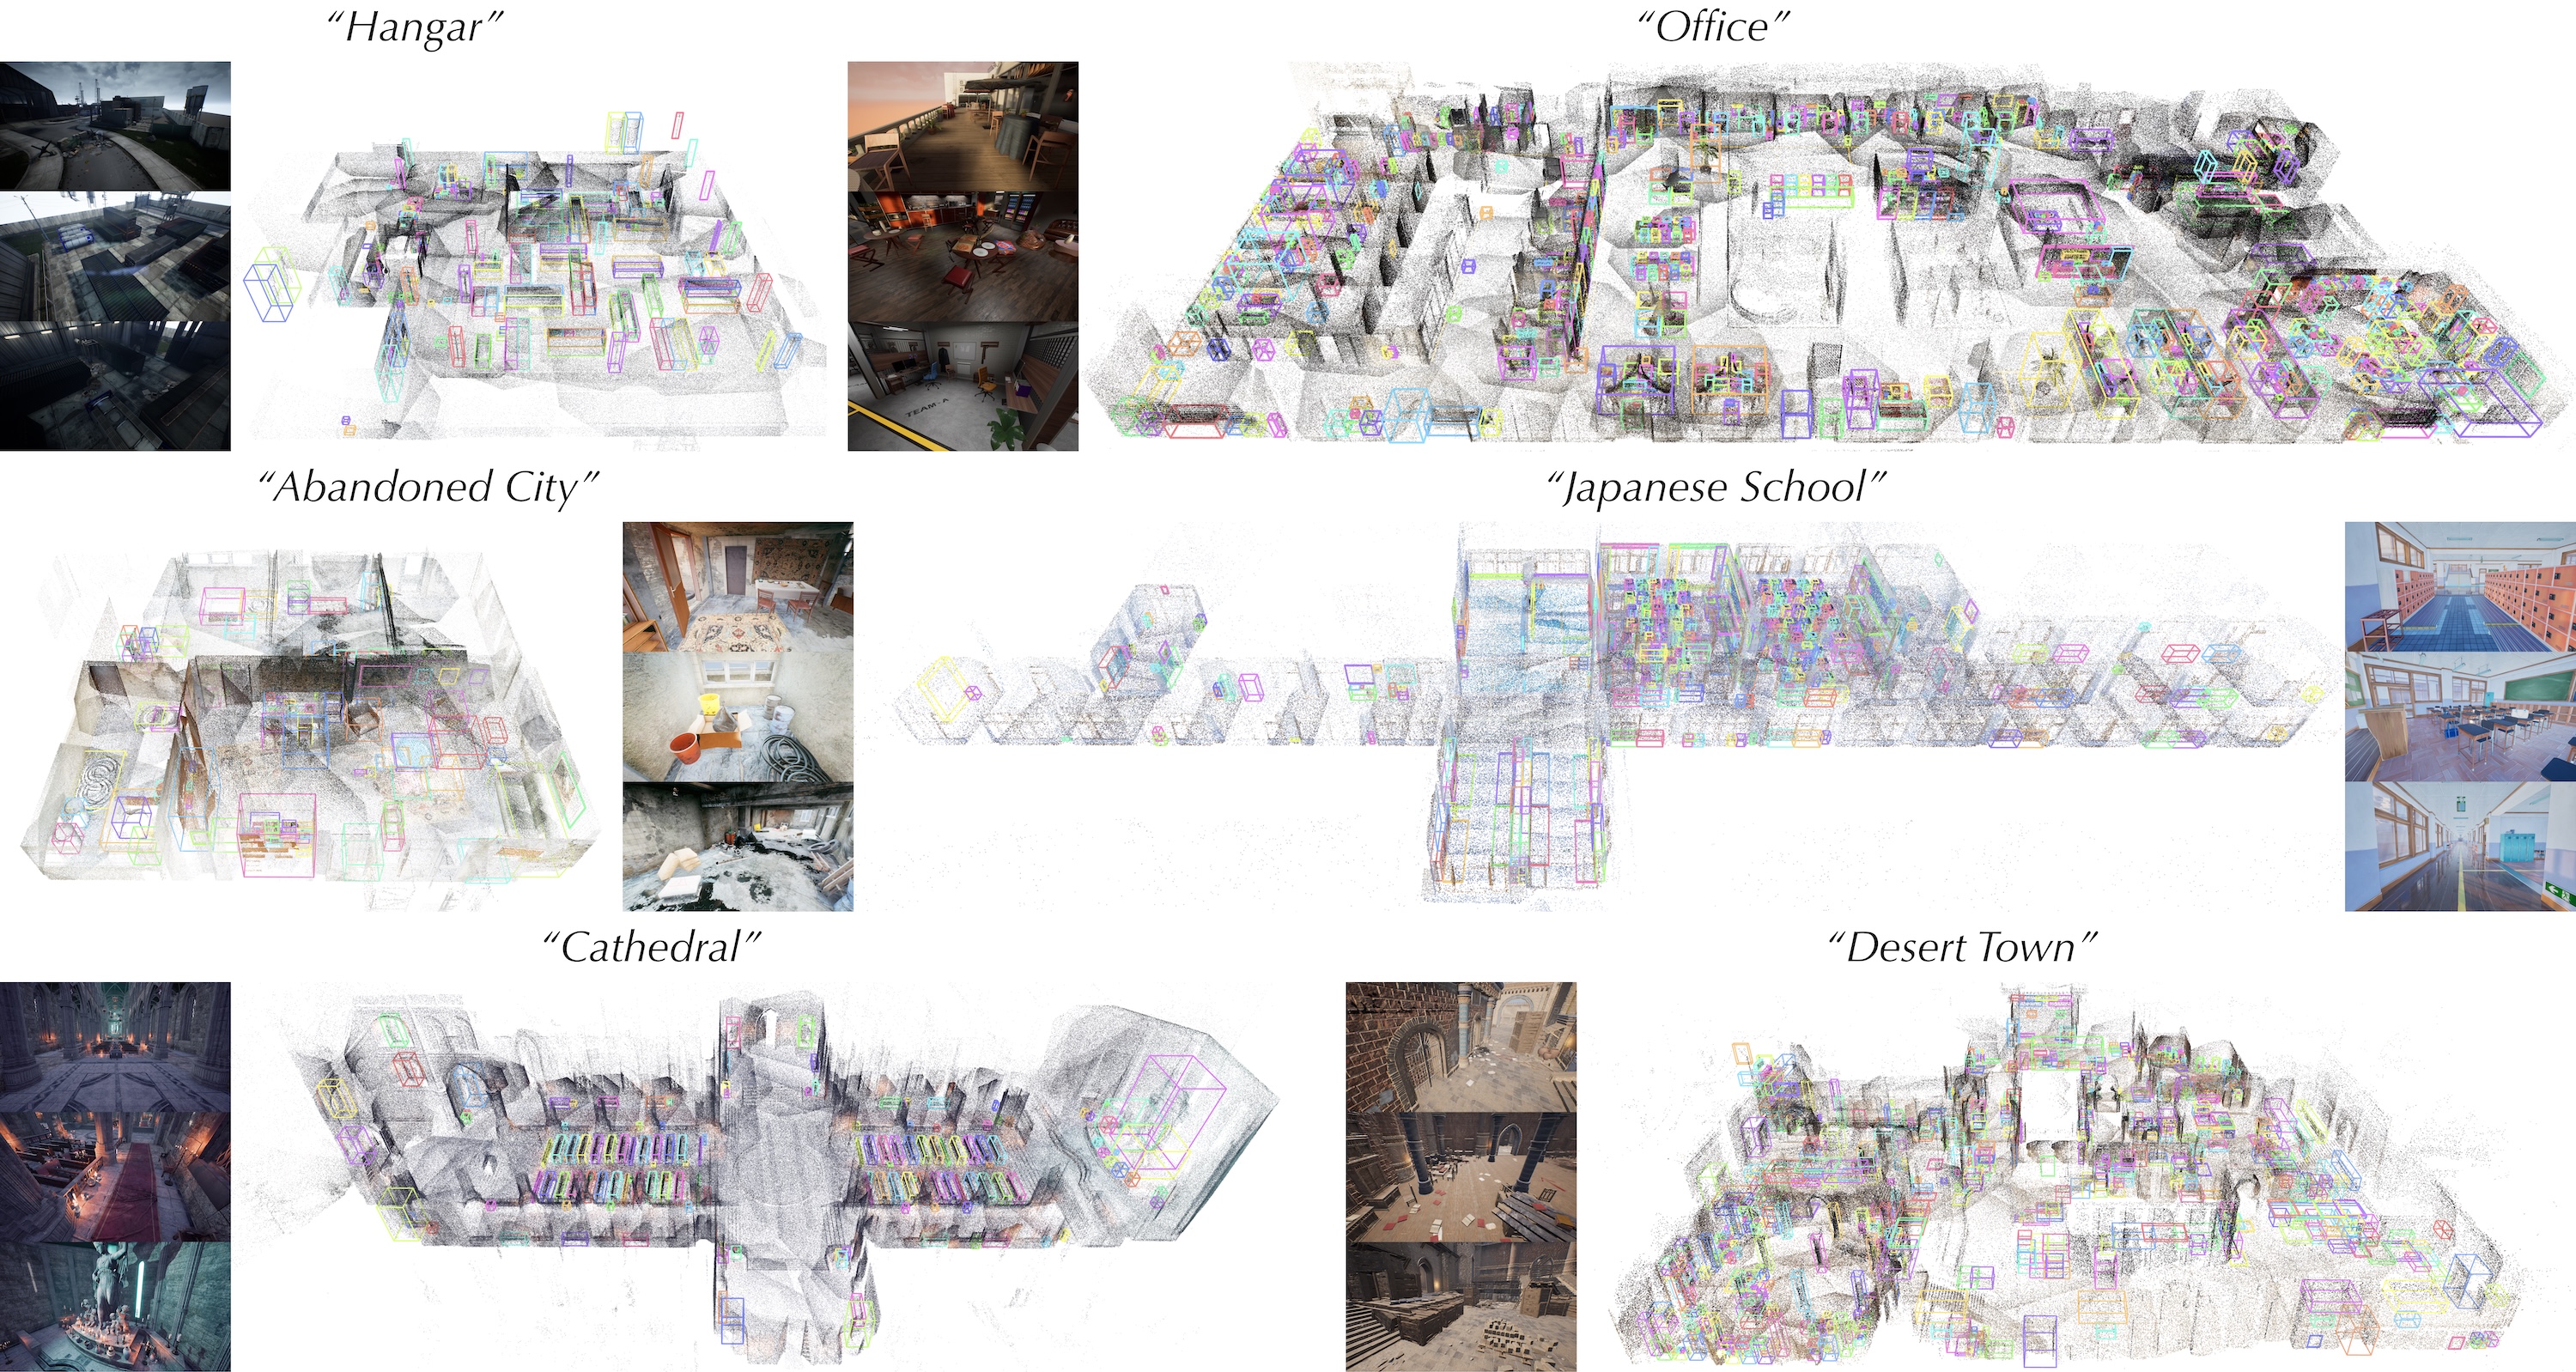
Figure 3 — UE-MeshyScene 예시
4. Conclusion & Impact (결론 및 시사점)
본 연구는 단일 객체 수준으로 훈련된 생성적 사전 모델이 장면 단위의 별도 훈련 없이도 대규모 복잡 장면으로 일반화될 수 있음을 증명하였습니다. WorldSculpt는 장면을 구성 요소로 분해함으로써 AR/VR, 게임, 로보틱스 시뮬레이션 등 실용적인 응용 분야에 직접적으로 기여할 수 있는 기반을 마련했습니다. 또한, 고품질 벤치마크인 UE-MeshyScene은 향후 복잡한 실세계 환경에서의 3D 생성 연구를 촉진할 중요한 자산이 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MegaParts: Scaling Part-Aware 3D Object Generation to 300 Parts via Token-Efficient Autoregressive Modeling
- [논문리뷰] Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and Editing
- [논문리뷰] DiffGI: Differentiable Geometry Images for High-Fidelity Thin-Shell 3D Generation
- [논문리뷰] Hallo4D: Multi-Modal Hallucination Mitigation for Consistent Spatio-Temporal Generation
- [논문리뷰] BRDFusion: Physics Meets Generation for Urban Scene Inverse Rendering
Review 의 다른글
- 이전글 [논문리뷰] When Quantization Breaks Memory: Recurrent-State Write-Back in Low-Precision Temporal Inference
- 현재글 : [논문리뷰] WorldSculpt: Generating Compositional Worlds from Grounded Videos
- 다음글 [논문리뷰] τ^τ-Bench: An Environment for End-To-End, Realistic Agent Construction
댓글