[논문리뷰] CoVeR: Coverage-Based Token Pruning for Multi-View 3D Reasoning in VLMs
링크: 논문 PDF로 바로 열기
메타데이터
저자: Nhat-Tan Bui, Varshini Elangovan, Arun Reddy Anugu, Sreyas Mohan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLM (Vision-Language Model): 2D 이미지-텍스트 데이터를 기반으로 사전 학습되어, Multi-View 입력을 통해 3D 공간을 추론하는 모델 프레임워크입니다.
- Token Pruning: LLM의 연산 비용과 Latency를 줄이기 위해 중요도가 낮은 시각적 토큰을 제거하는 기법으로, 본 논문에서는 3D 공간의 기하학적 커버리지(Coverage)를 극대화하는 것을 목표로 합니다.
- Deterministic Selection: 학습된 가중치(Attention 또는 Feature)에 의존하지 않고, 오직 3D 좌표 정보만을 사용하여 토큰을 선택하는 기법입니다.
- Directed Hausdorff Distance: 전체 3D 장면의 토큰 셋($X$)과 선택된 토큰 셋($\mathcal{C}$) 간의 거리로, 가장 잘 표현되지 않은 영역의 표현 수준을 정량화합니다 [Equation 1].
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Multi-View 3D 추론은 많은 양의 시각적 토큰을 생성하여 LLM의 연산 비용을 급격히 증가시키는 병목 현상을 유발합니다. 기존의 Learned Importance 방식은 3D 공간 내의 중복된 토큰을 제대로 제거하지 못하고 특정 영역에만 편중된 결과를 보이며, Voxelization 기반 방식은 장면별 정확한 토큰 수 제어가 불가능하고 토큰 포화(Saturation) 현상이 발생하는 한계가 있습니다 [Figure 2]. 이러한 기존 연구들은 3D 공간의 기하학적 커버리지를 보장하지 못하며, 이는 결과적으로 3D 추론 성능의 저하로 이어집니다. 따라서 본 논문은 학습 과정이 필요 없는 CoVeR를 제안하여 엄격한 Budget 하에서도 기하학적으로 최적화된 토큰 선택을 가능하게 합니다.
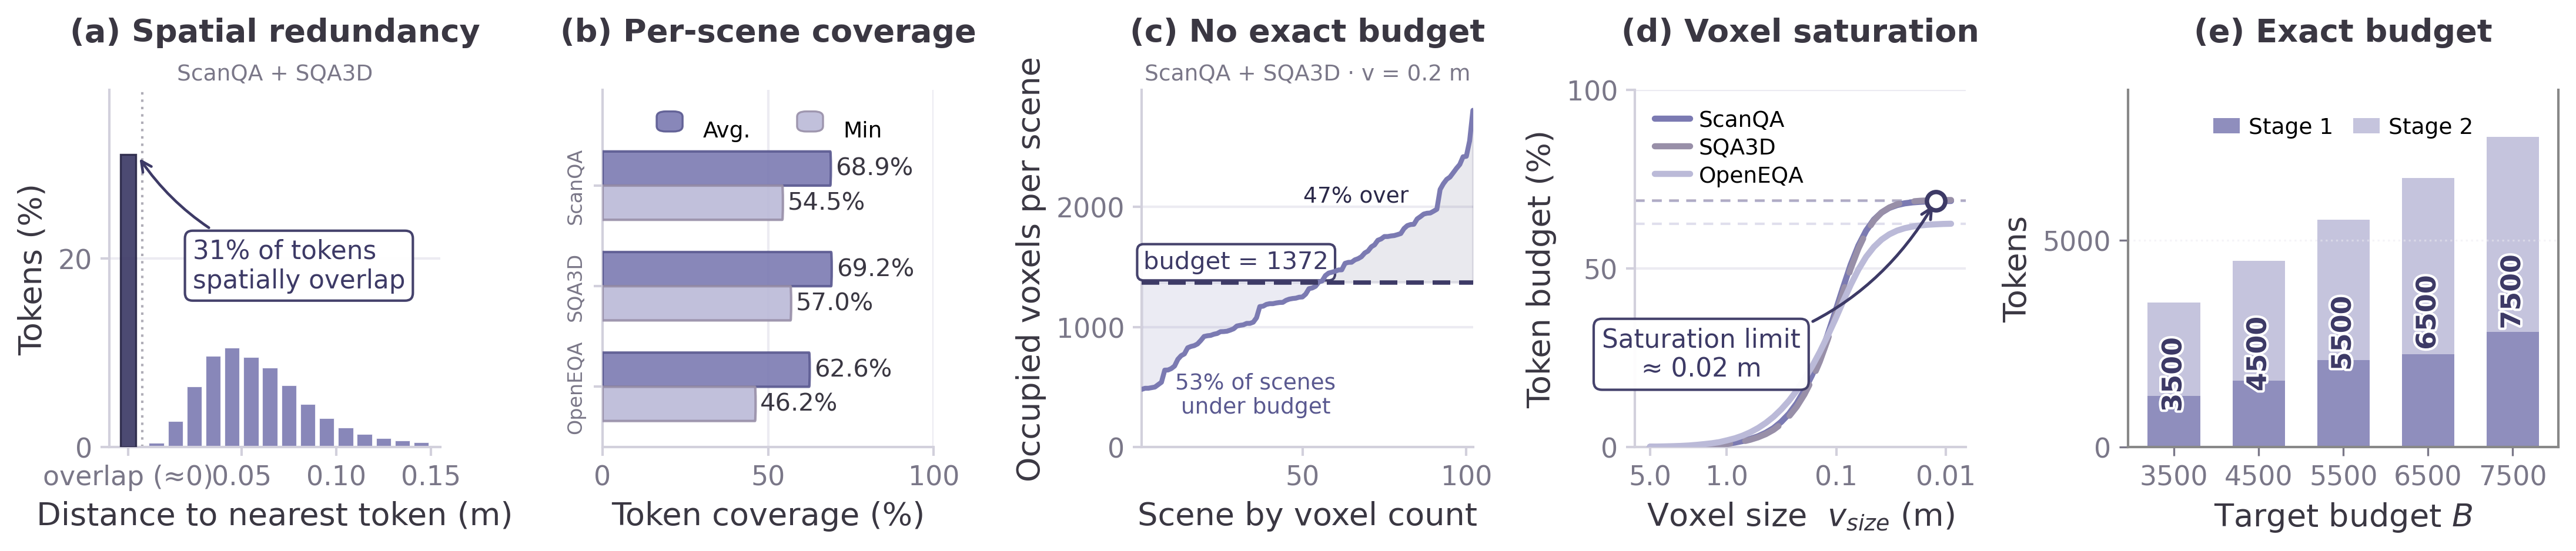
Figure 2 — 기존 방식의 한계 분석
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문이 제안하는 CoVeR는 Coverage Initialization과 Coverage Expansion이라는 두 단계의 기하학적 선택 프로세스로 구성됩니다 [Figure 1]. 먼저, Initialization 단계에서는 이진 탐색(Binary Search) 기반 휴리스틱을 통해 장면별 최적 Voxel 크기를 찾아 중복 토큰을 제거하고 초기 커버리지를 확보합니다. 이어서 Expansion 단계에서는 FPS(Farthest Point Sampling) 알고리즘을 사용하여 기하학적 거리 기준으로 가장 먼 토큰들을 추가함으로써 전체 Budget을 정확히 맞춥니다 [Algorithm 1].
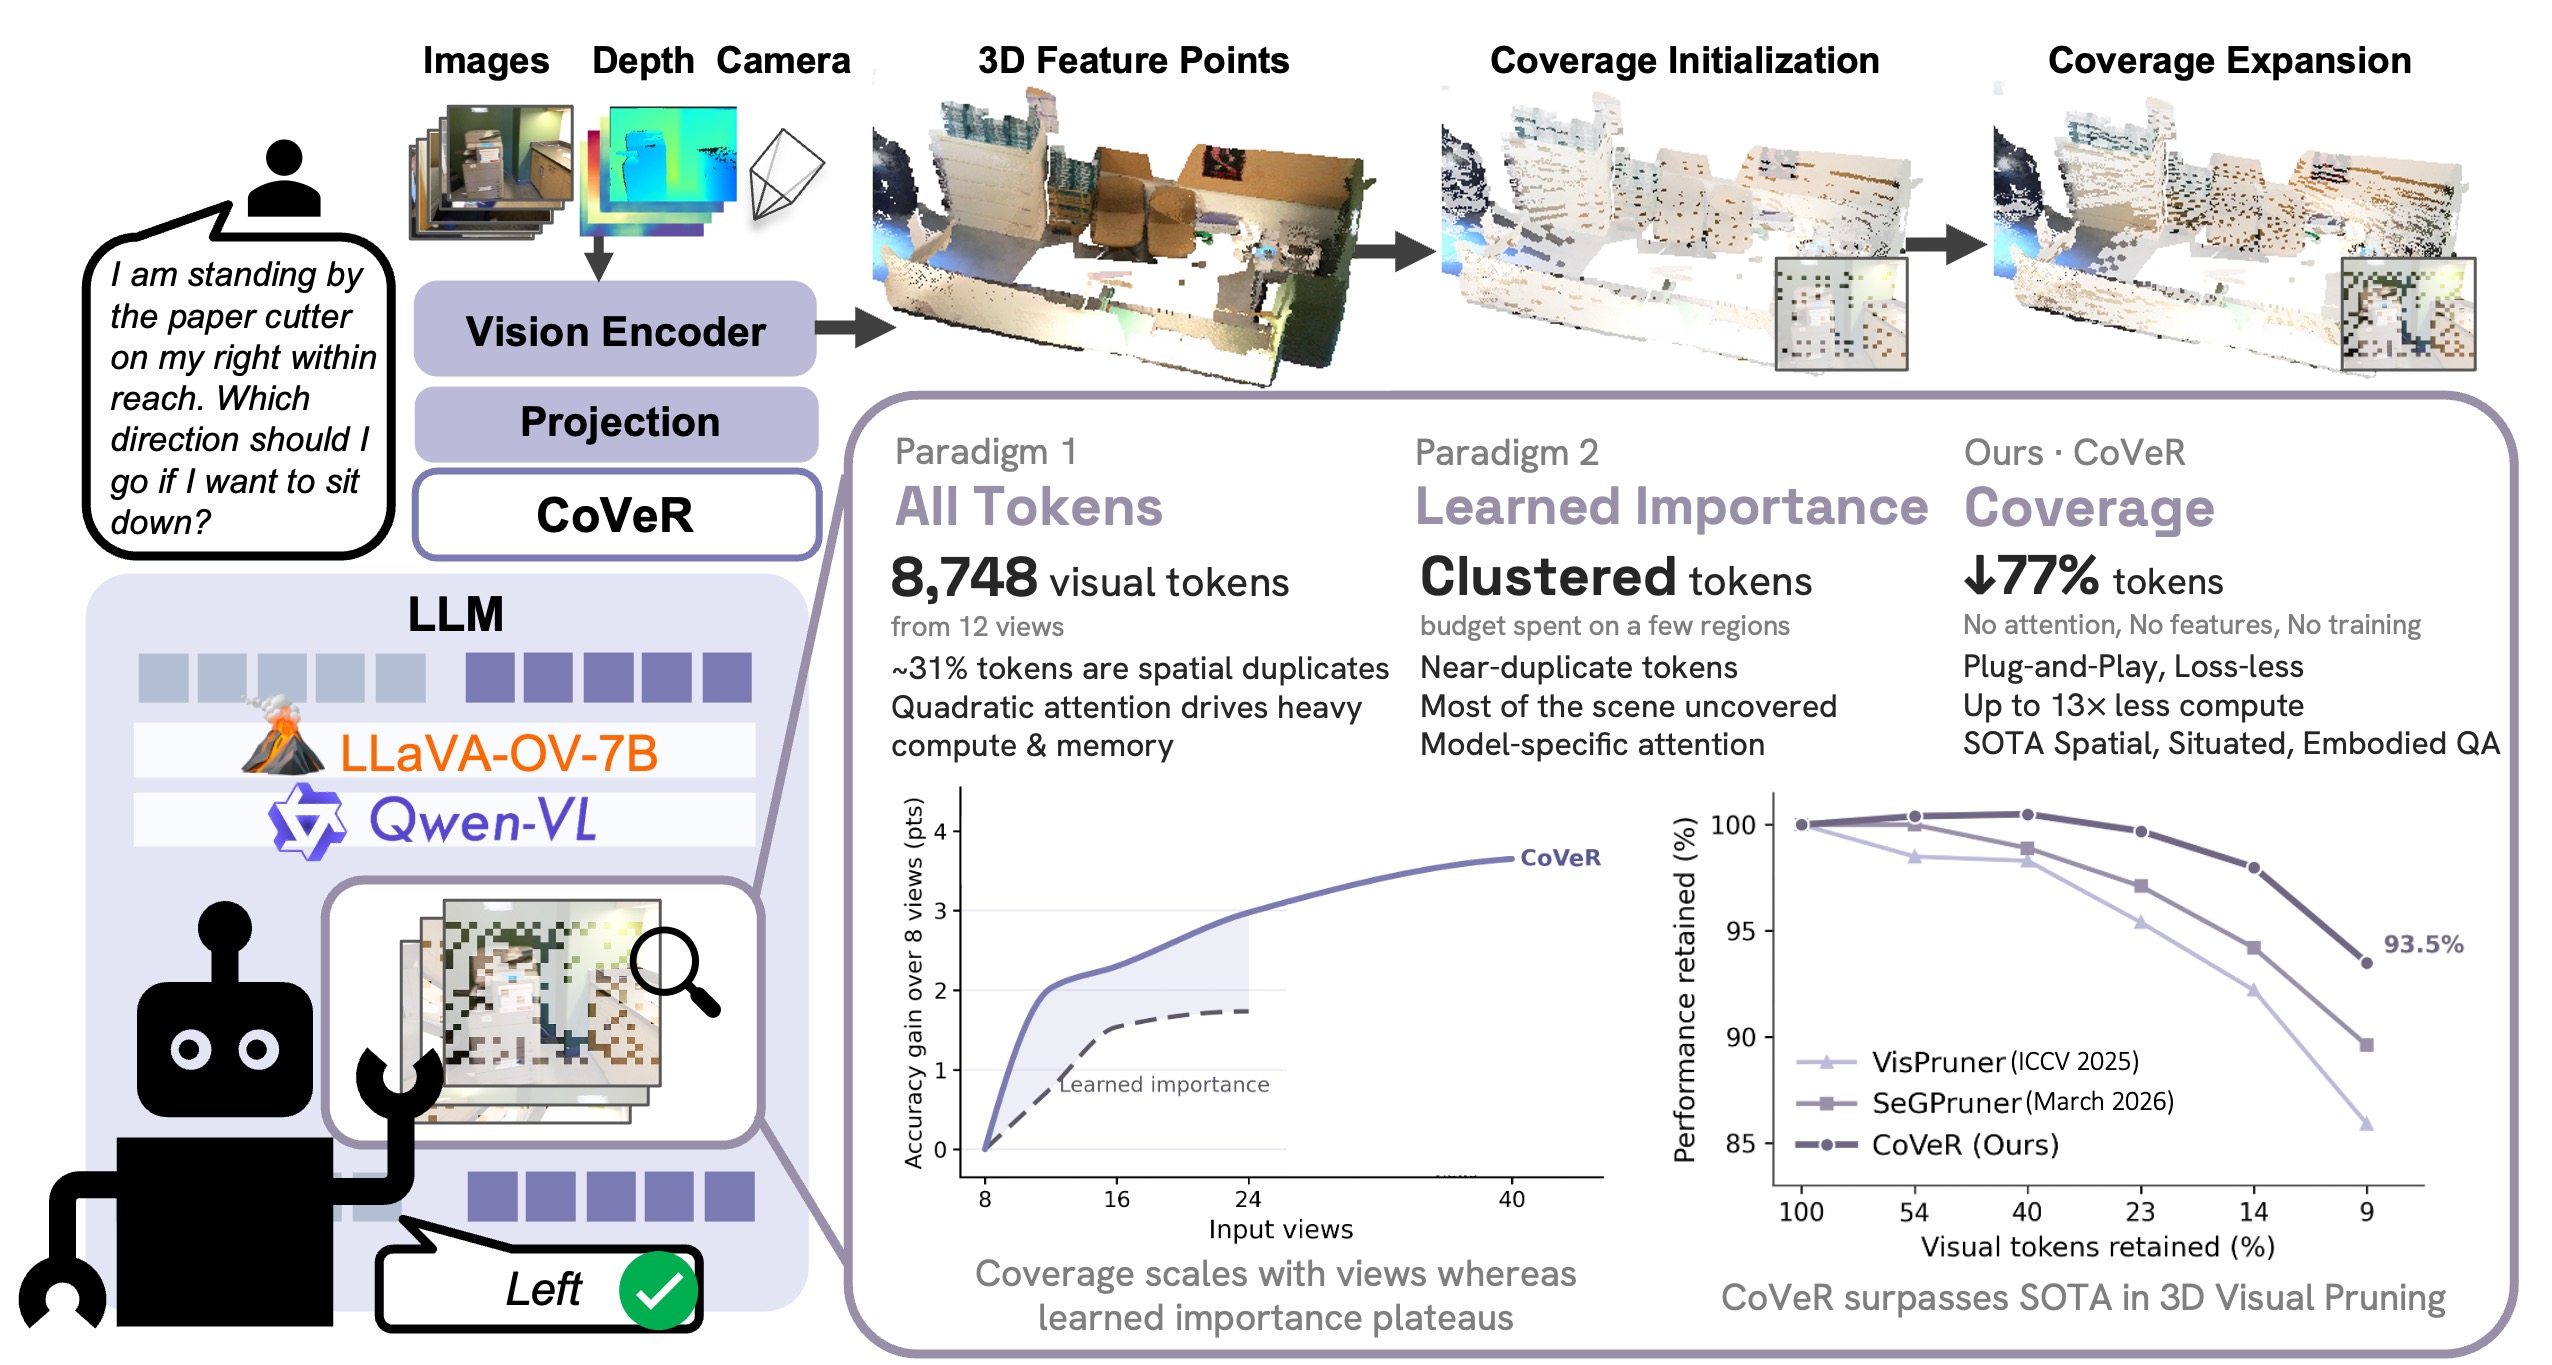
Figure 1 — CoVeR 프레임워크 개요
성능 평가 결과, CoVeR는 기존의 SOTA 모델들보다 압도적인 효율성과 성능을 보였습니다.
- ScanQA 벤치마크에서 14%의 토큰만 유지하고도 98.0%의 성능을 보존하며, 기존 방법론 대비 평균 3.9%p 이상의 성능 우위를 기록했습니다 [Table 2].
- 또한 9%의 극단적인 토큰 예산에서도 13.3× 낮은 LLM TFLOPs와 10.7× 낮은 KV cache 메모리 사용량을 보이며, 동시에 높은 수준의 NND_100_ 점수(0.977)를 달성하여 더 나은 공간적 커버리지를 입증했습니다 [Table 3, Table 5].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 3D 추론을 위한 토큰 프루닝의 핵심 지표로 '기하학적 커버리지'를 정의하고 이를 최적화하는 CoVeR 프레임워크를 성공적으로 구축했습니다. CoVeR는 모델 아키텍처에 독립적인(Model-agnostic) plug-and-play 모듈로서, 다양한 VLM(LLaVA-OV, Qwen 등)에서 즉각적인 성능 개선을 이끌어냈습니다 [Figure 5]. 이 연구는 복잡한 3D 장면을 다루는 자원 제한적인 환경에서 효율적인 VLM 배포를 가능하게 하며, 향후 로보틱스나 증강 현실과 같이 실시간 3D 환경 인식이 필수적인 분야에 중대한 기여를 할 것으로 기대됩니다.
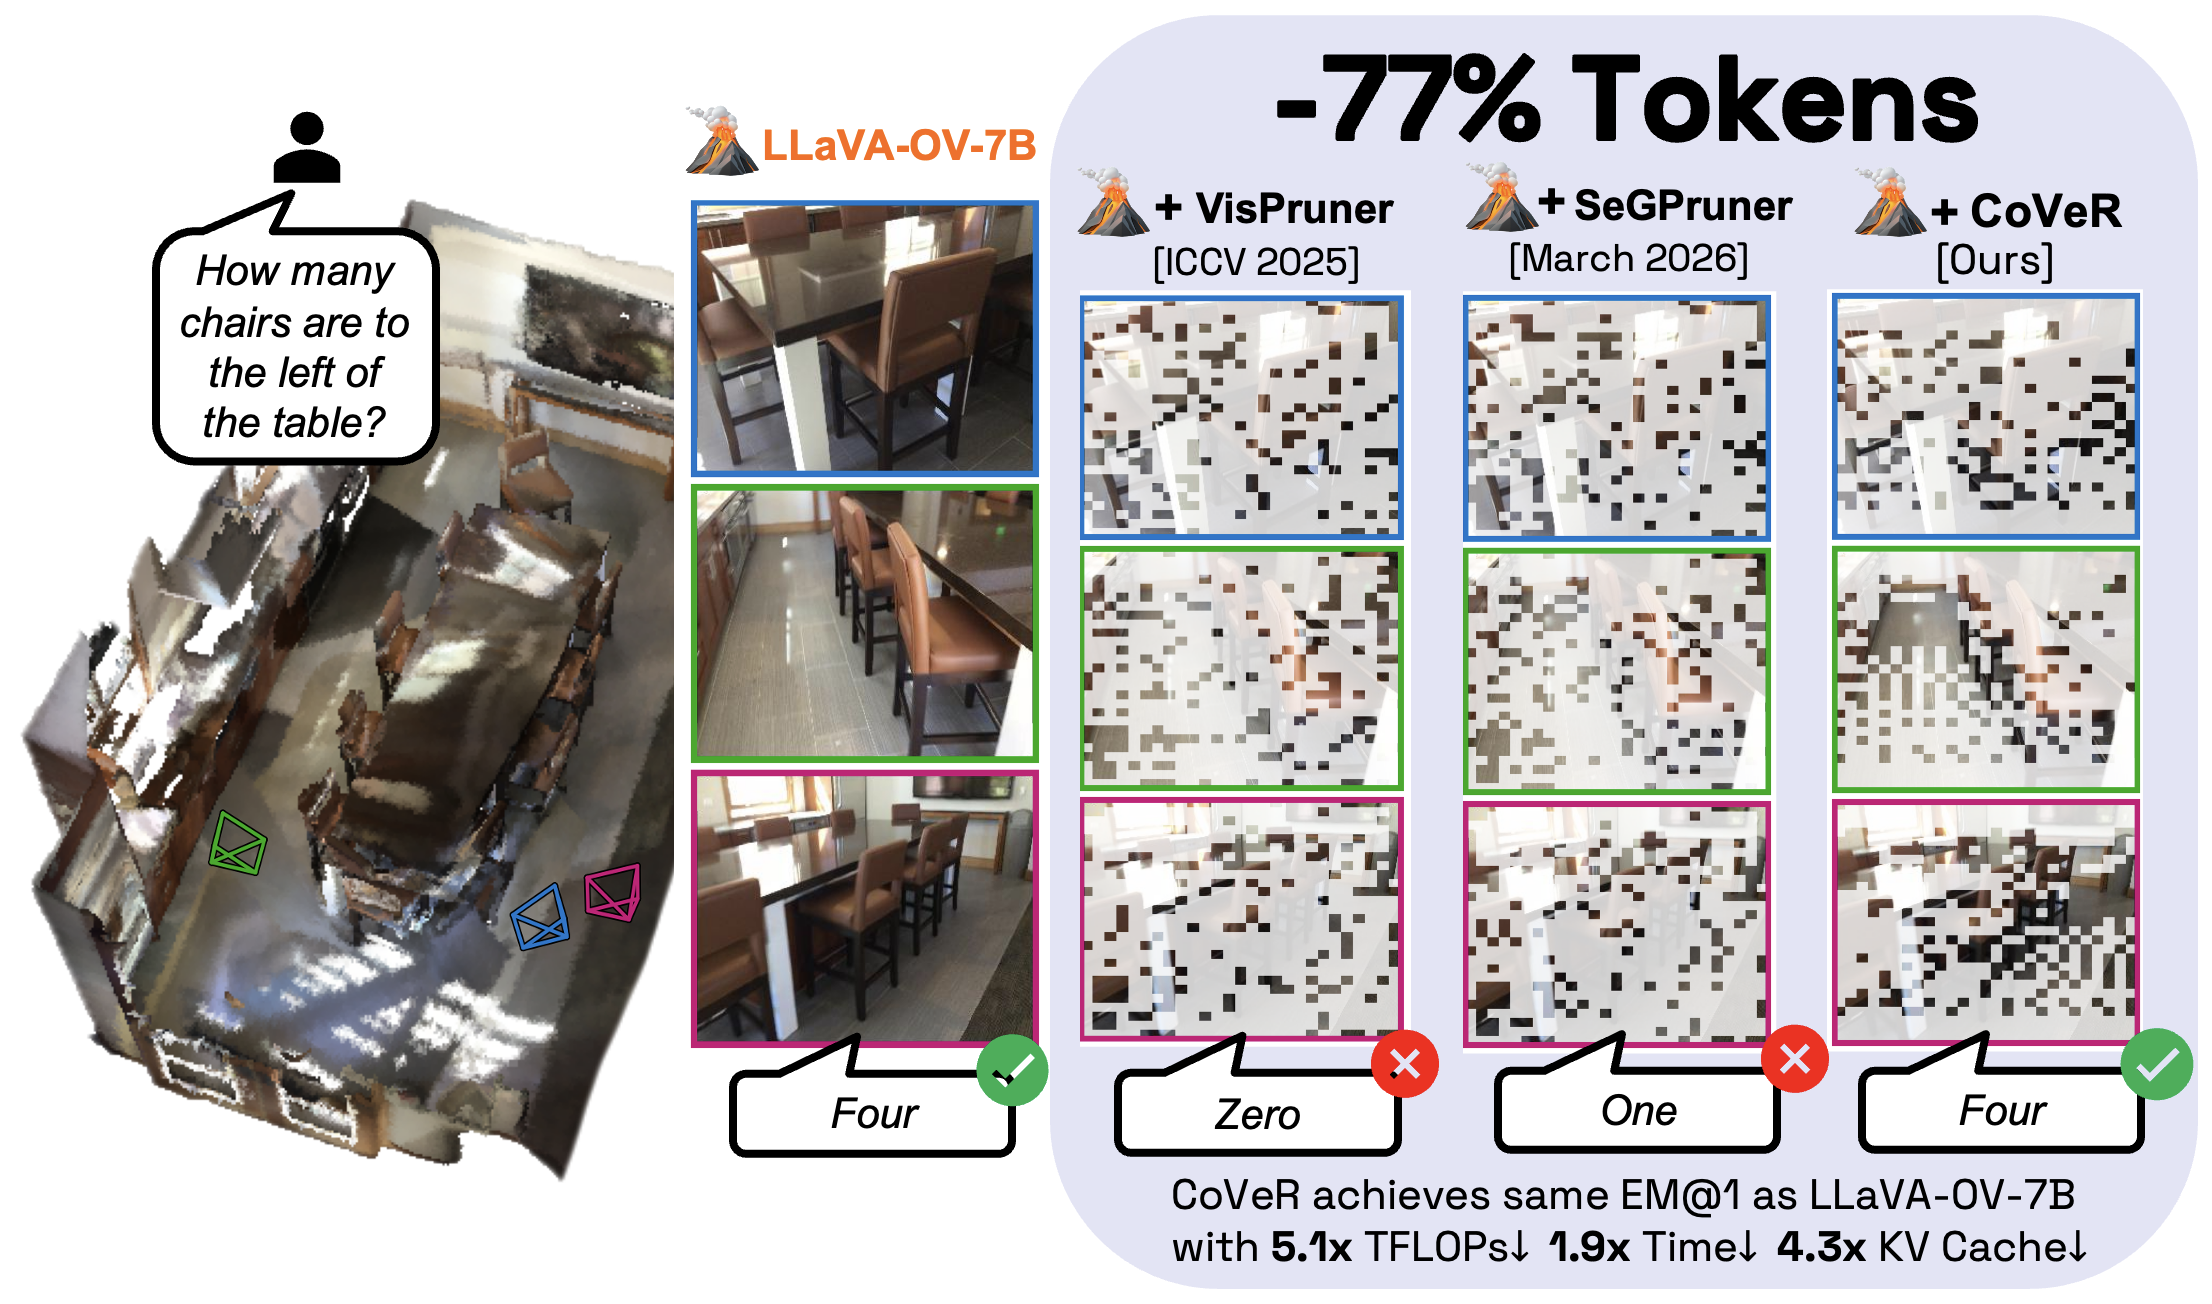
Figure 3 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing
- [논문리뷰] Learning Where Outcomes Change:Credit-Addressable Reasoning for Multimodal Geometry
- [논문리뷰] Weaving Visual Narratives: Agentic Image Bundle Composition Beyond Atomic Visual Matching
- [논문리뷰] EXIMO: VLM Guided Exploration of VLA Policies
- [논문리뷰] Embodied-Navigator: Point, Think, Memorize, and Align for Efficient Navigation
Review 의 다른글
- 이전글 [논문리뷰] Cadence: Error-Bounded Lossy Compression of Demand Time Series with a Time-Series Foundation Model
- 현재글 : [논문리뷰] CoVeR: Coverage-Based Token Pruning for Multi-View 3D Reasoning in VLMs
- 다음글 [논문리뷰] CosmoH2G: A Hand-to-Gripper Transfer Dataset and Baseline Method for Object Manipulation with Complex Spatial Movements
댓글