[논문리뷰] Harnessing CLIP and DINO: An Uncertainty-Aware Cascaded Fusion Network for Generalizable Deepfake Image Detection
링크: 논문 PDF로 바로 열기
저자: Xuechao Zou, Yi Zhou, Kai Li, Shun Zhang, Yuhui Chen, Congyan Lang, Junliang Xing
1. Key Terms & Definitions (핵심 용어 및 정의)
- CLIP (Contrastive Language-Image Pretraining): 텍스트와 이미지 간의 대조 학습을 통해 획득한 language-aligned semantic priors를 제공하는 Vision Foundation Model입니다.
- DINO (Distillation with no labels): self-supervised learning을 통해 이미지의 구조적 특징을 학습하여 시각적 구조 정보(visual-structure priors)를 제공하는 모델입니다.
- LEA (Layer-wise Expert Aggregation): Transformer의 다양한 Depth에서 추출된 계층적 특징을 입력 데이터에 따라 동적으로 결합하는 모듈입니다.
- UAF (Uncertainty-Aware Feature Fusion): 채널 응답의 엔트로피(Entropy)를 기반으로 각 encoder의 불확실성을 측정하여, 샘플별로 최적의 가중치를 할당하는 융합 메커니즘입니다.
- mAUC (Mean Area Under the Curve): 여러 데이터셋 및 실험 조건에서 모델의 탐지 성능을 평가하기 위한 평균 AUC 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Deepfake Detector들이 단일 Vision Foundation Model에 의존함에 따라 발생하는 특정 분포에 대한 과적합(Overfitting) 문제를 해결하고자 합니다. 기존 방법론들은 CLIP이나 DINO 중 하나만을 활용하여 해당 모델이 가진 특정 pretraining objective의 한계(blind spots)를 그대로 상속받는 경향이 있습니다. 결과적으로, 학습하지 않은 새로운 forgery 기법이나 데이터 분포에 대한 일반화(Generalization) 성능이 저하되는 문제가 발생합니다 [Figure 1]. 이러한 representational bias를 극복하기 위해서는 상호 보완적인 semantic priors와 visual-structure priors를 통합하는 새로운 접근 방식이 필수적입니다.
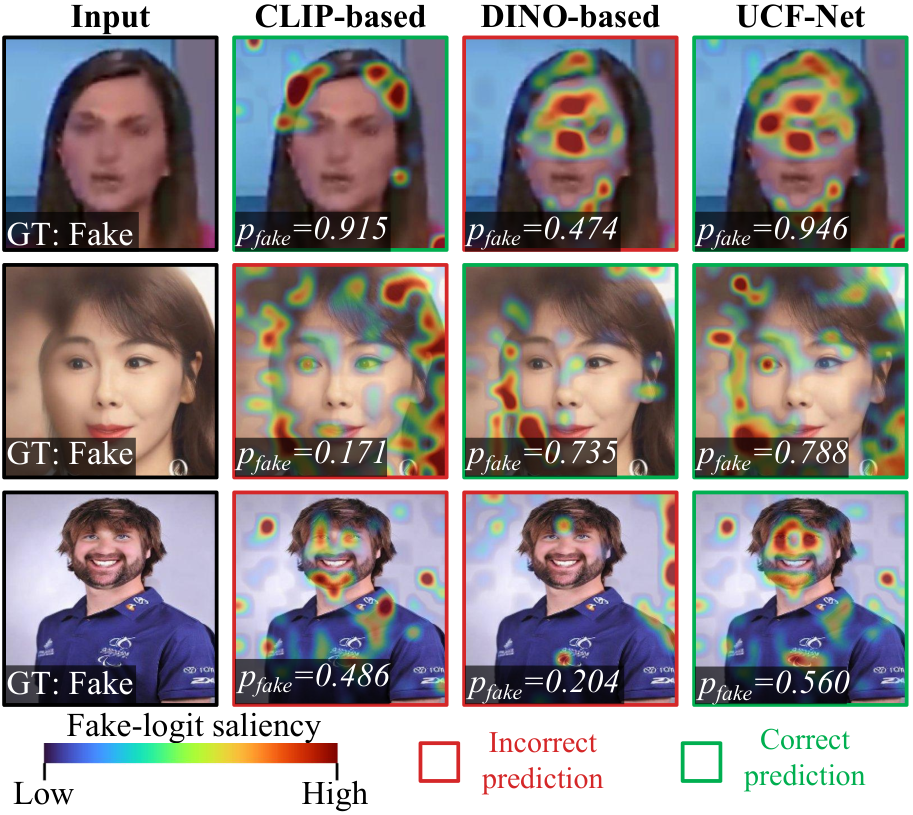
Figure 1 — CLIP과 DINO의 상호보완적 결합
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 CLIP과 DINO의 특징을 계층적으로 결합하고 불확실성에 기반하여 융합하는 UCF-Net을 제안합니다 [Figure 2]. UCF-Net은 먼저 LEA를 통해 각 encoder의 다층적 특징을 효율적으로 통합하며, 이후 각 branch의 신뢰도를 엔트로피 기반 불확실성으로 산출하여 샘플별로 가중치를 부여하는 UAF를 수행합니다. 모든 학습 가능한 컴포넌트에는 LoRA 어댑터를 적용하여 효율적인 파라미터 튜닝을 구현했습니다. 실험 결과, 통합된 4M 규모의 벤치마크에서 UCF-Net은 In-domain 평가에서 95.33의 mAUC를 기록하며 기존 SOTA 모델인 DFF-Adapter(94.86)를 능가했습니다 [Table 1]. 또한, Cross-domain 평가에서도 92.15의 mAUC를 달성하여 일반화 성능의 우위를 입증했습니다 [Table 2]. 특히 데이터 규모가 커질수록 기존 모델 대비 성능 격차가 더 벌어지는 강건함을 보였습니다 [Table 5].
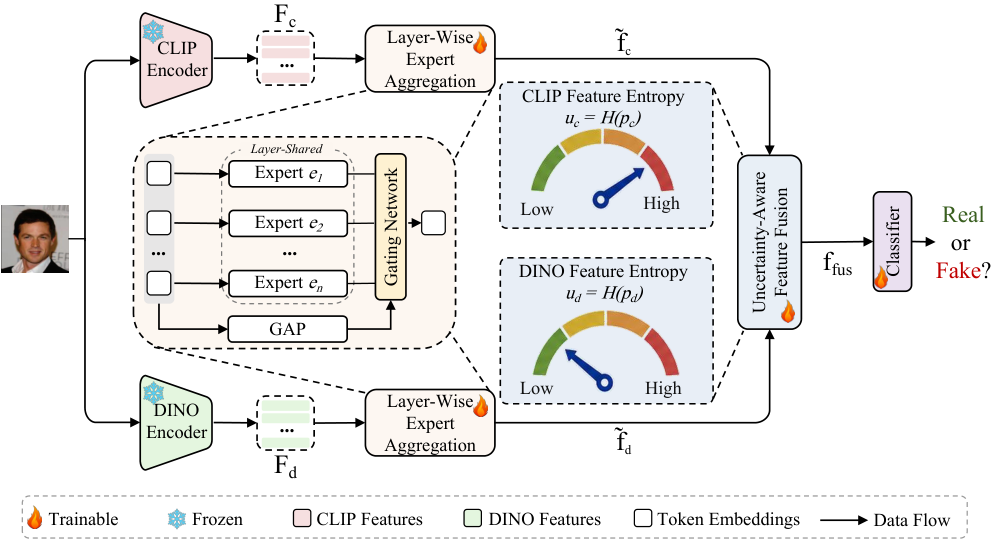
Figure 2 — UCF-Net의 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 연구는 서로 다른 pretraining 목적을 가진 CLIP과 DINO의 시너지를 활용하여 Deepfake 탐지 성능을 극대화하는 UCF-Net의 유효성을 입증했습니다. 제안된 계층적 집계 및 불확실성 기반 융합 전략은 Foundation Model 기반 탐지기들의 일반화 성능을 개선하는 핵심적인 방향을 제시합니다. 또한, 8개의 최신 생성 모델을 포함한 대규모 벤치마크 데이터셋은 향후 Deepfake 탐지 분야의 일반화 성능 연구를 위한 중요한 학술적 자산이 될 것으로 기대됩니다.
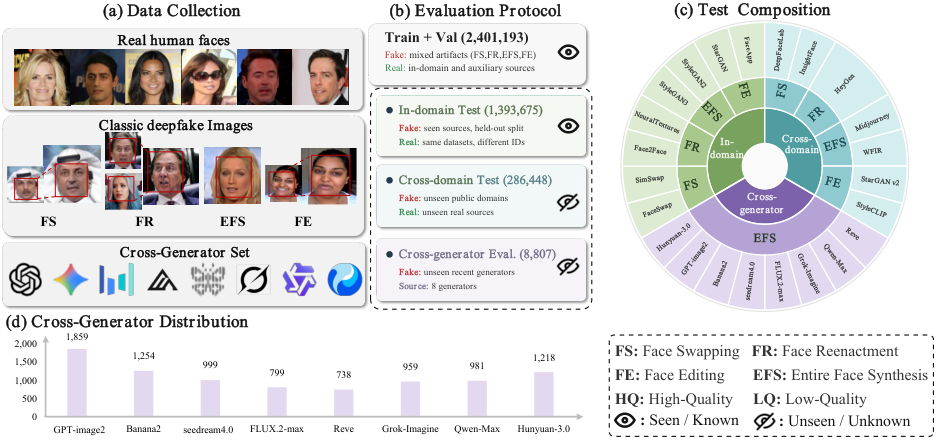
Figure 3 — 데이터셋 구성 및 벤치마크 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HDINO: A Concise and Efficient Open-Vocabulary Detector
- [논문리뷰] Hybrid-grained Feature Aggregation with Coarse-to-fine Language Guidance for Self-supervised Monocular Depth Estimation
- [논문리뷰] How Post-Training Shapes Biological Reasoning Models
- [논문리뷰] SciLT: Long-Tailed Classification in Scientific Image Domains
- [논문리뷰] VLANeXt: Recipes for Building Strong VLA Models
Review 의 다른글
- 이전글 [논문리뷰] GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
- 현재글 : [논문리뷰] Harnessing CLIP and DINO: An Uncertainty-Aware Cascaded Fusion Network for Generalizable Deepfake Image Detection
- 다음글 [논문리뷰] Kalman Delta Networks: Uncertainty-aware Associative Memory
댓글