[논문리뷰] AgenticGen: Reward-Guided Agentic Video Generation for Advertising
링크: 논문 PDF로 바로 열기
저자: Xingyuan Bu, Chengru Song, Hao Zhou, Tao Zhou, Dong Li, Wei Li, Shilong Li, Hao Shi, Yongxin Guo, Donghao Zhou, Qiangpeng Yang, Shilei Wen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- AGENTICGEN: 온라인 비즈니스 피드백에 따라 광고 비디오 생성을 최적화하기 위해 제안된 보상-guided agentic 프레임워크입니다.
- DPO (Direct Preference Optimization): 고정된 선호도 데이터를 사용하여 정책을 fine-tuning하는 오프-정책 강화 학습(Reinforcement Learning, RL) 방법론입니다.
- GRPO (Group-based Reinforcement Policy Optimization): 현재 정책에서 새로운 응답 그룹을 샘플링하고 자체 rollout 분포 하에서 정책을 최적화하는 온-정책 RL 방법론입니다.
- Impression-Balanced Delivery Pipeline: 온라인 비즈니스 피드백을 수집하기 위해, 동일한 delivery context 내에서 영상 간 노출(impressions)을 균형 있게 분배하여 상대적인 영상 품질을 직접적으로 비교할 수 있도록 설계된 시스템입니다.
- CTR (Click-Through Rate), CVR (Conversion Rate), Advv (Advertiser Value): AGENTICGEN의 성공을 측정하는 핵심 온라인 비즈니스 지표입니다. Advv는 attributed conversion의 총 advertiser-side 가치를 bid를 통해 측정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 광고 비디오 생성이 단순히 비디오 합성 task를 넘어, 온라인 비즈니스 metric에 의해 성공이 결정되는 제품-조건부 추론 문제임을 강조합니다. 기존 video foundation models는 텍스트, 이미지, 오디오 등 multimodal 조건을 통해 사실적인 클립을 생성할 수 있지만, 제품 재료를 효과적인 광고로 변환하는 방법이나 온라인 비즈니스 피드백을 통해 향후 생성을 개선하는 방법을 최적화하지 못합니다. 이러한 한계는 광고 시스템의 online business feedback으로부터 학습 가능한 reasoning process, 신뢰할 수 있는 reward signal, 그리고 누적된 피드백을 더 나은 생성 결정으로 변환하는 효율적인 메커니즘을 요구하며, 이는 reward-guided decision problem으로 전환될 필요가 있습니다. 직접적인 온라인 RL은 feedback이 시간 소모적이고(sufficiently long measurement period), 광고 시스템 편향 및 stochastic 사용자 행동으로 인해 signal이 noisy하여 어려움이 따르며, 이러한 loop를 닫는 학습 가능한 프레임워크를 구축하는 것이 핵심 과제입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 이러한 문제 해결을 위해 광고 비디오 생성을 전략 선택(strategy selection)과 초안 생성(draft generation)의 두 가지 학습 가능한 reasoning 단계로 분해하는 reward-guided agentic 프레임워크인 AGENTICGEN을 제안합니다 [Figure 1]. 전략 선택 단계에서는 Vision-Language Model (VLM)이 제품 context, material package, 그리고 validity constraints를 기반으로 사전에 정의된 전략 catalog에서 적합한 strategy group을 선택합니다. 초안 생성 단계에서는 선택된 strategy group을 video generation models 및 내부 rendering tools (예: Seedance 2.0, CapCut)가 실행할 수 있는 concrete executable content 및 parameter로 변환합니다.
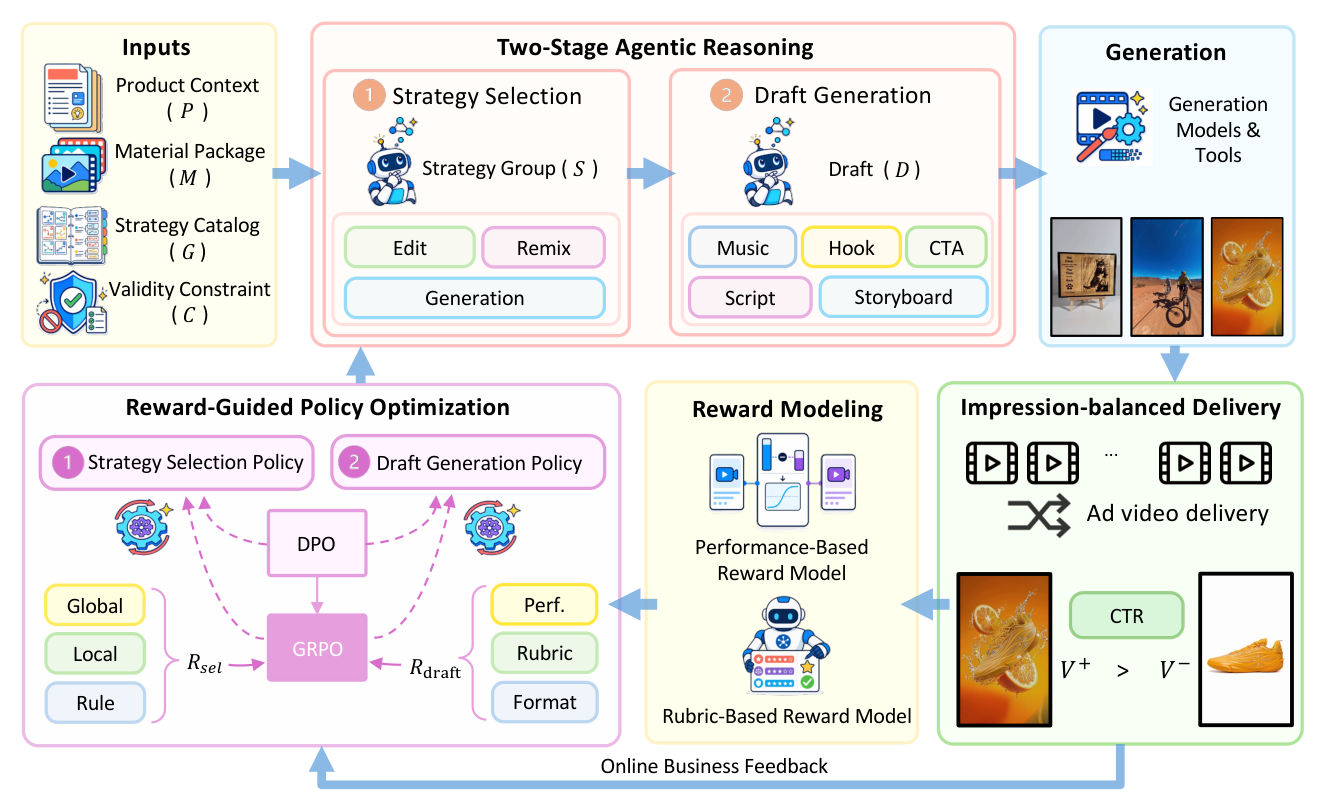
Figure 1 — AGENTICGEN 프레임워크의 전체 구조와 온라인 최적화 루프를 시각적으로 설명하는 핵심 다이어그램
reward model링을 위해, 두 가지 보상 신호를 구축합니다:
- Performance-Based Reward Model: Impression-Balanced Delivery Pipeline을 통해 수집된 누적 온라인 피드백으로부터 학습됩니다. 이 모델은 Bradley-Terry pairwise comparison objective를 사용하여 영상을 비교함으로써 confounder를 완화하고 더 신뢰할 수 있는 상대적 선호도를 학습하며, CTR prediction 정확도를 7.93% 개선하여 pointwise prediction 대비 60.85% 정확도를 달성했습니다 [Table 1]. 다양한 multimodal feature (video, audio, storyline, ad-specific)를 통합하여 accuracy를 56.55%에서 60.85%로 향상시켰습니다 [Table 2].
- Rubric-Based Reward Model: TikTok 도메인별 인간 품질 기준(video script, video content, video decoration, audio content의 네 가지 content dimension에 걸친 다섯 가지 quality aspect)에 맞춰 인간 라벨링된 데이터를 통해 훈련됩니다. SFT를 통해 Baseline 모델 대비 HL Acc.를 55.40%에서 69.50%로, IB Acc.를 49.20%에서 53.30%로 향상시켰습니다 [Table 3].
정책 최적화는 두 단계로 진행됩니다:
- DPO training phase: Impression-balanced pairwise preference data를 사용하여 strategy selection과 draft generation 정책을 온라인 선호도로 warm-up합니다. DPO는 SFT 대비 strategy selection accuracy를 49.72%에서 56.48%로, draft generation accuracy를 50.64%에서 58.34%로 각각 향상시켰습니다 [Table 4].
- GRPO training phase: strategy selection을 위한 process rewards (Global reward, Local reward, Rule-based indicator)와 draft generation을 위한 outcome rewards (Performance reward, Rubric reward, Format indicator)를 결합하여 온-정책 최적화를 수행합니다. GRPO의 Ablation study에서, performance reward와 rubric reward의 가중치 fusion은 DPO 대비 가장 높은 평균 win rate인 58.19%를 달성했으며, Performance win rate 60.52%, Rubric win rate 55.86%를 기록했습니다 [Table 5].
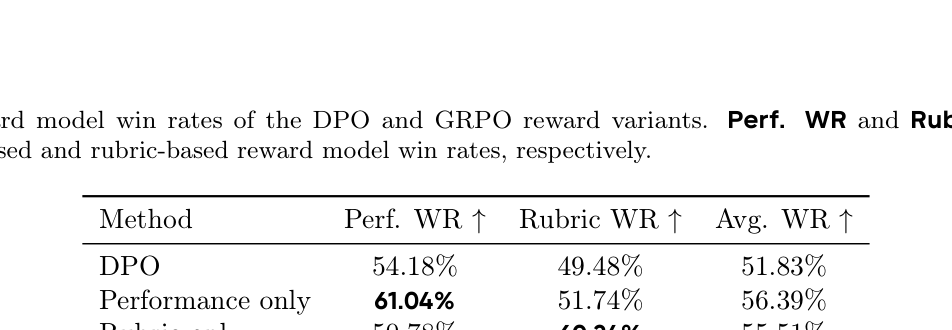
Table 5 — DPO 및 GRPO reward variants의 win rate를 비교하여 성능-기반 및 rubric-기반 보상 신호의 개별 및 결합 기여도를 보여주는 테이블
온라인 A/B 실험 결과, AGENTICGEN의 DPO 및 GRPO 최적화(RL)는 SFT Baseline 대비 CTR을 2.72%, CVR을 2.63%, Advv를 9.61% 향상시켰습니다 [Table 6]. 이는 온라인 비즈니스 피드백을 통한 학습이 click propensity뿐만 아니라 downstream conversion에도 긍정적인 영향을 미쳤음을 시사합니다.
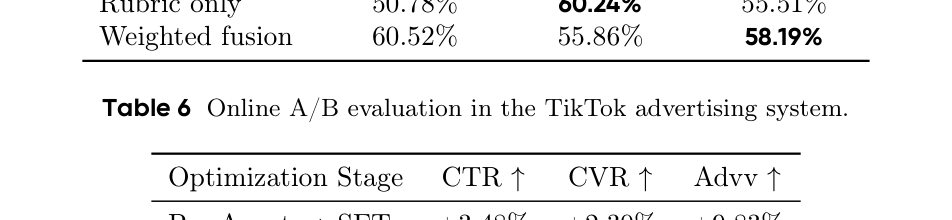
Table 6 — TikTok 광고 시스템에서의 온라인 A/B 테스트 결과를 요약하며, 제안된 AGENTICGEN 방법론의 실제 비즈니스 성능 향상을 정량적으로 보여주는 핵심 테이블
4. Conclusion & Impact (결론 및 시사점)
본 논문은 광고 비디오 생성을 온라인 비즈니스 성과 최적화를 위한 reward-guided agentic 프레임워크인 AGENTICGEN으로 성공적으로 재정의하고 구현했습니다. 이 프레임워크는 비디오 생성을 strategy selection과 draft generation의 두 가지 학습 가능한 reasoning 단계로 분해하며, impression-balanced delivery data로부터 학습된 performance-based reward model과 domain-specific human quality standards에 부합하는 rubric-based reward model을 활용합니다. DPO와 GRPO를 통해 두 reasoning 단계를 모두 개선했으며, TikTok 광고 시스템에서의 온라인 A/B 실험은 AGENTICGEN이 SFT baseline 대비 CTR 2.72%, CVR 2.63%, Advv 9.61%라는 유의미한 비즈니스 지표 향상을 가져왔음을 입증했습니다 [Table 6]. 이러한 결과는 온라인 비즈니스 피드백을 agentic video generation에 통합하는 reward-guided 학습의 효율성을 대규모로 검증하며, 학계에서는 RL 기반 agentic 시스템의 실제 적용 가능성과 효과를 보여주고, 산업계에서는 광고 콘텐츠 생성 및 최적화에 혁신적인 접근 방식을 제공하여 광고 효율성을 크게 개선할 수 있는 잠재력을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rubric-to-Code Credit Assignment for Reinforcement Learning
- [논문리뷰] V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
- [논문리뷰] On-policy Distillation with Verifiable Reward
- [논문리뷰] MBA: Multimodal Benchmark and Agents for Real-World Business Ideation
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
Review 의 다른글
- 이전글 [논문리뷰] AgentGrad: Intervention-guided Prompt Optimization for Multi Agent Systems
- 현재글 : [논문리뷰] AgenticGen: Reward-Guided Agentic Video Generation for Advertising
- 다음글 [논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
댓글