[논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
링크: 논문 PDF로 바로 열기
메타데이터
저자: Leilei Ding, Shumin Wang, Yuting Huang, Fanqi Wan, Yinmin Zhang, Qi Han, Yiming Xu, Feiyuan Zhang, Xiaomeng Chu, Guoliang You, Wuyang Zhang, Daxin Jiang, Yanyong Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Φ-Bench: LLM 기반 인프라 엔지니어링 능력을 평가하기 위해 제안된 벤치마크 프레임워크로, 커널 수준부터 시스템 수준까지 포괄하는 85개의 과제를 포함한다.
- KFC (Kernel Function Completion): 특정 함수나 연산자의 인터페이스와 입력-출력 사양 내에서 기능을 구현하거나 최적화하는 단기 과제 포맷이다.
- LHI (Long-Horizon Implementation): 리포지토리 수준에서 다중 파일을 수정하고, 복잡한 의존 관계를 탐색하며 구현 전략을 수립해야 하는 중기 과제 포맷이다.
- E2EO (End-to-End Optimization): 시스템 수준의 성능 목표를 달성하기 위해 병목 현상을 발견하고, 가설 기반의 전역적인 인프라 최적화를 수행하는 오픈엔드(Open-ended) 과제 포맷이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM이 스스로를 구동하는 인프라를 엔지니어링하고 최적화할 수 있는지 평가하는 것을 핵심 목표로 한다. 기존 벤치마크들은 주로 고립된 커널이나 사전 정의된 연산자 구현에 초점을 맞추고 있어, 실제 환경에서 필요한 복잡한 시스템 탐색, 디버깅, 그리고 반복적인 최적화 과정을 평가하는 데 한계가 있다 [Figure 1]. 이러한 현실적인 제약으로 인해 LLM 에이전트가 긴 호흡의 오픈엔드 엔지니어링 문제를 해결하는 능력을 체계적으로 측정할 필요가 있다.
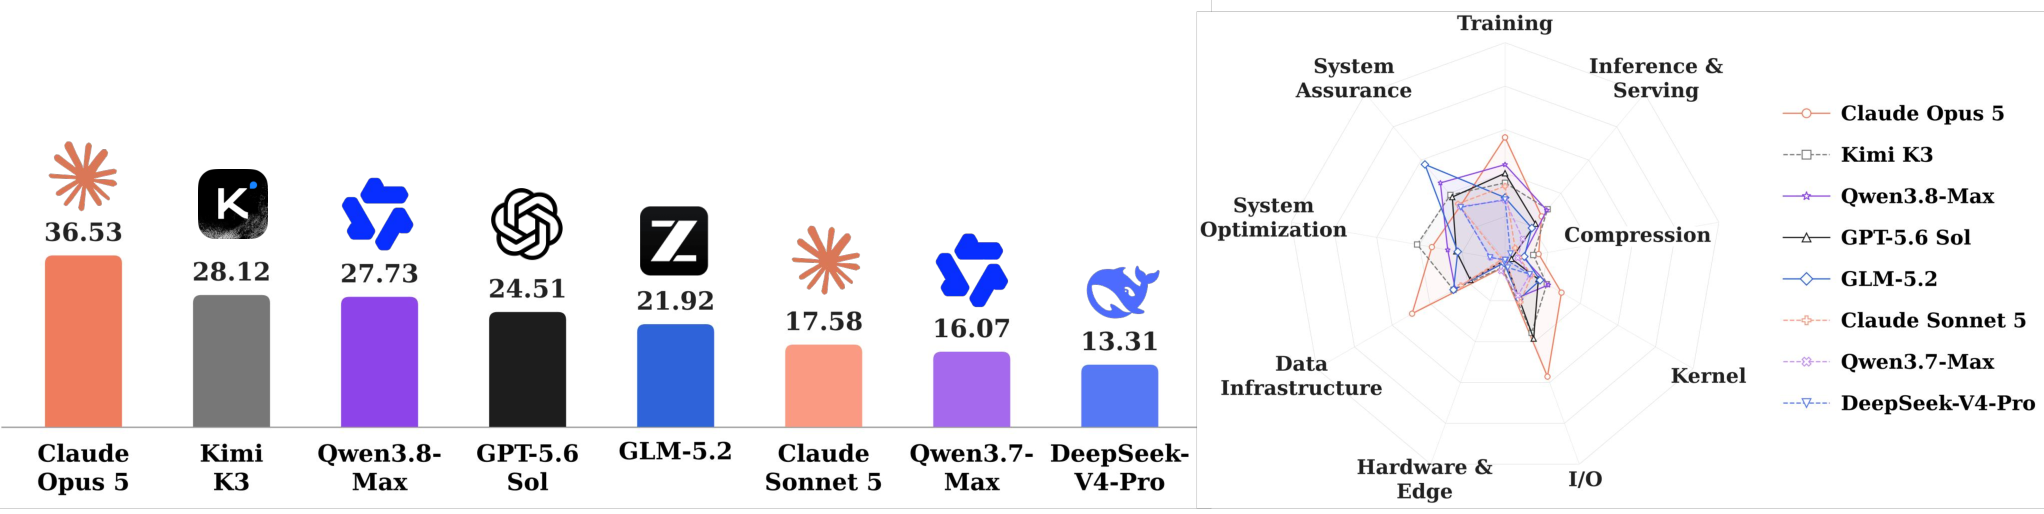
Figure 1 — 모델별 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 학술 논문과 GitHub 리포지토리 아티팩트에서 추출한 4,112개의 소스를 바탕으로 LLM 인프라 엔지니어링에 대한 계층적 분류 체계(Taxonomy)를 구축하고, 이를 가이드 삼아 85개의 태스크를 생성하는 파이프라인을 제안한다 [Figure 2, Figure 3]. 제안하는 평가 프레임워크는 KFC, LHI, E2EO의 세 가지 포맷으로 구성되어 점진적으로 증가하는 복잡도와 자율성을 평가한다 [Table 1]. 성능 평가는 시스템의 효율성 지표인 Performance Metric과 기능적 정확성을 평가하는 Implementation Metric을 사용하며, 엄격한 Cheating Detection 로직을 적용한다. 실험 결과, 최상위 모델인 Claude Opus 5가 전체 36.53%의 스코어를 기록하며 가장 우수한 성능을 보였으나, 여전히 전체 모델들의 성능에는 상당한 개선의 여지가 존재함을 확인하였다 [Table 2]. 특히, Hardware & Edge와 같은 특정 도메인에서는 최고 성능이 5.4%에 불과하여 현재 모델들의 인프라 이해도가 낮음을 시사한다. 또한, 반복적인 시행착오(Refinement)와 적절한 추론 예산(Reasoning Budget) 할당이 성능 향상에 결정적인 기여를 함을 입증하였다 [Figure 5, Figure 6].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 LLM 기반 인프라 엔지니어링의 현주소를 평가하는 포괄적인 벤치마크 Φ-Bench를 제시하며, 자동화된 시스템 최적화를 향한 로드맵을 제공한다. 연구 결과는 현재의 최첨단 LLM들이 파이썬 기반의 코드 생성 능력은 탁월하지만, 하드웨어 특수성을 고려한 최적화나 복잡한 리포지토리 수준의 디버깅에서는 여전히 취약함을 드러낸다. 이 연구는 향후 더 높은 자율성을 갖춘 AI 엔지니어링 에이전트를 개발하기 위해 모델이 단순히 코드를 완성하는 수준을 넘어, 가설을 설정하고 검증하며 시스템의 성능을 반복적으로 개선하는 고도의 인지적 능력을 배양해야 함을 시사한다.
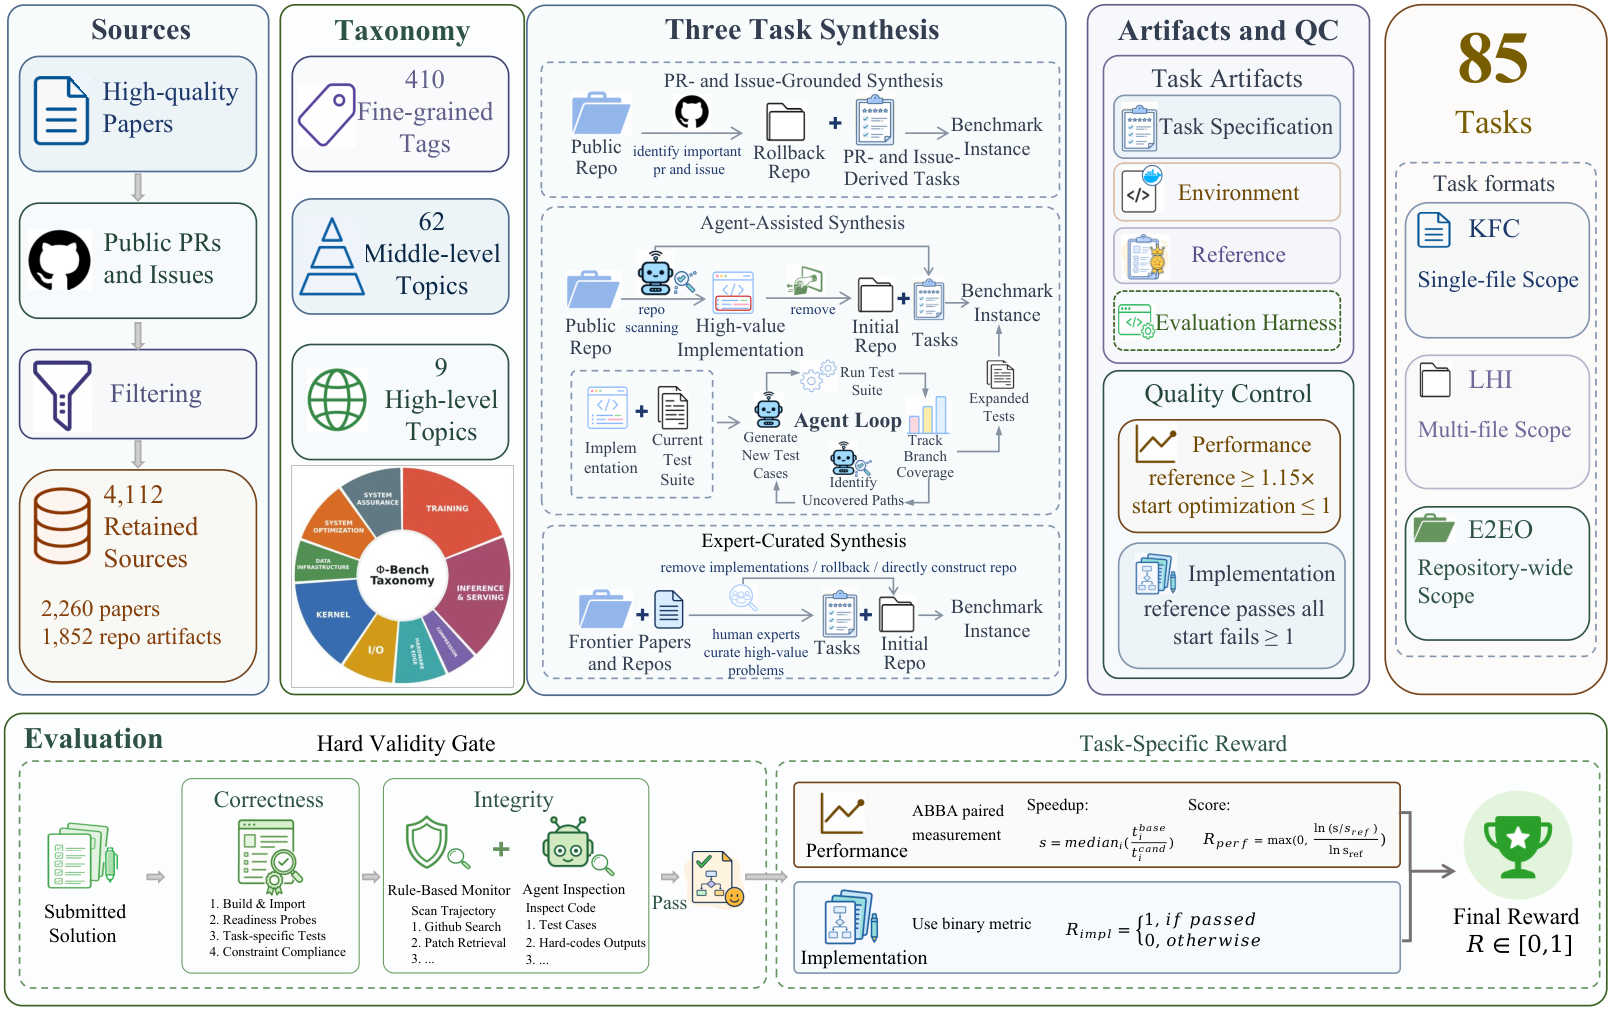
Figure 2 — 태스크 생성 파이프라인
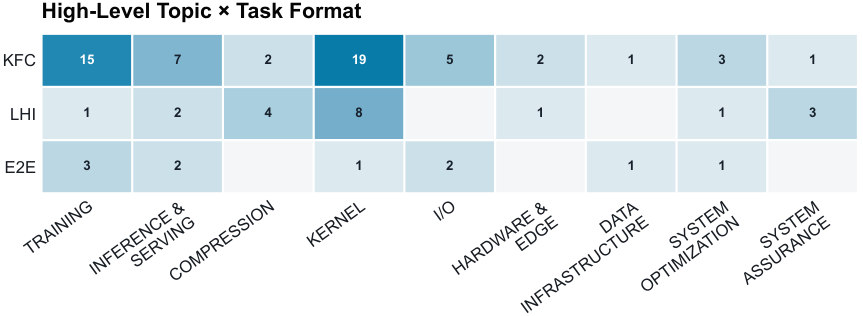
Figure 3 — 인프라 분류 체계
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
- [논문리뷰] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
- [논문리뷰] Tencent WorkBuddy Bench: A Multi-Domain Coding-Agent Benchmark with Contamination-Resistant Task Construction
- [논문리뷰] JAMER: Project-Level Code Framework Dataset and Benchmark on Professional Game Engines
- [논문리뷰] SWE-CI: Evaluating Agent Capabilities in Maintaining Codebases via Continuous Integration
Review 의 다른글
- 이전글 [논문리뷰] AgenticGen: Reward-Guided Agentic Video Generation for Advertising
- 현재글 : [논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
- 다음글 [논문리뷰] Co-Evolving Harnesses and Models: On-Policy Correction Helps Weaker Models Catch Up Where Imitation Fails
댓글